Când un PDF nu încorporează un font, componenta HotPDF randează textul acela cu un font Windows instalat, ales de HPDFMapBaseFontToSystem: decodează numele /BaseFont, taie partea de stil, încearcă mai multe ortografii până când GDI confirmă că familia e instalată, măsoară lățimile lipsă ale standard 14 din fonturi metric-compatibile și convertește codurile pe un octet în Unicode înainte de desenare. Fiecare dintre acești pași există pentru că versiunea naivă eșua pe fișiere reale. Renderer-ul de pagini RenderLoadedPageToBitmap se descurcă bine cu programele încorporate; aceasta e povestea fonturilor care nu sunt deloc în fișier
De ce desenează GDI în tăcere fontul greșit pentru un font neîncorporat?
GDI nu raportează niciodată un font lipsă: dați-i lui CreateFontIndirect un nume de font pe care nu-l cunoaște și el alege în tăcere un înlocuitor, adesea un alt serif fără grosime bold. Renderer-ul timpuriu pasa numele PDF aproape întocmai, deci TimesNewRoman,Bold, TimesNewRomanPS-BoldMT și SegoeUI-Semibold nu se potriveau cu nimic și ieșeau în ce alegea GDI. Numele pot fi mai rele. ISO 32000-1 §7.3.5 lasă un nume să scrie orice octet ca #xx, iar producătorii CJK își ortografiau de rutină numele fonturilor ca octeți UTF-8 escape-ați sau de code page vechi; înainte de v2.766.69, escape-urile înseși deveneau numele fontului. HPDFMapBaseFontToSystem decodează acum întâi escape-urile, întoarce o secvență de octeți UTF-8 validă drept caracterele lui și citește orice alti octeți înalți în code page-ul de sistem
Tăierea stilului e acolo unde euristicile mușcă. O virgulă termină întotdeauna familia (Arial,Bold dă Arial), dar o cratimă o face doar când cuvântul de după e un stil: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra sau Condensed. Regula aceea îl lasă întreg pe MS-Mincho în timp ce transformă Calibri-Light în Calibri. HotPDF încearcă apoi ortografii ale familiei, urmate de ortografii ale familiei cu un sufix PSMT, MT sau PS eliminat. Din v2.768.18, ortografiile acelea acoperă fiecare alegere de spații în locurile în care poate începe un cuvânt: înaintea unei majuscule care urmează după o minusculă (MyriadPro devine Myriad Pro), la ultima majusculă a unei rulări după care urmează o minusculă (UIGothic) și după un MS de început (MSPGothic), de la forma complet spațiată până la numele ca atare; peste patru astfel de locuri se încearcă doar forma complet spațiată și numele lipit. Spațierea nu poate fi aplicată orbește, pentru că Windows ține unele cuvinte lipite: SimSun e instalat sub exact ortografia aceea, în timp ce MicrosoftYaHei, MicrosoftJhengHei și MSPGothic aparțin de Microsoft YaHei, Microsoft JhengHei și MS PGothic. Înainte de v2.768.18, mapper-ul punea un spațiu înaintea fiecărei majuscule interioare, deci MicrosoftYaHei era căutat ca Microsoft Ya Hei și nu era găsit niciodată. Un candidat contează ca instalat când CreateFontIndirect urmat de GetTextFace întoarce numele cerut sau, din v2.768.18, când tabelul name al fontului selectat îl listează ca familie, nume de familie complet sau tipografic în orice limbă; răspunsul e pus în cache per nume, deci documentele cu multe fonturi care nu sunt instalate nu mai sondează Windows pentru fiecare nume pe fiecare pagină
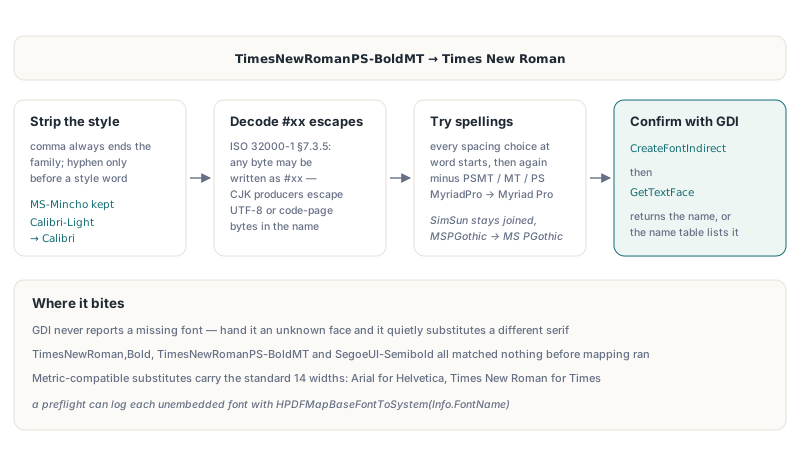
Fiindcă funcția de mapare e publică în unitatea HPDFRenderFontMetrics, un raport de preflight poate arăta cu ce familie instalată se va randă fiecare font neîncorporat, folosind enumerarea de fonturi pe care THotPDF o expune deja pentru documentele încărcate:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
Cum măsoară HotPDF fonturile standard 14 care n-au /Widths?
HotPDF măsoară avansurile lipsă pe fontul instalat cu aceleași metrici, pentru că ISO 32000-1 §9.6.2.2 permite fonturilor standard 14 să omită /Widths, iar biblioteca nu livrează tabele AFM. Arial cară metricile Helvetica, Times New Roman cară Times, iar Courier New cară Courier, deci HPDFMeasureBaseFontWidths creează fontul pereche la lfHeight = -1000 și apelează GetCharWidth32W; la înălțimea aceea rezultatul e deja în unitățile de 1/1000 em pe care le folosesc lățimile PDF. Renderer-ul transformă întâi fiecare cod în Unicode prin /Encoding, /BaseEncoding și /Differences, cu implicit StandardEncoding. Exportul SVG și extragerea de text loveau încă o capcană: un font Type 1 standard fără niciun /Encoding producea un decoder fără informație de codare, exportul SVG nu-l înregistra niciodată, iar fiecare lățime măsurată rămânea nefolosită. Furnizarea StandardEncoding-ului implicit a reparat-o, cu condiția să fie marcat ca codare predefinită; trimisul pe calea numelui de CMap decoda fiecare cod ca 0, iar toate lățimile îl urmau
Bold, italic și o greșeală cu unul în flag-urile descriptorului de font
Intrarea /Flags a unui descriptor de font își numără biții de la 1, nu de la 0, deci ForceBold e bitul 19 ($40000) și Italic e bitul 7 ($40), conform ISO 32000-1 Tabelul 123. Codul vechi testa $20000, adică bitul 18, SmallCap. Greșeala a supraviețuit de la v2.345.0 la v2.766.53 pentru că /FontDescriptor e aproape întotdeauna o referință indirectă, iar constructorul de fonturi citea doar obiecte directe, deci toată ramura de flag-uri nu rula niciodată, și aceeași orbire ignora /Widths 12 0 R și așeza textul cu un avans de rezervă de 500 de unități. Odată ce v2.766.53 a început să rezolve referințele indirecte prin renderer, bitul a trebuit corectat în aceeași schimbare, altfel fiecare font cu versalități mici ar fi apărut deodată bold:
const
  // ISO 32000-1 Tabelul 123 numără pozițiile de biți de la 1
  FD_ITALIC     = $00040;  // bitul 7
  FD_SMALLCAP   = $20000;  // bitul 18, nu o grosime
  FD_FORCEBOLD  = $40000;  // bitul 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;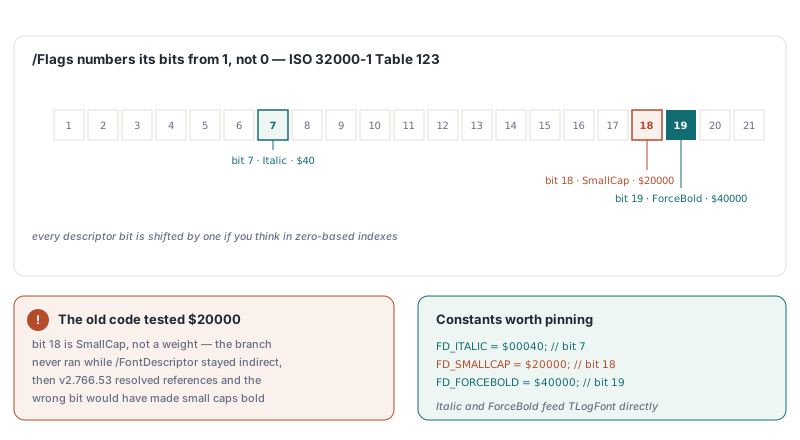
De ce fonturile CJK cu CMap UCS2 primesc lățimile greșite?
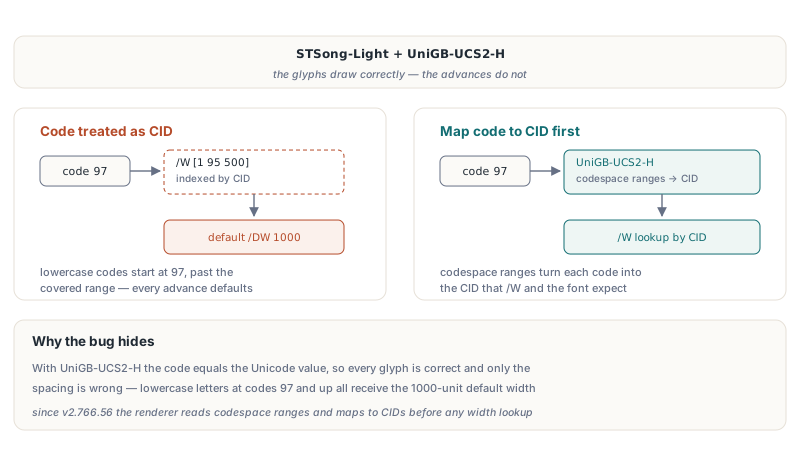
Textul CJK cu un CMap UCS2 predefinit desenează glyph-urile corecte, dar spațierea greșită, când un renderer tratează codul drept CID, pentru că /W e indexat după CID, nu după codul de caracter. Cu STSong-Light și UniGB-UCS2-H, codul se întâmplă să egaleze valoarea Unicode, deci GDI desenează caracterele corecte, iar bug-ul se ascunde în avansuri: literele mici sosesc ca coduri 97 și peste, cad în afara unei intrări /W precum [1 95 500] și primesc cu toții lățimea implicită /DW de 1000. Din v2.766.56, renderer-ul HotPDF citește codurile prin intervalele codespace ale CMap-ului (ISO 32000-1 §9.7.6.2) și le mapează la CID-uri înainte de căutarea lățimilor. Sunt folosite doar tabelele UCS2 și UTF16 built-in și stream-urile CMap încorporate; o aproximare de identitate pentru ceva precum GBK-EUC-H ar doar părea suportat producând output greșit, deci renderer-ul nu se preface
De ce caracterele cu diacritice devin semne de întrebare pe Windows chinezesc?
Codurile pe un octet nu trebuie să ajungă niciodată la funcțiile GDI ANSI („A”), pentru că GetGlyphOutlineA și GetGlyphIndicesA interpretează octeții în code page-ul de sistem, în timp ce TextOutA folosește setul de caractere al fontului selectat. Pe un sistem chinezesc, octetul $A9 al lui Arial (semnul de copyright din Windows-1252) devenea octet de început GBK și se randă ca „?”, o capcană în care calea de contur fără hinting adăugată în v2.766.83 a căzut cu capul înainte. v2.767.3 întreabă fontul realizat după setul lui de caractere cu GetTextCharset, convertește acela în code page prin TranslateCharsetInfo, trece octetul prin MultiByteToWideChar și apelează funcțiile W; fonturile simbol folosesc U+F000 plus codul în schimb. Codările care nu se potrivesc cu Windows-1252 — /Differences, StandardEncoding, MacRomanEncoding — sunt mapate la Unicode înainte ca orice font de sistem să le vadă
Care sunt limitele desenării cu fonturi de sistem?
Randarea cu fonturi de sistem e o aproximație, iar componenta HotPDF e cinstită în privința locului unde se oprește. Înainte de v2.768.18, verificarea de instalare compara doar numele pe care îl întoarce GetTextFace, iar pe Windows localizat funcția aceea raportează numele familiei în limba sistemului, deci Microsoft YaHei pe Windows chinezesc sau Yu Mincho pe Windows japonez erau judecați lipsă și desenați cu un înlocuitor GDI; din v2.768.18, un font care revine sub alt nume e căutat și în tabelul name al fontului, iar asemenea fonturi sunt găsite. Compatibilitatea metrică e garantată doar pentru familiile Helvetica, Times și Courier; Symbol se mapează pe Symbol, iar ZapfDingbats pe Wingdings, ceea ce e un pod provizoriu, nu o potrivire. Preflight-ul de mai sus vede de asemenea doar fonturile din dicționarul /Resources al fiecărei pagini, nu și cele referențiate din interiorul Form XObjects. Când un cod tot nu poate fi desenat, urmărirea glyph-urilor nerezolvate la desenare îl raportează, semnal mai bun decât privitul de miniaturi
Repararea durabilă stă de partea autorării. HotPDF însuși scrie cu FontEmbedding setat pe True din fabrică, substituind un Arial încorporat chiar și când codul apelează SetFont cu Helvetica, iar textul încorporat trece prin renderer-ul de glyph-uri de fonturi încorporate în locul oricăror ghiciri de mai sus. O gardă ieftină pentru fișierele care sosesc e să avertizați înainte de randare când o familie mapată nu e în lista de fonturi de ecran:
// VCL: Screen.Fonts listează numele familiilor instalate (unitatea Forms)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
Pentru componenta completă, cu randare de pagini, extragere de text și subsetting de fonturi pe partea de scriere, vedeți componenta HotPDF Delphi PDF, pagina de produs