PDF Library for Delphi (PDFlibPas) emite JSON valid pentru fiecare număr PDF din v3.539.31. GetObjectJSON rescrie token-uri pe care ISO 32000-1 îi acceptă, dar RFC 8259 îi respinge, precum -.25, +1.5 și 007.5, în -0.25, 1.5 și 7.5 cifră cu cifră; GetDocumentJSON și rapoartele de analiză scriu null pentru NaN și Infinity; iar PLDoubleToStr scrie 0 pentru NaN în loc să ridice EInvalidOp la jumătatea unui export. Înainte de corecție, biblioteca putea produce JSON pe care propriul ei cititor refuza să-l încarce înapoi
De ce un număr PDF valid sparge JSON?
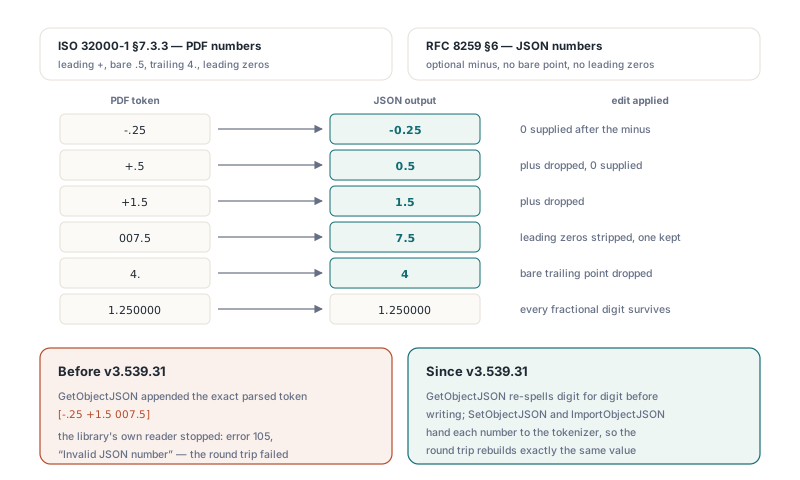
Pentru că cele două gramatici nu se pun de acord pe patru detalii mărunte, iar un parser PDF care respectă textul sursă le cară pe toate direct în output. ISO 32000-1 §7.3.3 lasă un număr să pornească cu semn plus, să omită partea întreagă (.5), să se termine pe un punct gol (4.) și să poarte zerouri în față (007.5). RFC 8259 §6 nu lasă niciuna: un minus opțional, o parte întreagă care fie e 0, fie pornește cu 1 până la 9, și cel puțin o cifră după orice punct zecimal. Producătorii sunt liberi să scrie formele PDF, și nenumărate generatoare și fișiere editate de mână o fac
Scurgerea a venit dintr-o funcție de precizie deliberată. Din v3.539.19, TPDFNumeric.Output întoarce textul exact pe care tokenizer-ul l-a parsat pentru numerele reale, ceea ce ține o valoare de culoare calibrată exactă la salvare, cum descrie păstrarea preciziei zecimale PDF parsate. Tokenizer-ul corecta deja .5 în 0.5 și 4. în 4.0 la intrare, iar întregii se reformatează din valoarea lor, deci +3 revine ca 3. Ce supraviețuiește întocmai e restul: un punct semnat în față (-.25), un plus explicit la un real (+1.5) și zerouri în față (007.5). Vechiul scriitor de obiecte lipea Output imediat după "value":, iar TJSONParser.ParseNumber din propriul cititor al bibliotecii se oprea pe fiecare dintre ele cu „Invalid JSON number”, deci exportul reușea, iar re-importul eșua cu PDFLIB_ERROR_OBJECT_JSON_INVALID (105)
uses
  System.SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  JSON: AnsiString;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('legacy-drawing.pdf', '') = 0 then
      raise Exception.Create('load failed');

    // Obiectul 12 e un tablou scris ca [-.25 +1.5 007.5]
    JSON := Lib.GetObjectJSON(12, 0);
    // v3.539.31 și mai nou: valorile sosesc ca -0.25, 1.5 și 7.5

    // SetObjectJSON nu acceptă opțiuni, deci pasați 0
    if Lib.SetObjectJSON(12, JSON, 0) = 0 then
      raise Exception.CreateFmt('round trip rejected, error %d',
        [Lib.LastErrorCode]);

    Lib.SaveToFile('legacy-drawing-roundtrip.pdf');
  finally
    Lib.Free;
  end;
end;
Cum păstrează PDFNumberTextToJSON fiecare cifră?
PDFNumberTextToJSON re-ortografiază token-ul în loc să-l recalculeze dintr-un Double. Funcția din PDFlibObjectJSON citește un semn opțional, culege cifrele dinaintea și de după un singur punct zecimal, apoi aplică doar editările pe care JSON le cere: aruncă un plus, taie zerourile din față păstrând unul, furnizează 0 când partea întreagă e goală, aruncă un punct de la coadă rămas singur și pune la loc minusul. Un token care conține orice alt caracter, sau deloc cifre, cade pe PLJSONNumber(Value, 10), care scrie null când valoarea nu e finită
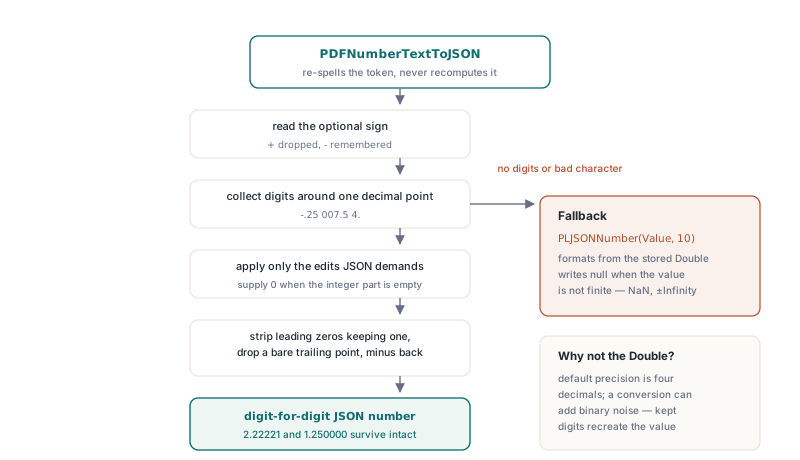
-.25devine-0.25, iar+.5devine0.5+1.5devine1.5007.5devine7.5, în timp ce0.75rămâne cum e4.devine4dacă un asemenea token ajunge vreodată la scriitor2.22221și1.250000păstrează fiecare cifră fracționară, zerourile de la coadă incluse
Formatarea din Double-ul stocat ar fi fost mai scurtă și greșită, din același motiv pentru care există corecția de precizie: precizia implicită de output e de patru zecimale, și chiar o conversie cu precizie deplină poate adăuga zgomot binar unui literal zecimal. Păstrarea cifrelor înseamnă că SetObjectJSON și ImportObjectJSON, care dau textul fiecărui număr JSON tokenizer-ului PDF, recreează exact aceeași valoare. Garanția acoperă valoarea, nu octeții: după un re-import, -.25 e stocat și salvat ca -0.25. Ambele ortografii sunt egale sub §7.3.3, dar un diff la nivel de octeți va semnala schimbarea, deci nu tratați un ciclu de export și import ca un no-op pe un document ale cărui octeți sunt acoperite de o semnătură
Ce se întâmplă cu un număr pe care JSON nu-l poate reprezenta?
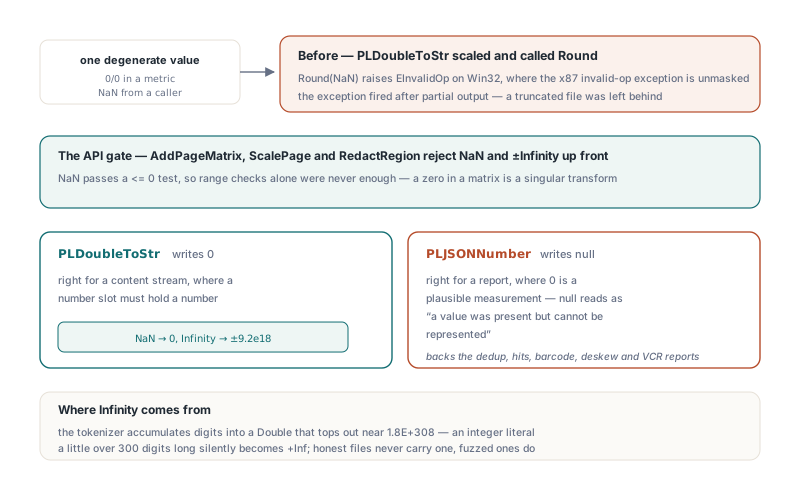
GetDocumentJSON scrie acum null pentru orice număr care e NaN sau infinit, pentru că RFC 8259 §6 n-are sintaxă pentru niciunul. Infinity e mai ușor de produs decât sună: tokenizer-ul PDF acumulează cifrele prin înmulțiri repetate într-un Double, care se împlintește pe la 1,8 × 10308, deci un literal întreg de ceva peste 300 de cifre devine în tăcere +Inf. Fișierele cinstite nu conțin vreodată un asemenea literal; cele fuzzate și ostile da, de-asta aparțin aceluiași corpus de test ca și cazurile din întărirea unui parser PDF în Pascal împotriva fișierelor malitioase. Vechiul scriitor de documente formata non-întregii cu Str(D:0:6), iar pentru +Inf scria textul +Inf, pe care niciun consumator JSON nu-l va parsea
null-ul e pierzător din intenție. Consumatorii output-ului GetDocumentJSON trebuie să accepte null oriunde poate apărea un număr și ar trebui să-l citească ca „o valoare era prezentă, dar nu poate fi reprezentată”, nu ca o cheie lipsă. Literalul original nu e recuperabil din documentul JSON, deci un pipeline care ține la asta ar trebui să logheze obiectul și să trateze fișierul ca suspect în loc să substituie un implicit
De ce putea un singur NaN întrerupe un export SVG sau JSON?
Pentru că PLDoubleToStr, formatter-ul invariant de numere din spatele content stream-urilor, SVG, XML, CSV și a celei mai mari părți din JSON-ul bibliotecii, scala input-ul și apela Round, iar Round(NaN) ridică EInvalidOp pe ținte precum Win32, unde Delphi lasă ne-mascată excepția x87 de operație invalidă. Excepția trăia după ce scriitorul emisese deja o parte din output, deci o măsurătoare degenerată, un 0/0 într-o metrică sau un NaN pasat de un apelant lăsau în urmă un fișier trunchiat. PLDoubleToStr întoarce acum 0 pentru NaN, iar ramura lui întreagă se strânge la ±9.2e18 ca și ramura fracționară, deci Infinity iese de asemenea ca un literal finit
Zero e răspunsul corect pentru un content stream, unde un slot de număr trebuie să țină un număr, și răspunsul greșit pentru un raport, unde 0 e o măsurătoare plauzibilă. Scriitorii JSON care trebuie să păstreze diferența folosesc PLJSONNumber(Value, Decimals) din PDFlibExtra, care scrie null pentru NaN sau Infinity și cifre invariante în rest. PLJSONNumber stă acum în spatele GetSimilarImageDeduplicationReportJSON, GetAnnotationHitsJSON și al rapoartelor de cod de bare, deskew, text structurat și PDF/VCR; raportul de deskew scria pe vremuri 0 pentru un unghi non-finit și scrie acum null
uses
  SysUtils, PDFlibTypes, PDFlibExtra;

function SkewReportJSON(Page: Integer; Angle, Confidence: Double): string;
var
  B: PLStringBuilder;
begin
  B := PLStringBuilder.Create(128);
  try
    // Formatează întâi fiecare Double la text; PLJSONNumber scrie null
    // pentru NaN sau Infinity și folosește întotdeauna punct zecimal
    B.Append('{"page":').Append(Page)
     .Append(',"angle":').Append(string(PLJSONNumber(Angle, 4)))
     .Append(',"confidence":').Append(string(PLJSONNumber(Confidence, 4)))
     .Append('}');
    // Niciodată B.Append(Angle): overload-ul Double urmează locale-ul utilizatorului
    Result := B.ToString;
  finally
    B.Free;
  end;
end;
Pe unde se mai strecoară locale-ul utilizatorului în JSON?
Prin orice formatter care consultă setările regionale, iar un audit complet al output-ului lizibil de mașină a găsit exact unul rămas: maxAcceptedMeanError în GetSimilarImageDeduplicationReportJSON, scris cu PLFloatToStr, un wrapper subțire peste FloatToStr. Pe un desktop al cărui separator zecimal e virgula, raportul conținea "maxAcceptedMeanError":1,5, pe care un parser JSON îl citește ca valoarea 1 urmată de un token rătăcit. Câmpul raportează cea mai mare eroare de pixel acceptată din deduplicarea perceptuală de imagini, și trece acum prin PLJSONNumber(Stats.MaxAcceptedMeanError, 6). O capcană rămasă e PLStringBuilder: pe Delphi e un simplu alias al lui System.SysUtils.TStringBuilder, al cărui overload Append(Double) formatează prin locale-ul utilizatorului, în vreme ce build-urile FPC folosesc o clasă a bibliotecii, deci un test pe Free Pascal sau pe o mașină en-US nu-l va prinde niciodată
uses
  System.SysUtils, System.JSON, PDFlibrary;

var
  Lib: TPDFlib;
  Report: WideString;
  Parsed: TJSONValue;
begin
  // Reproduce un desktop german sau francez în interiorul rulării de test
  FormatSettings.DecimalSeparator := ',';
  Lib := TPDFlib.Create;
  try
    // Folosiți un fixture care chiar conține imagini aproape-duplicate,
    // altfel eroarea medie e 0 și bug-ul rămâne ascuns
    Lib.LoadFromFile('scanned-batch.pdf', '');
    // Rulare uscată cu praguri 2, 2, 4: documentul nu e modificat
    Lib.GetSimilarImageDeduplicationReportJSON(2, 2, 4, Report);
    Parsed := TJSONObject.ParseJSONValue(Report);
    if Parsed = nil then
      raise Exception.Create('report is not valid JSON on a comma locale');
    Parsed.Free;
  finally
    Lib.Free;
  end;
end;
O suită de regresie pentru output JSON are nevoie de trei fixture-uri ca să rămână cinstită: o pagină care cară -.25, +1.5 și 007.5, un obiect care ține un întreg de 400 de cifre și orice raport rulat sub un locale cu virgulă, fiecare validat cu un parser strict, nu cu ochiul liber. Object JSON, document JSON și rapoartele de analiză din PDF Library for Delphi împart aceleași reguli de numere peste Delphi, C++Builder și Free Pascal; lista completă de funcționalități e pe pagina de produs PDF Library for Delphi