O PDFium Component transforma um PDF de layout fixo num modelo semântico que pode ser refluído, usando BuildReflowDocument, e exporta esse modelo como HTML autónomo através de ToHtml. Os títulos continuam a ser títulos, os itens de lista continuam a ser itens de lista, e as tabelas detetadas na página saem como marcação de tabela real, com células de cabeçalho e abrangências preservadas. Nada no resultado faz referência a um script ou a uma folha de estilos externa
A razão para se querer isto é que uma página PDF é um conjunto de glifos posicionados, o que é exatamente errado para um ecrã de telemóvel, um leitor de ecrã ou um índice de pesquisa. Toda a tentativa de resolver o problema extraindo texto simples perde a estrutura que tornava o documento legível, e toda a tentativa de o resolver convertendo páginas em imagens perde o texto por completo. Um modelo de refluxo mantém ambos: as palavras e as relações entre elas
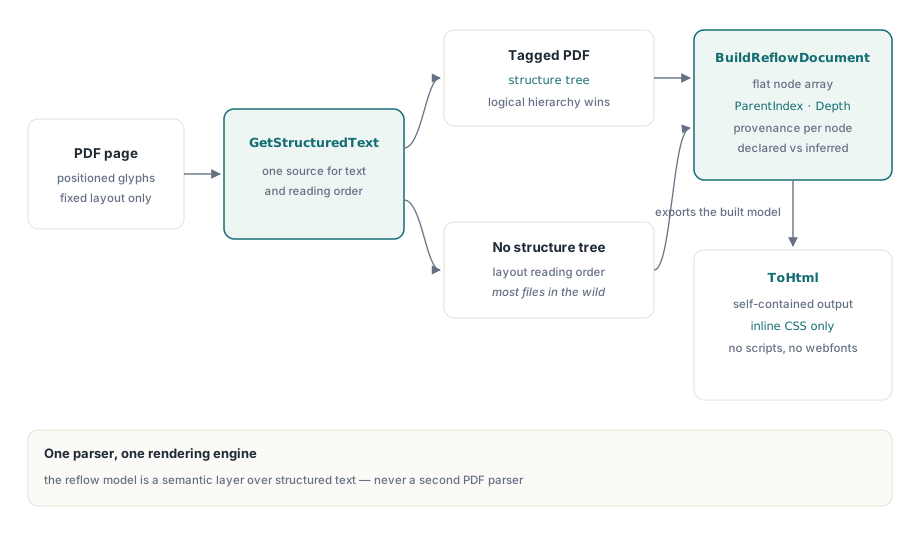
De onde vem a informação semântica?
Tudo começa em GetStructuredText, a única fonte de texto e semântica no componente. Quando o PDF transporta uma árvore de estrutura, PDF etiquetado conforme definido na cláusula 14.7 da ISO 32000-1, o modelo segue a hierarquia lógica que o produtor registou. Quando não a transporta, e a maioria dos PDF encontrados na prática não a transporta, o modelo recua para a ordem de layout físico já calculada para efeitos de ordem de leitura
Essa escolha mantém um limite rígido: não se introduz um segundo analisador de PDF nem um segundo motor de renderização para responder a perguntas que o existente já consegue responder. A maquinaria de ordem de leitura subjacente está descrita em blocos de texto estruturado e ordem de leitura, e o modelo de refluxo é uma camada semântica por cima dela, não uma substituição
Cada nó regista de onde veio a sua informação, para que um consumidor possa distinguir um título que o documento declarou de um título que as heurísticas de layout inferiram. Os pipelines sensíveis à confiança devem ler esse campo em vez de tratar todos os nós como igualmente autoritativos
Uma árvore plana, e por que razão não é uma árvore de objetos
O modelo é uma árvore achatada em pré-ordem: um array de nós em que cada nó transporta um ParentIndex e uma Depth, em vez de um registo recursivo ou um grafo de objetos com posse. Páginas, títulos, parágrafos, listas, itens de lista, figuras, legendas, tabelas, linhas e células residem todos nesse único array linear
Daí decorrem dois benefícios. Os consumidores podem percorrer o array em fluxo, por ordem, sem recursão, o que torna a emissão de HTML, Markdown ou uma vista em árvore um simples ciclo. E o layout mantém-se portável entre Delphi, C++Builder e Free Pascal, que diferem na forma como tratam tipos geridos recursivos através de uma fronteira de ABI. Um registo recursivo de arrays dinâmicos é exatamente o tipo de construção que compila em todo o lado e se comporta de forma subtilmente diferente em cada um:
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'report.pdf';
    Pdf.LoadDocument;

    Options := TPdfReflowOptions.Default;
    Options.FullDocument := True;
    Options.DetectTables := True;
    Options.IncludeCss := True;          // bloco de estilo em linha, sem ficheiro externo
    Options.MaxNodes := 200000;          // orçamento com falha fechada
    Options.MaxCharacters := 4000000;

    Doc := Pdf.BuildReflowDocument(Options);

    for I := 0 to High(Doc.Nodes) do
      case Doc.Nodes[I].Kind of
        prnkHeading:
          Writeln(Format('%sH%d: %s', [StringOfChar(' ', Doc.Nodes[I].Depth),
            Doc.Nodes[I].HeadingLevel, Doc.Nodes[I].Text]));
        prnkParagraph:
          Writeln(Format('%sp: %s', [StringOfChar(' ', Doc.Nodes[I].Depth),
            Copy(Doc.Nodes[I].Text, 1, 60)]));
        prnkTable:
          Writeln(Format('table on page %d', [Doc.Nodes[I].PageNumber]));
      end;

    Writeln(Format('%d node(s), %d table(s), %d character(s)',
      [Length(Doc.Nodes), Doc.TableCount, Doc.CharacterCount]));
  finally
    Pdf.Free;
  end;
end;
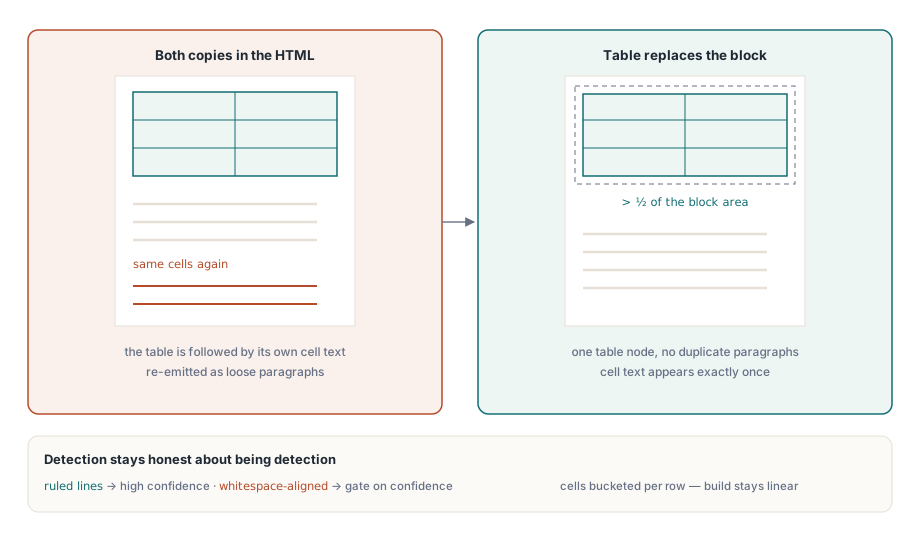
Como é que as tabelas não acabam por aparecer duas vezes?
A deteção de tabelas corre depois de o texto estruturado ter sido recolhido para uma página, o que cria um risco óbvio: o mesmo conteúdo de célula existe tanto nos blocos de texto como na tabela detetada. Emitir ambos produz HTML em que cada tabela é seguida do seu próprio conteúdo outra vez, como parágrafos soltos
A regra que resolve isto é geométrica. Quando uma tabela detetada cobre mais de metade da área de um bloco de texto, o nó de tabela substitui esse bloco em vez de se juntar a ele. A indexação de células dentro de uma linha é construída contando para dentro de compartimentos, pelo que a construção do modelo se mantém linear em células mais linhas, em vez de voltar a analisar cada célula por cada linha, o que importa em documentos financeiros onde uma única página pode transportar centenas de células
A estrutura detetada é honesta quanto a ser deteção. Uma tabela com linhas de régua é reconhecida de forma mais fiável do que uma alinhada apenas por espaços em branco, e a confiança do nó reflete isso. Para conteúdo em que uma tabela errada é melhor do que nenhuma tabela, mantenha a deteção ligada; para conversão de arquivo em que uma tabela errada é pior, condicione pela confiança
Exportar HTML que se mantém autónomo
ToHtml percorre o modelo já construído e nunca volta a consultar o PDFium, pelo que exportar duas vezes não custa nada extra e não pode produzir um resultado diferente a partir do mesmo modelo. O texto e os valores de atributo são escapados de forma uniforme, os níveis de título são limitados ao intervalo de h1 a h6 que o HTML realmente define, e as células de cabeçalho, RowSpan e ColumnSpan passam tal como foram escritos
O CSS opcional é um simples bloco de estilo em linha. Não há script, não há tipo de letra web, nem qualquer recurso externo de qualquer tipo, o que é o que torna o resultado seguro para incorporar num email, num visualizador de ajuda ou num controlo de navegador em sandbox:
var
  Html: WideString;
  Stream: TFileStream;
  Bytes: TBytes;
begin
  Options := TPdfReflowOptions.Default;
  Options.FullDocument := True;
  Options.IncludeCss := True;
  Options.IncludePageSections := True;   // manter os limites de página visíveis
  Options.PreserveLineBreaks := False;   // deixar o navegador quebrar os parágrafos

  Html := Pdf.BuildReflowDocument(Options).ToHtml;

  Bytes := TEncoding.UTF8.GetBytes(string(Html));
  Stream := TFileStream.Create('report.html', fmCreate);
  try
    if Length(Bytes) > 0 then
      Stream.WriteBuffer(Bytes[0], Length(Bytes));
  finally
    Stream.Free;
  end;
end;
PreserveLineBreaks é a opção que mais vale a pena ponderar. Uma quebra de linha em PDF é uma decisão de composição tomada para uma largura de página fixa, pelo que preservá-la num ecrã estreito reproduz exatamente o problema que o refluxo existe para resolver. Preserve as quebras para poesia, listagens de código e moradas; descarte-as para prosa
Orçamentos, cancelamento e estado da página
Carateres, nós, tabelas e células têm cada um o seu teto, e cada um é verificado antes da alocação, não depois, pelo que um documento malformado ou hostil falha de forma limpa em vez de consumir memória até que outra coisa o faça. O token de cancelamento é verificado nos limites de página, bloco, tabela, linha e célula, o que mantém responsiva a análise cancelada de um documento com mil páginas
Um comportamento importa especificamente para aplicações com interface gráfica: toda a análise do documento corre dentro de um âmbito que restaura a página ativa, pelo que o sucesso, a falha de orçamento e o cancelamento deixam todos a página atual do chamador intocada. Um visualizador que permita ao utilizador exportar enquanto está a ver a página 340 encontra-se, depois, ainda na página 340
Para que serve o refluxo, e para que não serve
O resultado do refluxo é uma excelente entrada para indexação de pesquisa, vistas de leitura acessíveis, apresentação em telemóvel e migração de conteúdo. Não é um conversor que preserva fidelidade: posições absolutas, fontes exatas, ilustrações vetoriais e geometria de página precisa estão fora do seu propósito por design. Quando um trabalho precisa que a página tenha o mesmo aspeto, renderize-a; quando precisa que a página seja legível noutro sítio, reflua-a
Para tecnologia de apoio especificamente, o modelo de refluxo combina com as funcionalidades de leitura descritas em construir um leitor acessível, e os documentos que transportam uma árvore de estrutura genuína produzem modelos visivelmente melhores, o que é um bom argumento para validar a etiquetagem a montante, conforme descrito em validação da árvore de estrutura PDF/UA
O refluxo, o texto estruturado, a validação de etiquetagem e a renderização partilham um único objeto de documento em Delphi, C++Builder e Lazarus; a API completa está descrita na página do PDFium Component para Delphi