O PDFium Component verifica a equivalência de metadados Info-XMP em PDF/A com o TPdf.InspectPdfAMetadata e repara-a com o TPdf.NormalizePdfAMetadata. A ISO 19005-1 (conforme corrigida pelo Cor.1) exige que cada uma das oito entradas Info mapeadas, de Title a ModDate, transporte o mesmo valor que a sua propriedade XMP, e não apenas que exista; a verificação lê a forma RDF correta, faz corresponder namespaces por URI e compara datas como instantes
O relatório de bug que costuma iniciar esta conversa parece inofensivo. Um sistema de gestão documental carimba um novo /ModDate no dicionário Info em cada gravação incremental, deixa o pacote XMP quieto, e seis meses depois uma auditoria de arquivo marca milhares de ficheiros como não conformes. As duas datas lá estão. É só que deixaram de coincidir na primeira edição, e uma verificação de presença nunca deu por isso. Edições de Title feitas através de uma API só de Info, e uma string Author como Finance; Controlling que uma ferramenta qualquer partiu em dois itens dc:creator, falham da mesma forma
Porque é que o PDF/A rejeita metadados que existem nos dois sítios?
O PDF/A rejeita-o porque a ISO 19005-1 §6.7.3 é uma regra de valor, não uma regra de presença: a Tabela 1 mapeia oito chaves Info em propriedades XMP, e a partir do momento em que uma chave Info está presente, a propriedade XMP mapeada tem de transportar um valor equivalente. O scanner ao nível de bytes descrito em validação preflight PDF/A com o PDFium Component só confirma que xmp:CreateDate e xmp:ModifyDate existem (pvaiMissingXmpDates). Desde a v3.72.0, o TPdf.ValidatePdfA corre adicionalmente a comparação completa de valores e acrescenta pvaiInfoXmpValueMismatch ao conjunto de problemas quando um pacote XMP existe mas discorda do Info (um pacote que não se consegue analisar conta como discordante). Um pacote em falta continua reportado como pvaiMissingXmpMetadata, pelo que os dois problemas nunca contam duas vezes o mesmo defeito
Que forma RDF precisa cada propriedade XMP mapeada?
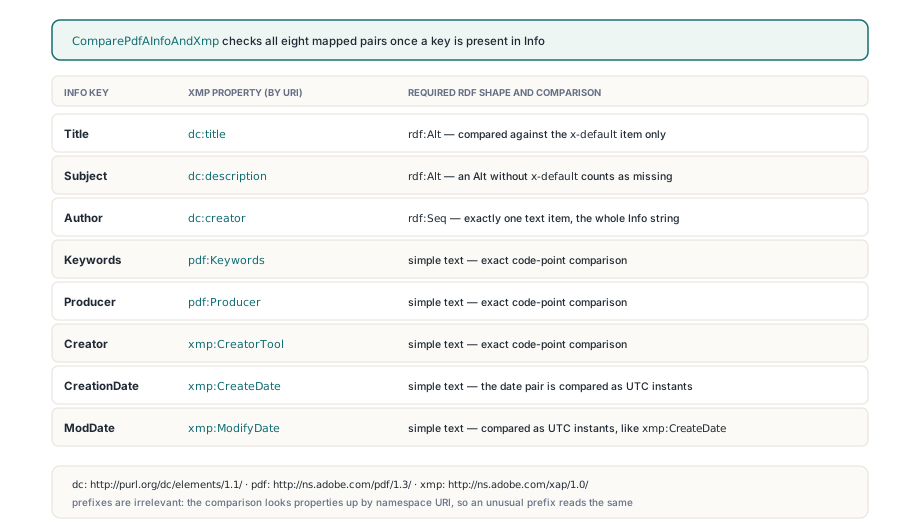
Cada um dos oito mapeamentos tem um tipo XMP fixo, e um valor correto no contentor errado continua a falhar. O ComparePdfAInfoAndXmp em FPdfPdfa.pas procura propriedades por URI de namespace, pelo que um pacote que ligue http://purl.org/dc/elements/1.1/ a um prefixo invulgar é lido exatamente como um que use dc. As formas exigidas são:
- Title →
dc:titlee Subject →dc:description: uma alternativa de línguardf:Alt, comparada apenas com o seu itemx-default(a etiqueta de língua é comparada sem distinção de maiúsculas); um Alt semx-defaultconta como em falta - Author →
dc:creator: umrdf:Seqcom exatamente um item de texto a transportar a string Info inteira, pelo que uma lista de autores separada por ponto e vírgula continua a ser uma única entrada - Keywords →
pdf:Keywordse Producer →pdf:Producer(namespacehttp://ns.adobe.com/pdf/1.3/): propriedades de texto simples - Creator →
xmp:CreatorTool, CreationDate →xmp:CreateDate, ModDate →xmp:ModifyDate(namespacehttp://ns.adobe.com/xap/1.0/): propriedades de texto simples
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
Os valores de texto são comparados como sequências exatas de code points Unicode, sem cortes de espaços, sem dobragem de maiúsculas e sem normalização. Um espaço final, ou um é pré-composto de um lado e um e decomposto mais acento combinável do outro, é um desacordo genuíno. O lado Info vem sempre da descodificação própria do PDFium de texto PDFDocEncoding e UTF-16 através do FPDF_GetMetaText, o que impede a biblioteca de reimplementar a descodificação de strings e errar de forma subtil; o lado XMP é tão limpo quanto os bytes que o produziram, razão pela qual as armadilhas de codepage que corrompem metadados XMP sob Free Pascal também importam aqui
Quando é que uma data PDF e uma data XMP são iguais?
Uma data PDF e uma data XMP são iguais quando descrevem o mesmo instante ao segundo, com o mesmo conhecimento de fuso horário dos dois lados. Os dois parsers aceitam precisão reduzida legal, pelo que D:2026 e 2026 significam ambos 1 de janeiro de 2026, 00:00:00. Quando ambos os valores transportam um fuso, são convertidos para UTC antes da comparação: D:20260827093659+08'00' é igual a 2026-08-27T01:36:59Z. Quando nenhum transporta fuso, as componentes locais são comparadas tal como estão escritas. Quando só um dos lados tem fuso, o resultado é pamsValueMismatch, porque inventar um desvio seria um palpite. Um segundo fracionário não zero como .250 no XMP também força um desacordo, já que uma data PDF não tem forma de o exprimir e arredondá-lo em silêncio esconderia um desacordo real; .000 é aceito. Valores não analisáveis são reportados separadamente como pamsInvalidInfoDate ou pamsInvalidXmpDate
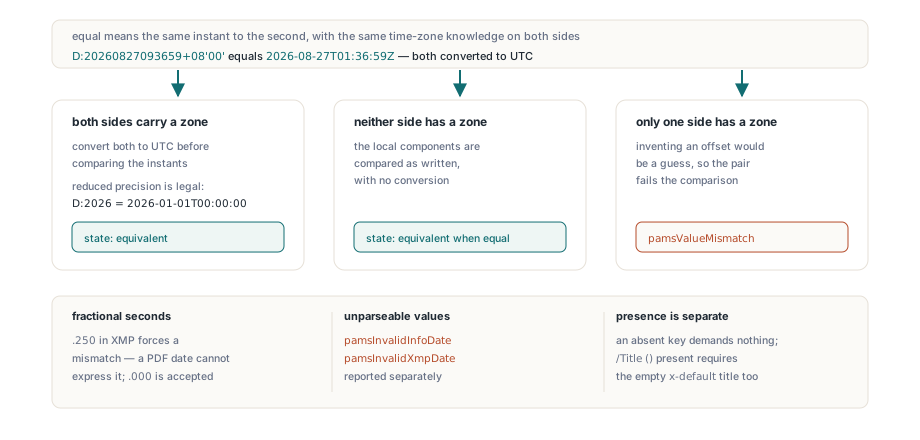
A presença tem a sua própria regra. O TPdfAMetadataValues.Present é um conjunto preenchido percorrendo o dicionário /Info do trailer ativo, e mantém «chave ausente» separado de «chave presente com string vazia». Uma chave ausente dá pamsNotRequired e nada exige do XMP; /Title () está presente, pelo que o pacote XMP tem de transportar também um título x-default vazio
Como inspecionar metadados Info e XMP antes de gravar?
O TPdf.InspectPdfAMetadata devolve um TPdfAMetadataReport com um TPdfAMetadataComparison por campo, cada um transportando o valor Info, o valor XMP e um TPdfAMetadataState, pelo que uma falha se pode explicar sem fazer engenharia inversa a uma única flag de validação. O MismatchFields resume o conjunto em falha, o HasXmpPacket diz-lhe se foi encontrado um pacote, e o XmpParseError transporta a mensagem do parser quando o pacote existe mas não se consegue ler
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;
O que muda o NormalizePdfAMetadata, e o que recusa?
O TPdf.NormalizePdfAMetadata trata o dicionário Info como a fonte de verdade e reescreve apenas as propriedades XMP cujo campo caiu em MismatchFields; todo o resto do pacote sobrevive. Title e Subject são escritos no item x-default enquanto as outras alternativas de língua ficam intactas, Author torna-se um rdf:Seq de um item, namespaces desconhecidos e propriedades não relacionadas são preservados, e as propriedades XMP para chaves Info ausentes ficam intocadas. Uma data Info com fuso é escrita como data XMP UTC canónica com sufixo Z; uma sem fuso conserva as suas componentes locais. A sobrecarga para ficheiro grava através de um ficheiro temporário e uma substituição atómica, e a atualização XMP em si é acrescentada como uma atualização incremental
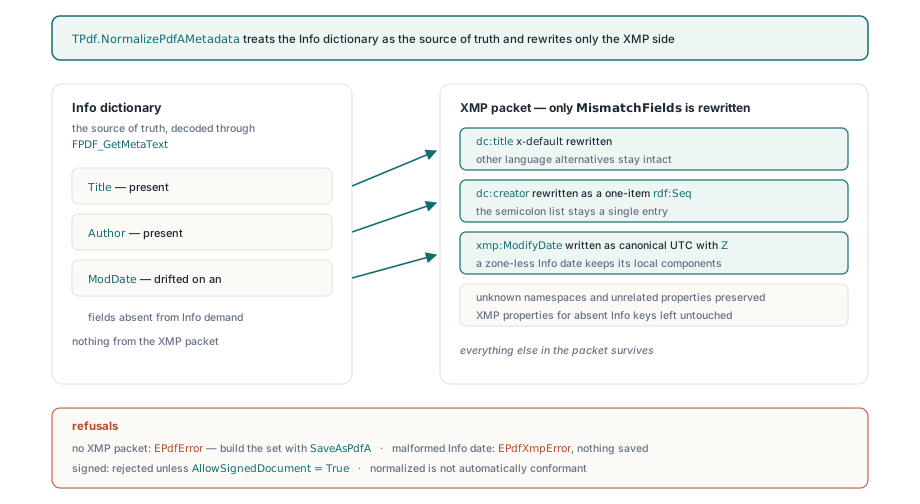
As recusas são deliberadas. Sem pacote XMP o método dispara EPdfError, porque construir um conjunto completo de identificação e metadados PDF/A é trabalho do SaveAsPdfA, coberto em criar ficheiros de arquivo PDF/A com o PDFium Component. Uma data Info malformada dispara EPdfXmpError em vez de escrever um valor errado de aparência plausível, e nada é gravado. Documentos assinados são recusados a menos que quem chama passe AllowSignedDocument = True. A equivalência é também uma regra da ISO 19005-1, pelo que um ficheiro normalizado não é automaticamente um conforme
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // já consistente, deixe o ficheiro quieto
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // data Info malformada ou pacote ilegível
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
Correr a comparação no seu próprio pacote XMP
O ComparePdfAInfoAndXmp e o SynchronizePdfAInfoToXmp são funções simples em FPdfPdfa que trabalham sobre um TPdfXmpPacket sem documento nenhum carregado, o que serve para testes unitários e pipelines que montam XMP a partir de um template. A única armadilha é o Present: um registo inicializado com Default(TPdfAMetadataValues) tem um conjunto vazio, todos os campos reportam então pamsNotRequired, e a comparação passa vacuamente independentemente dos valores que tenha preenchido
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Present decide que campos são obrigatórios; valores sozinhos são ignorados
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // xmp:ModifyDate passa a 2026-08-27T01:36:59Z, dc:creator um rdf:Seq de um item
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
Se o seu pipeline arquiva documentos que outros sistemas continuam a editar, emparelhe um varrimento noturno de InspectPdfAMetadata com o NormalizePdfAMetadata para os ficheiros que derivam, e mantenha o ValidatePdfA como portão antes de qualquer coisa partir para armazenamento de longo prazo. O relatório tipado, o caminho de reparação e o resto das ferramentas PDF/A vêm no PDFium Component for Delphi and C++Builder