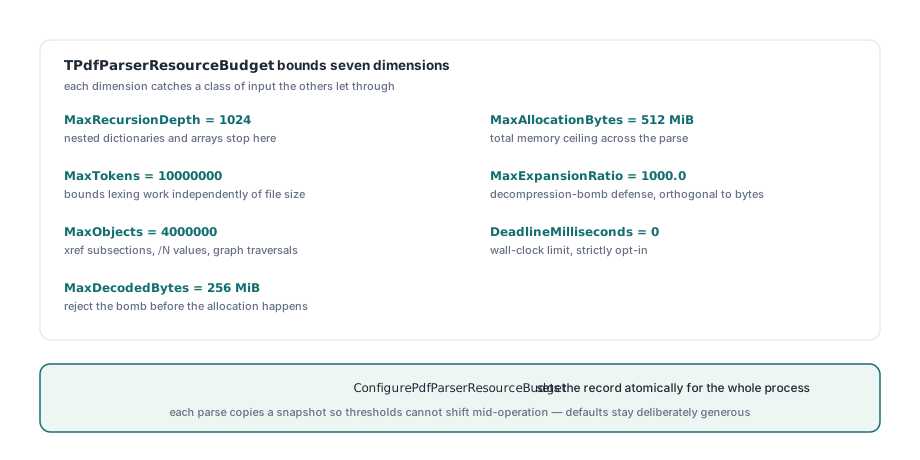
O PDFium Component expõe o TPdfParserResourceBudget, um único record que limita profundidade de recursão, contagem de tokens, contagem de objetos, bytes descodificados, ratio de expansão, alocação e um deadline de wall-clock para cada parser de PDF da biblioteca. O ConfigurePdfParserResourceBudget define-o atomicamente para o processo, e cada parse copia um snapshot para que os seus limiares não possam mudar a meio da operação
Seis parsers, seis limites privados
A situação que forçou isto era banal e provavelmente familiar. O percurso sparse de xref tinha o seu próprio limite de objetos. O inspector de streams tinha o seu próprio cap de bytes descodificados. O XMP tinha um, o XFDF e o FDF tinham outro, a normalização de conteúdo tinha um terceiro, e os padrões de preflight tinham um quarto. Cada um desses números era defensável por si e nenhum deles era alcançável do exterior, pelo que um caller que quisesse dizer «este path de intake trata uploads anónimos, nada aqui pode alocar mais de 64 MiB nem correr mais de quatro segundos» não tinha onde o dizer. O segundo problema era pior porque era silencioso: onde um limite vivia num global mutável, um parse que começou sob uma política podia acabar sob outra. Uma thread chama um setter enquanto outra vai a meio de um object stream, e a primeira metade desse percurso é limitada pelo teto antigo enquanto a segunda metade é limitada pelo novo. Nada rebenta, nada faz log, e depois não consegue dizer sob que limites a operação correu realmente, que é exatamente a propriedade para a qual precisava dos limites
O que é que o TPdfParserResourceBudget limita realmente?
Sete dimensões, escolhidas porque cada uma apanha uma classe de input que as outras deixam passar. O MaxRecursionDepth tem o padrão de 1024 e impede dicionários e arrays aninhados de transformar a sintaxe de objetos da ISO 32000-1 §7.3 num stack overflow. O MaxTokens tem o padrão de 10.000.000 e limita o trabalho de lexing independentemente do tamanho do ficheiro. O MaxObjects tem o padrão de 4.000.000 e cobre contagens de subsecções de cross-reference, valores /N de object streams e percursos de grafos. O MaxDecodedBytes tem o padrão de 256 MiB e o MaxAllocationBytes de 512 MiB, pelo que um ficheiro pode ser rejeitado antes da alocação em vez de depois. O MaxExpansionRatio tem o padrão de 1000.0 e é o que as pessoas subestimam: os filtros de stream da ISO 32000-1 §7.4 são compressão de uso geral, uns kilobytes de dados Flate podem legitimamente expandir-se em centenas de megabytes, e um teto de ratio é a defesa padrão contra uma decompression bomb. É ortogonal ao cap absoluto de bytes, porque um stream de 200 KiB que quer passar a 200 MiB está abaixo do teto de 256 MiB e continua a ser absurdo. O DeadlineMilliseconds tem o padrão de 0, ou seja sem deadline, pelo que essa dimensão é estritamente opt-in. Os padrões como conjunto são deliberadamente generosos, dimensionados para impedir que documentos de negócio vulgares tropecem em algo em vez de serem um perfil endurecido; se o seu input vem de um formulário de upload público, quer algo mais próximo dos números abaixo, juntamente com as regras descritas em endurecer um painel de preview de PDF em Delphi
uses
  FPdfPdfCommon;

procedure ApplyUntrustedIntakeBudget;
var
  Budget: TPdfParserResourceBudget;
begin
  Budget := TPdfParserResourceBudget.Default;
  // Padrões mantidos: MaxRecursionDepth 1024, MaxTokens 10000000,
  // MaxObjects 4000000
  Budget.MaxDecodedBytes      := Int64(32) * 1024 * 1024;  // padrão 256 MiB
  Budget.MaxAllocationBytes   := Int64(64) * 1024 * 1024;  // padrão 512 MiB
  Budget.MaxExpansionRatio    := 50.0;                     // padrão 1000.0
  Budget.DeadlineMilliseconds := 4000;                     // padrão 0 = desligado
  ConfigurePdfParserResourceBudget(Budget);
end;
Porque tirar um snapshot em vez de ler o global?
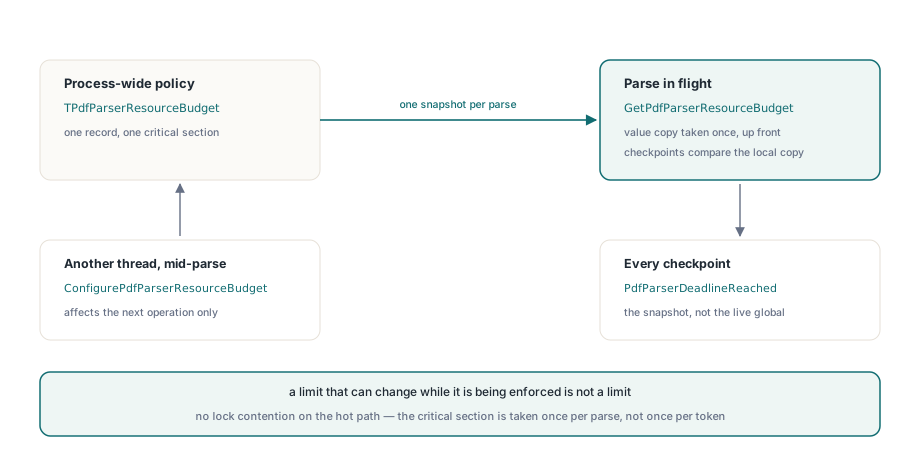
Porque um limite que pode mudar enquanto está a ser aplicado não é um limite. Este é o ponto central de design de toda a funcionalidade, e é uma linha de disciplina em cada entry point: leia a política uma vez no início da operação para um TPdfParserResourceBudget local, e depois faça cada checkpoint comparar contra essa cópia local. O GetPdfParserResourceBudget entra na critical section e devolve uma cópia por valor do record, e depois disso o parse nunca mais toca em estado global mutável. O resultado é que uma chamada ao ConfigurePdfParserResourceBudget de outra thread afeta a operação seguinte, nunca a que está em voo. Parses concorrentes correm sob políticas diferentes sem interferir, uma operação que falhou num limite de recursos falhou contra um único conjunto coerente de limiares, e não há lock contention no hot path porque o lock é tomado uma vez por parse em vez de uma vez por token
type
  TCustomScanState = record
    Budget: TPdfParserResourceBudget;
    StartTick: Cardinal;
    TokenCount: Int64;
    Depth: Integer;
  end;

procedure BeginScan(var S: TCustomScanState);
begin
  S.Budget := GetPdfParserResourceBudget;  // snapshot tirado uma vez, logo à partida
  S.StartTick := PdfParserStartTick;
  S.TokenCount := 0;
  S.Depth := 0;
end;

function ScanCheckpoint(var S: TCustomScanState): Boolean;
begin
  Result := False;
  if PdfParserDeadlineReached(S.StartTick, S.Budget) then
    Exit;
  Inc(S.TokenCount);
  if S.TokenCount > S.Budget.MaxTokens then
    Exit;
  if S.Depth > S.Budget.MaxRecursionDepth then
    Exit;
  Result := True;
end;
Se escreve o seu próprio parser em cima da biblioteca, copie essa forma em vez de chamar o GetPdfParserResourceBudget dentro do seu loop de tokens. Chamá-lo por token é correto mas inútil: paga uma critical section em cada iteração e reintroduz o drift a meio da operação que o snapshot existia para prevenir
Porque é que um teto de bytes não trava um ficheiro patológico?
Porque tamanho e custo estão apenas vagamente relacionados em PDF. Um ficheiro de 400 KiB com um cross-reference stream da ISO 32000-1 §7.5.8 cujos arrays /Index e /W descrevem uma contagem de entradas plausível mas hostil, uma cadeia de object streams que revisita os mesmos offsets, ou um content stream de operadores em que cada um custa mais do que parece, vai ficar confortavelmente abaixo de cada teto de bytes e objetos que definir e ainda assim ocupar uma worker thread durante minutos. As contagens de bytes limitam memória; não limitam tempo. É para isso que servem o PdfParserStartTick e o PdfParserDeadlineReached. O PdfParserStartTick captura um valor de tick no início da operação e o PdfParserDeadlineReached compara o tempo decorrido com o DeadlineMilliseconds, devolvendo False sempre que o deadline é 0. A subtração corre em aritmética sem sinal, pelo que um rollover do contador de ticks não produz um timeout espúrio. O parsing de cross-references, a descodificação de object streams, a normalização de tokens de conteúdo e os readers de FDF e XFDF verificam-no todos nos heads dos seus loops, pelo que um parse acima do budget para num checkpoint em vez de ser morto de fora
Duas ressalvas honestas. É tempo de wall-clock, não de CPU, pelo que uma máquina a fazer swap ou um build server sob carga pode disparar um deadline que uma máquina calma ultrapassaria, o que aconselha a defini-lo bem acima do seu pior caso observado em vez de perto da mediana. E está desligado por padrão, porque um deadline que dispara num documento legitimamente grande durante processamento em lote de fim de mês é uma falha pior do que aquela que previne. Faça opt-in por path de intake em vez de global, e junte-lhe as verificações estruturais em validar cross-reference streams
O budget é um teto, não um substituto dos limites de formato
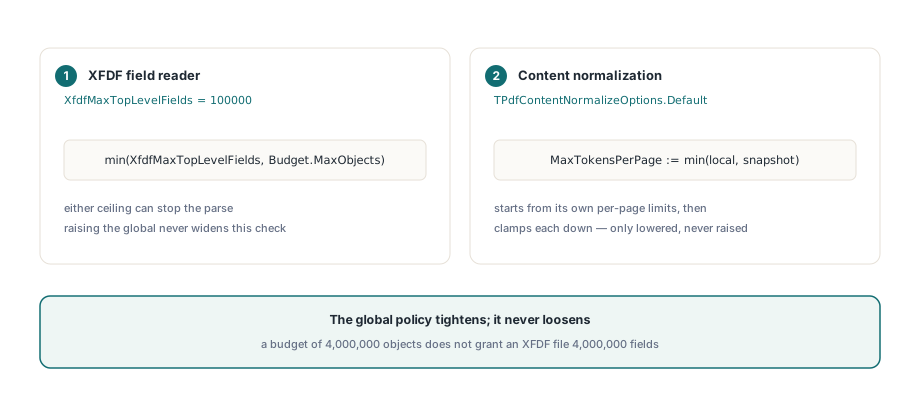
Cada parser mantém as suas próprias constantes específicas de formato e aplica as duas. O XFDF é o exemplo mais claro: o reader de campos impõe XfdfMaxTopLevelFields e uma constante MaxFieldNodes de 100000 juntamente com o valor do snapshot, e qualquer um dos dois pode parar o parse
const
  XfdfMaxTopLevelFields = 100000;   // local ao formato, aplica-se sempre
...
  // Os dois limites estão ativos; vence o que for menor
  if (FieldCount >= XfdfMaxTopLevelFields) or
     (FieldCount >= Budget.MaxObjects) then
    Exit(False);
Isto é intencional e vale a pena interiorizar antes de procurar um botão que não existe. Um budget global de 4.000.000 de objetos não concede a um ficheiro XFDF 4.000.000 de campos, porque 100000 campos já está muito fora de qualquer coisa que um export de anotações real produz, e subir um teto global não devia alargar em silêncio uma sanity check específica de formato. A normalização de conteúdo funciona da mesma forma na direção oposta: o TPdfContentNormalizeOptions.Default parte dos seus próprios limites por página e depois aperta cada um deles para baixo até ao snapshot, pelo que o MaxTokensPerPage só pode ser baixado pelo budget, nunca subido. A política global aperta; nunca afrouxa
Configuração má falha quando a configura
O ConfigurePdfParserResourceBudget valida antes de atribuir. Um valor não positivo em qualquer das seis dimensões numéricas levanta logo, e um MaxDecodedBytes acima de High(Integer) é rejeitado como excedendo os limites da plataforma em vez de ser truncado em silêncio algures no fundo de um decoder. Isto importa mais do que parece: um budget construído a partir de um ficheiro de config com uma chave em falta dá-lhe zeros, e um teto de objetos a zero aceite no arranque transforma-se numa falha de parse misteriosa no primeiro documento três horas depois, momento em que ninguém suspeita da config. O mesmo cuidado aplica-se a qualquer código que aperte o budget temporariamente, incluindo testes. A política é ao nível do processo, pelo que deixar um deadline de 4 segundos instalado depois de uma fixture acabar envenena todas as seguintes; faça save e restore à volta da mudança
var
  Saved: TPdfParserResourceBudget;
begin
  Saved := GetPdfParserResourceBudget;
  try
    ApplyUntrustedIntakeBudget;
    ProcessInboundDocument(FileName);
  finally
    ConfigurePdfParserResourceBudget(Saved);
  end;
end;
O ResetPdfParserResourceBudget é a versão mais bruta, restaurando o TPdfParserResourceBudget.Default por completo. Use-o no teardown de testes onde quer um estado conhecido, e use save-and-restore em código de produção, onde o estado a que tem de voltar é o que a aplicação anfitriã configurou no arranque
Onde o budget deixa de ajudar
É uma única política ao nível do processo, e essa é a sua principal limitação. Não pode dar a uma worker thread um perfil estrito e a outra um permissivo, porque há um record atrás de uma critical section; se precisa genuinamente de limites por tenant, a forma que funciona é serializar cada classe de política no seu próprio processo, ou enquadrar o trabalho com save-and-restore e aceitar que o enquadramento só é seguro quando nada mais está a fazer parse em concorrência. Também limita parsing, não rendering: a memória de rasterização, o crescimento da font cache e a descodificação de imagens ficam fora destas sete dimensões e precisam dos seus próprios controlos. E um budget diz-lhe que uma operação foi cara demais, nunca porquê. O teto que disparou é o sintoma, e o array /Index mal formado ou a cadeia de filtros descontrolada por trás dele ainda têm de ser diagnosticados à mão, que é a razão pela qual o path de descodificação descrito em descodificação de object streams e predictors vale a pena entender antes de começar a mexer nos números. Trate o budget como a coisa que impede um documento mau de levar o processo abaixo consigo, e mantenha o seu logging bom o suficiente para descobrir o que o documento estava a fazer
Toda a superfície da API do parser, o record do budget e um build com source para Delphi, C++Builder e Lazarus estão na página do produto: PDFium Component