O PDFium Component versão 3.117.0 liga uma tabela que se quebra numa fronteira de página quando ambos os fragmentos tocam nas margens da página, ou quando não há texto corrido abaixo do primeiro fragmento e acima do segundo, com cabeçalhos e rodapés correntes ignorados. O ExtractDocumentTables aplica esse teste baseado no conteúdo como alternativa ao teste mais antigo das margens da página, recusa um fragmento da página seguinte cuja primeira linha seja uma única célula de legenda a toda a largura, e mantém uma linha isolada que transborda para a página seguinte como parte da sua cadeia de continuação
O artigo sobre deteção e extração de tabelas apresentava a continuação como quatro gates estritos e tratava «toca na margem da página» como um deles. Essa descrição era exata para a versão que cobria, e era também errada para a maioria das tabelas que as pessoas realmente dão ao componente. Este artigo é a correção: que documentos o teste das margens não consegue tratar, o que o substituiu, e os dois casos laterais que a correção arrastou consigo
Porque é que o teste das margens da página falha em exportações do Word?
O teste das margens da página falha porque um processador de texto deixa de dispor linhas na margem inferior e não no limite do papel. Com o ContinuationMargin predefinido de 36 pontos, a regra original exigia que a aresta inferior do fragmento anterior ficasse dentro de 36 pontos do fundo da página e que a aresta superior do fragmento seguinte ficasse dentro de 36 pontos do topo da página. Um documento exportado do Word com as suas margens predefinidas de uma polegada põe a última linha pelo menos 72 pontos acima do fundo da página, e mais se houver rodapé, pelo que a condição nunca se verificava. Todas as tabelas longas desses documentos voltavam como fragmentos independentes com o ContinuationGroup a zero, e quem chama voltava a ter de as juntar à mão. O teste continua a fazer sentido para aquilo em torno do que foi desenhado: relatórios gerados por motores de layout que enchem a página até uma caixa de conteúdo fixa e começam a página seguinte encostada ao topo. Não é uma regra má, é uma regra incompleta, e é por isso que a versão 3.117.0 a manteve e acrescentou um segundo caminho em vez de a substituir
O que é que o teste baseado no conteúdo verifica em vez disso?
O teste baseado no conteúdo verifica se algo além da tabela ocupa o espaço entre os dois fragmentos, usando as caixas de palavra de cada página em vez da geometria da página. Enquanto percorre o documento, o ExtractDocumentTables registra, por página, a aresta inferior mais baixa de qualquer palavra cujo topo fique acima da faixa do rodapé e a aresta superior mais alta de qualquer palavra cujo fundo fique abaixo da faixa do cabeçalho. As duas faixas têm ContinuationMargin pontos de profundidade, pelo que a mesma opção acumula agora duas funções: folga em relação à margem da página e altura das zonas de cabeçalho e rodapé correntes. Um par de fragmentos passa quando a aresta inferior do anterior está ao nível ou abaixo do texto corrido mais baixo da sua página e a aresta superior do seguinte está ao nível ou acima do texto corrido mais alto da página seguinte, cada uma dentro do AlignmentTolerance. Em termos simples: a tabela era a última coisa na página N e a primeira na página N+1, e um número de página ou um título de documento na faixa da margem não contam. Essa exclusão não é arbitrária. A ISO 32000-1 §14.8.2.2 classifica cabeçalhos e rodapés correntes como artefactos de paginação, conteúdo que existe por causa da quebra de página e não apesar dela, e a mesma ideia que deixa um leitor com tags saltá-los é o que permite a uma tabela continuar para lá deles. O artigo sobre conteúdo marcado explica como os ficheiros com tags declaram esses artefactos explicitamente; aqui a classificação é inferida pela posição, porque a maioria das tabelas exportadas não traz tags nenhumas
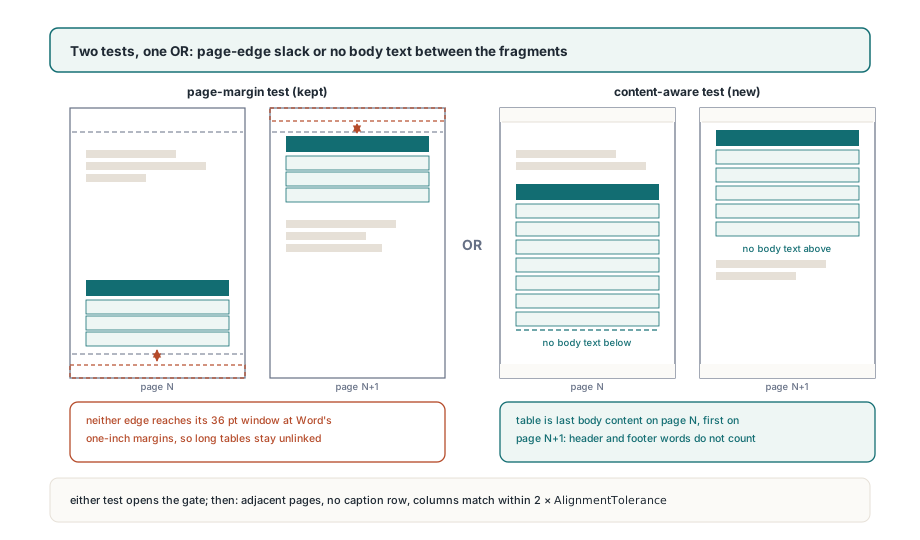
Os dois testes combinam-se com OR. Um relatório de um motor de layout cujas tabelas chegam ao limite do papel passa o primeiro; uma exportação do Word cujas tabelas param na margem passa o segundo; um documento que faça as duas coisas passa duas vezes. Só depois de um deles ser bem-sucedido é que os restantes gates correm, e correm por uma ordem fixa: os números de página têm de ser adjacentes, o fragmento seguinte não pode começar com uma linha de legenda, e as fronteiras de coluna têm de coincidir dentro do dobro do AlignmentTolerance, que é 6 pontos com os valores predefinidos. A enumeração é TPdfTableContinuation com os valores ptcNone, ptcStart, ptcMiddle e ptcEnd. Um fragmento marcado como ptcEnd que depois se ligue a ainda outra página é promovido a ptcMiddle, pelo que uma tabela de três páginas lê-se como início, meio, fim por ordem de página. Os números de grupo começam em 1 e 0 significa sem ligação, e o ToJson emite a mesma informação nos membros continuation e continuationGroup, que é a forma a preferir se for um serviço a jusante a fazer a costura
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;
    Options.DetectContinuations := True;     // predefinido; mostrado por clareza
    Options.ContinuationMargin := 54;        // rodapé de duas linhas, ~50 pt de profundidade

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d (%d rows)',
          [Tables[I].PageNumber, Tables[I].RowCount]));
      end;
  finally
    Pdf.Free;
  end;
end;
Como é que uma linha de legenda impede que duas tabelas se fundam?
Um fragmento da página seguinte cuja primeira linha seja uma célula que abrange todas as colunas é tratado como uma tabela nova, nunca como o resto da anterior. Esta regra existe porque o teste baseado no conteúdo, sozinho, liga com demasiada facilidade. O caso que a expôs era um formulário ao estilo de transcrição: uma tabela termina perto do fundo da página 1, uma segunda tabela com larguras de coluna idênticas começa perto do topo da página 2, entre elas só está o rodapé, e as colunas coincidem ao ponto. Com o teste das margens as duas nunca se encontravam, porque nenhuma tocava numa margem; com o teste do conteúdo ligaram-se de imediato, e um formulário com secções tornou-se uma grelha incoerente. O que as separa é visível na estrutura das células. A segunda tabela abre com uma legenda de secção como «RECIPIENT INFORMATION» disposta como uma única célula unida a toda a largura, e uma continuação genuína nunca faz isso, porque a legenda pertence à tabela que já começou na página anterior. O TableStartsWithCaptionRow codifica exatamente isso: o fragmento tem pelo menos duas colunas e contém uma célula com RowIndex = 0, ColumnIndex = 0 e ColumnSpan = ColumnCount. A verificação corre apenas no fragmento seguinte, pelo que uma tabela cuja própria linha de legenda esteja na sua primeira página não é afetada; a legenda está na página N, e só o fragmento da página N+1 é inspecionado
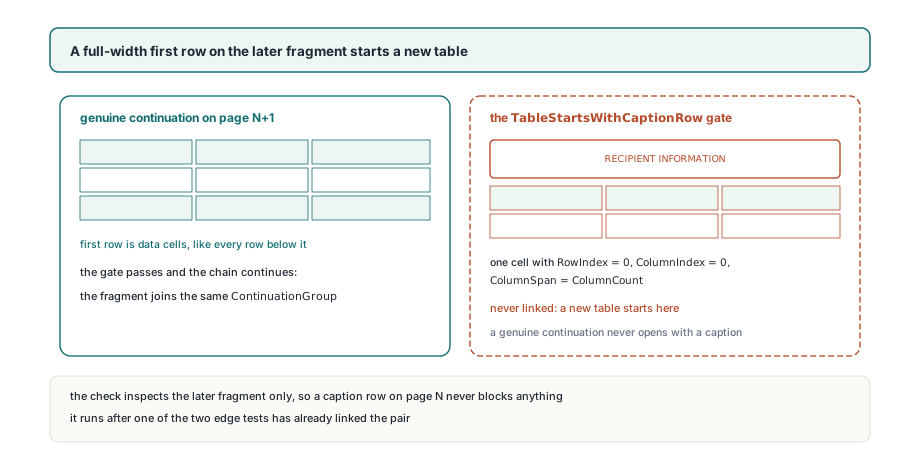
A comparação de colunas que se segue, o TablesHaveMatchingColumns, é mais estrita do que «o mesmo número de colunas». Reconstrói as posições das fronteiras de cada fragmento a partir dos retângulos das células, interpola as fronteiras que as células unidas escondem e rejeita o par quando alguma fronteira se desvia mais do que a tolerância. Duas tabelas de quatro colunas com proporções diferentes ficam por isso separadas, mesmo quando todo o resto coincide
O que acontece a uma linha isolada que transborda para a página seguinte?
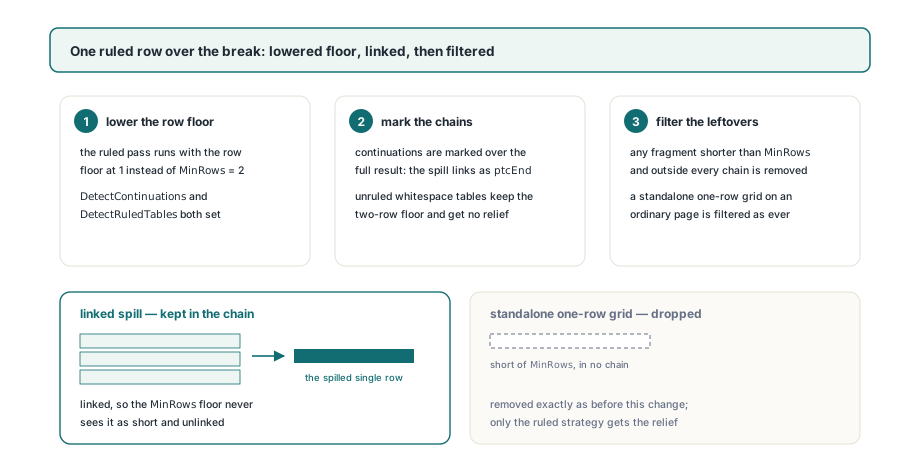
Uma grelha com linhas que leva uma linha para a página seguinte é agora detetada e ligada, desde que acabe numa cadeia de continuação; sozinha, é descartada. O MinRows predefinido de 2 existe para evitar que um par de linhas perdido seja reportado como tabela, mas uma última linha empurrada para lá da quebra é uma linha real que um limite rígido de 2 deixava cair em silêncio, e o resto da tabela parecia completo quando não estava. A varredura ao nível do documento trata disso em três passos. Quando DetectContinuations e DetectRuledTables estão ambos definidos, a passagem por página corre o detetor de grelhas com o limite de linhas temporariamente baixado para 1, e é por isso que o ExtractTables passa agora a aceitar MinRows de 1 para grelhas com linhas, enquanto a deteção por espaços mantém um limite interno de 2. As continuações são marcadas sobre o resultado completo. Depois é removida toda a tabela mais curta do que o MinRows de quem chama e que não faça parte de nenhuma cadeia. O fragmento de uma só linha sobrevive apenas porque foi ligado, e uma grelha de uma linha a meio de uma página normal é filtrada exatamente como antes
// Reconstruir cada cadeia como um único CSV, descartando as linhas
// de cabeçalho repetidas nos fragmentos de continuação
procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R: Integer;
  Lines: TStringList;
  Csv: TStringList;
begin
  Csv := TStringList.Create;
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      if Tables[I].Continuation in [ptcNone, ptcStart] then
        Csv.Clear;
      Lines.Text := string(Tables[I].ToCsv);
      if (Tables[I].Continuation in [ptcMiddle, ptcEnd]) and
         (Lines.Count > 1) and (Tables[I].RowCount > 1) then
        Lines.Delete(0);            // cabeçalho repetido pelo processador de texto
      for R := 0 to Lines.Count - 1 do
        Csv.Add(Lines[R]);
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Csv.SaveToFile(Format('%s\page%d-group%d.csv',
          [Folder, Tables[I].PageNumber, Tables[I].ContinuationGroup]));
    end;
  finally
    Lines.Free;
    Csv.Free;
  end;
end;
Dois pormenores nessa rotina são deliberados. A linha transbordada nunca é removida, porque a guarda sobre o RowCount a mantém, e um processador de texto que repete a linha de cabeçalho em cada página produz um fragmento cuja primeira linha é o cabeçalho outra vez, pelo que descartar a linha zero nos fragmentos de meio e de fim está certo nesse caso e errado para um gerador que não repita cabeçalhos. Verifique um documento antes de soltar a rotina sobre uma pasta
Onde é que as regras ainda param
O teste baseado no conteúdo vale apenas o que vale a camada de texto que lê. Numa página digitalizada sem texto nenhum, os extremos de texto corrido registados recuam para os limites da página, a condição de «nada entre eles» é satisfeita de forma vazia, e só restam os gates da linha de legenda e das colunas; uma grelha com linhas nessa página continua a ser encontrada como esqueleto vazio, pelo que a cadeia pode ligar corretamente, mas nada do texto em volta foi de facto verificado. Acrescente primeiro uma camada de texto se isso importar. Rodapés renderizados como imagens e não como texto são invisíveis para a lógica das faixas, e inofensivos pela mesma razão
As faixas são um único número. Um rodapé mais profundo do que o ContinuationMargin deixa as suas linhas inferiores dentro da zona de corpo, o que faz o fragmento anterior parecer seguido de texto e bloqueia a ligação; aumente a opção até à profundidade real da faixa, como faz o primeiro exemplo. Aumente-a demasiado e um parágrafo curto de fecho perto do fundo da página escorrega para dentro da faixa e é ignorado, o que liga a tabela ao que vier a seguir. A regra da legenda tem uma falha em espelho: um gerador que escreva uma faixa unida de «continuação» como primeira linha de cada fragmento de continuação verá esses fragmentos recusados como tabelas novas, e o único remédio hoje é costurar você mesmo por ContinuationGroup sem afrouxar nada, porque a regra não tem interruptor
As tabelas detetadas por espaços não recebem nada deste alívio de uma linha. A estratégia por espaços precisa de duas linhas alinhadas para sequer ver uma tabela, pelo que uma tabela sem linhas que transborde uma linha continua a ser reportada com essa linha a menos. Quando isso acontecer, as caixas de palavra por trás dos blocos de texto estruturado e ordem de leitura dão-lhe as posições cruas para a recuperar. No conjunto de amostras que motivou este trabalho, treze exportações de processadores de texto e de navegadores, os cinco documentos com tabelas genuinamente de várias páginas ligaram-se todos em cadeias únicas e o formulário de transcrição que antes se fundia ficou separado, que é a fasquia contra a qual a versão foi medida, e não uma promessa sobre todos os layouts
A marcação de continuações, a regra da legenda e a passagem de uma só linha vivem todas no caminho ao nível do documento partilhado pelas compilações Delphi, C++Builder e Lazarus; a API completa de extração de tabelas está descrita na página do PDFium Component para Delphi