O PDFium Component escreve texto numa página PDF ao nível do glifo com AddCidType2Text, incorporando dados TrueType que o utilizador fornece como uma fonte CID Tipo 2. Atribui a cada instância de glifo um CID sequencial, gera o mapa explícito CID-to-GID e o CMap ToUnicode, e junta os glifos na mesma linha de base num único objeto de texto nativo. A subconjuntação opcional mantém o ficheiro pequeno, com uma política explícita para o que acontece quando a subconjuntação falha
A escrita ao nível do glifo é o que se precisa quando o texto já foi moldado (shaped). O árabe, o devanágari e qualquer escrita com formas contextuais produzem uma sequência de identificadores de glifo que já não mapeia um para um com os carateres, pelo que uma API que recebe uma string e um nome de fonte não consegue expressar o resultado. Entregar diretamente glifos e posições é a única forma de colocar num PDF texto de escrita complexa corretamente moldado
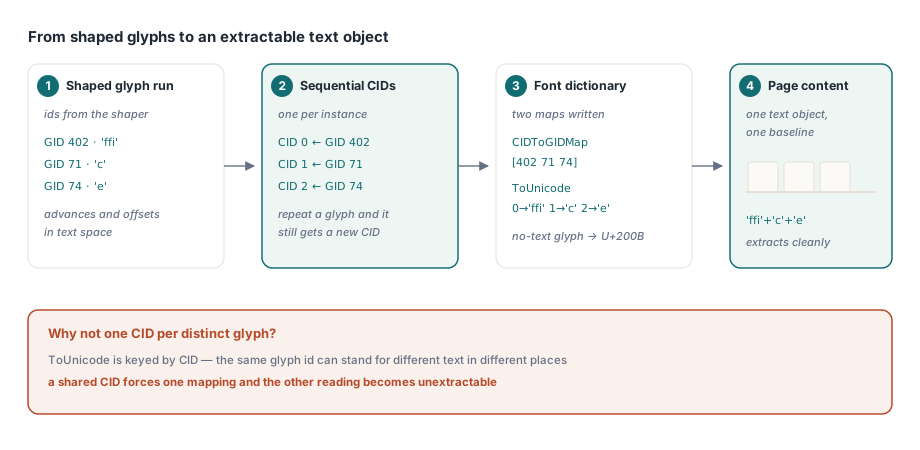
Porque é que cada instância de glifo recebe o seu próprio CID
A otimização tentadora é desduplicar: um CID por identificador de glifo distinto, reutilizado onde quer que esse glifo apareça. Produz uma fonte mais pequena e quebra a extração de texto, porque o mesmo glifo pode corresponder legitimamente a conteúdo Unicode diferente em locais diferentes
Um glifo de ligadura é o caso claro. O mesmo glifo "ffi" pode representar os três carateres numa palavra e, após uma decisão de moldagem diferente, outra coisa noutro sítio. O mapa ToUnicode é indexado por CID, pelo que um CID partilhado só pode transportar um mapeamento, e o texto que perder essa disputa torna-se inextraível
Assim, cada instância de glifo recebe o seu próprio CID, e cada mapeamento é livre de ser várias unidades de código UTF-16. Um glifo sem texto significativo — um elemento decorativo, um glifo apenas de posicionamento — mapeia explicitamente para U+200B, um espaço de largura zero, pelo que todos os CID têm um resultado de extração observável, em vez de uma lacuna
uses
  PDFium;

var
  Pdf: TPdf;
  Glyphs: TPdfCidGlyphs;
  Options: TPdfCidFontOptions;
  Report: TPdfCidFontReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'label.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 1;

    // Uma entrada por glifo moldado: o id do glifo, o texto que representa,
    // e o seu avanço e desvios no espaço de texto
    SetLength(Glyphs, 3);
    Glyphs[0].GlyphID := 402;  Glyphs[0].UnicodeText := 'ffi';
    Glyphs[0].Advance := 18.4;
    Glyphs[1].GlyphID := 71;  Glyphs[1].UnicodeText := 'c';
    Glyphs[1].Advance := 9.8;
    Glyphs[2].GlyphID := 74;   Glyphs[2].UnicodeText := 'e';
    Glyphs[2].Advance := 9.2;

    Options := TPdfCidFontOptions.Default;   // subset preferred
    Options.VerifyExtraction := True;

    if Pdf.AddCidType2Text(LoadFileBytes('NotoSans.ttf'), Glyphs,
         11, 72, 700, Options, Report) then
      Writeln(Format('%d glyphs, %d unique, font %d -> %d bytes, match=%s',
        [Report.GlyphCount, Report.UniqueGlyphCount,
         Report.OriginalFontBytes, Report.EmbeddedFontBytes,
         BoolToStr(Report.ExtractionMatches, True)]));
  finally
    Pdf.Free;
  end;
end;
Subconjuntação, e as verificações que um código de retorno não dá
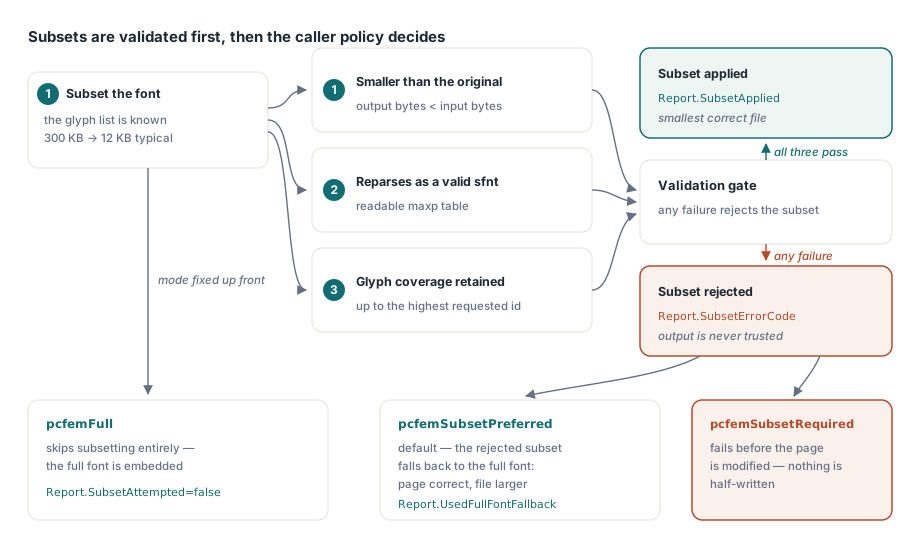
Subconjuntar uma fonte aos glifos realmente utilizados é a diferença entre incorporar 300 KB e incorporar 12 KB, e num documento com várias fontes isso decide se o ficheiro é enviável por email. O percurso de subconjuntação da plataforma aceita diretamente uma lista de glifos, o que se ajusta perfeitamente a esta API, já que quem chama já conhece todos os identificadores de glifo em uso
O que isso não dá é confiança. Uma chamada de subconjuntação pode reportar sucesso e devolver uma saída inutilizável, pelo que o componente valida três propriedades antes de aceitar o resultado: a saída tem de ser mais pequena do que a original, tem de voltar a analisar-se como um sfnt válido com uma tabela maxp legível, e tem de reter glifos até ao identificador original mais alto pedido. Qualquer falha significa que o subconjunto é rejeitado
O que acontece a seguir é política de quem chama. Sob pcfemSubsetPreferred, a predefinição, um subconjunto rejeitado recorre à incorporação da fonte completa, pelo que a página fica correta e apenas maior. Sob pcfemSubsetRequired, a operação falha antes de a página ser modificada, que é o que um pipeline limitado em tamanho quer. pcfemFull ignora a subconjuntação por completo. O relatório diz-lhe que percurso foi tomado através de SubsetAttempted, SubsetApplied, UsedFullFontFallback e SubsetErrorCode
Verificação que não pode produzir um falso positivo
Com VerifyExtraction ativado, o componente confirma que o que escreveu pode ser lido de volta. A forma ingénua de o fazer é extrair a página inteira e procurar a string esperada, e está errada: uma página que já continha esse texto passa a verificação mesmo quando o novo texto foi escrito incorretamente
Em vez disso, a página de texto é reconstruída e os identificadores de objeto inseridos por esta chamada são lidos individualmente, pela ordem de inserção, e concatenados. O resultado é comparado com o texto esperado, e o relatório expõe ambas as strings juntamente com o booleano, pelo que uma discrepância pode ser diagnosticada, em vez de apenas detetada
Ative-a durante o desenvolvimento e em qualquer pipeline onde a extraibilidade seja um requisito — arquivos pesquisáveis, conformidade de acessibilidade, mineração de texto a jusante. O custo é uma reconstrução da página de texto por chamada, razão pela qual não está ativa por predefinição em ciclos apertados
Orçamentos e falha atómica
Os bytes da fonte, as instâncias de glifo e as unidades de código Unicode têm cada um um limite antes da alocação, e o formato da fonte, o índice TTC, o intervalo de identificadores de glifo e os valores de geometria são validados antes de algo ser escrito. A geometria tem de ser finita, o que parece óbvio até um motor de moldagem entregar um avanço NaN vindo de uma fonte malformada
A falha é atómica ao nível da página. Se o carregamento da fonte, a escrita de objetos, a geração de conteúdo ou a verificação de extração falharem, todos os objetos inseridos por essa chamada são removidos por ordem inversa e o conteúdo da página é regenerado. Uma chamada falhada deixa a página como estava, não com meia sequência de texto nela
Onde isto se encaixa num pipeline de texto
Vale a pena declarar a divisão de trabalho com clareza. A moldagem — transformar carateres em glifos posicionados — não é trabalho desta API; pertence a um motor de moldagem, e o próprio suporte bidirecional e de escrita complexa do componente está descrito em tratamento de emoji, CJK e pares substitutos. Esta API é o que se chama depois, com a sequência de glifos que o moldador produziu
Para texto latino comum sem moldagem contextual, as APIs de texto mais simples, baseadas em strings, são a ferramenta certa e produzem código mais pequeno. Recorra à escrita CID Tipo 2 quando tiver saída moldada, quando precisar de controlo exato dos identificadores de glifo, ou quando a fonte tiver de ser incorporada a partir de bytes que já tem, em vez de ser resolvida pelo nome — sendo a alternativa de resolução de fontes o mecanismo de fornecedor descrito em controlar a substituição de fontes em PDF
Uma nota de implementação: incorporar uma fonte é uma questão de licenciamento tanto quanto técnica. As fontes variam quanto a permitirem, ou não, a incorporação, a permitirem-na apenas para visualização, ou a permitirem-na para edição. A biblioteca incorpora quaisquer bytes que lhe forneça, e verificar a licença é da sua responsabilidade, não do formato de ficheiro
A escrita de texto ao nível do glifo, o fornecimento de fontes e a extração de texto partilham o mesmo modelo de página em Delphi, C++Builder e Lazarus; a API completa está descrita na página do PDFium Component para Delphi