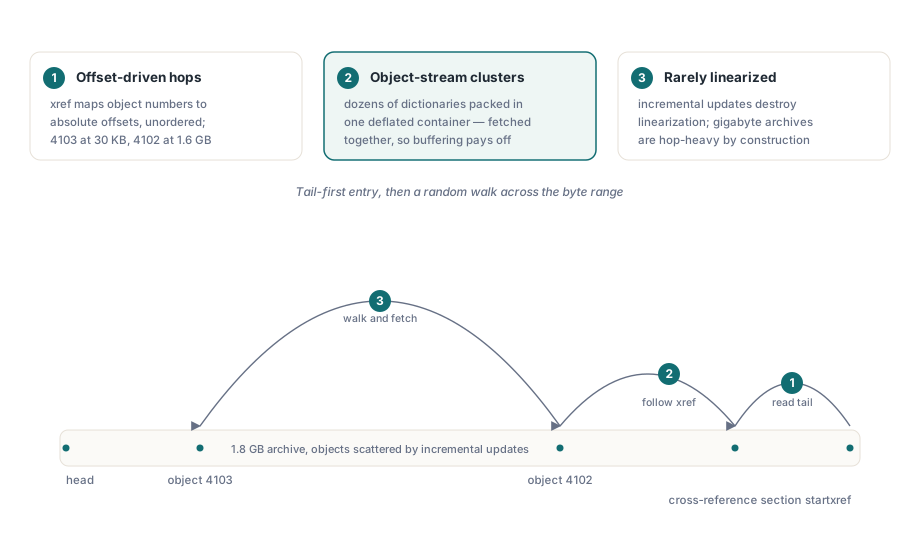
A primeira leitura útil de um parser de PDF está na ponta errada do ficheiro. O formato coloca o ponteiro startxref nos bytes finais, pelo que processar um arquivo de 1,8 GB começa com um seek até ao final, uma leitura de um kilobyte, e depois um salto para onde quer que a tabela de referência cruzada diga que reside o catálogo do documento. A partir daí, a análise é um percurso aleatório por todo o intervalo de bytes. Tudo aquilo em que a E/S com buffer é boa — leitura antecipada sequencial atrás do ponteiro de ficheiro — está orientado para uma carga de trabalho que o PDF não tem
A primeira versão deste artigo afirmava que um ficheiro mapeado em memória resolve a falha de memória insuficiente em 32 bits que o TMemoryStream atinge numa entrada de 2 GB. Essa afirmação está errada, e o modo como está errada aponta para a correção verdadeira: uma janela de mapeamento deslizante. O que se segue é o padrão de acesso, a história de 32 bits corrigida com um mapeador em janelas compilável, e a aritmética de syscalls num ficheiro de teste de 1,8 GB e 300.000 objetos
Porque é que o layout do PDF derrota as leituras com buffer
Três factos estruturais moldam o padrão de E/S. Primeiro, a navegação é orientada por deslocamento: a tabela de referência cruzada mapeia cada número de objeto para uma posição absoluta de bytes, e nada obriga a que essas posições estejam ordenadas. Após anos de atualizações incrementais, o objeto 4102 pode estar no deslocamento 1,6 GB enquanto o objeto 4103 está em 30 KB. Um ciclo TFileStream transforma cada acesso num Seek mais um Read, duas transições de kernel, com um buffer que não contribui em nada porque o próximo acesso está a centenas de megabytes de distância
Segundo, as streams de objeto (ISO 32000-1 §7.5.7) empacotam dezenas ou centenas de pequenos dicionários num único contentor deflated. Aceder a um dicionário de página de 300 bytes pode significar ler e inflar um cluster de 100 KB. O reverso da moeda: objetos escritos juntos tendem a ser lidos juntos, pelo que um buffer dimensionado para o cluster serve gratuitamente a próxima dúzia de acessos — a regularidade mais explorável do formato
Terceiro, a linearização. Um ficheiro linearizado coloca a primeira página e uma hint table logo no início, para que os consumidores o possam ler do princípio ao fim. Arquivos da ordem do gigabyte quase nunca estão linearizados: a linearização é destruída pelas mesmas atualizações incrementais e fusões que tornaram o ficheiro grande. Deve planear-se para o caso hostil: saltos longos, sem ordenação, entrada pelo final
A história de 32 bits, corrigida
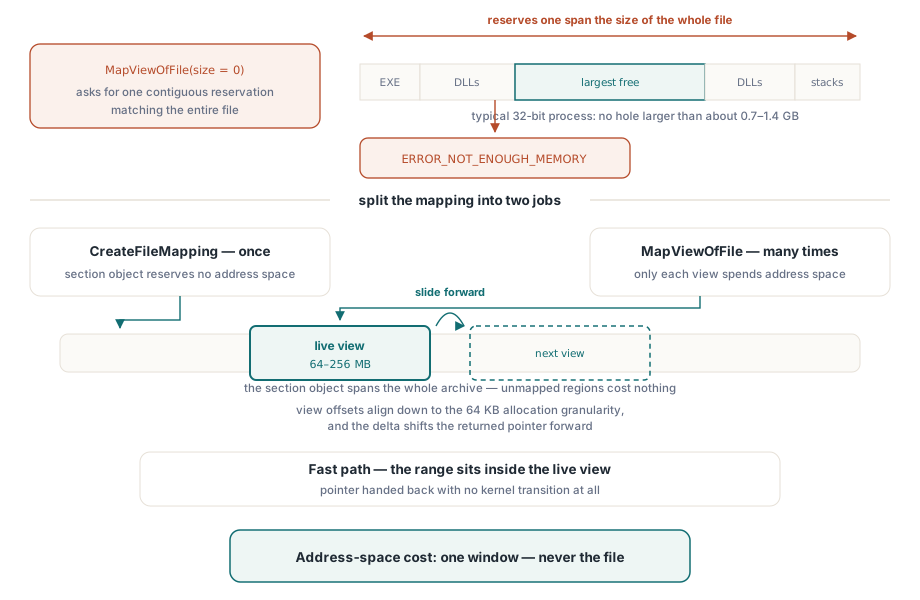
Um processo Windows de 32 bits tem 2 GB de espaço de endereçamento de utilizador, e o MapViewOfFile com uma contagem de bytes igual a zero pede uma reserva contígua do tamanho do ficheiro inteiro. Para uma entrada de 2 GB, essa reserva não pode ter sucesso: depois do EXE, das DLLs dispersas e das pilhas de threads, o maior bloco contíguo livre num processo Delphi de 32 bits típico situa-se algures entre 700 MB e 1,4 GB. A chamada falha com ERROR_NOT_ENOUGH_MEMORY, a mesma barreira em que o TMemoryStream.LoadFromFile esbarra, apenas deslocada de RAM confirmada para reserva de espaço de endereçamento. Um mapeamento do ficheiro completo não resolve nada em 32 bits, é apenas a mesma falha por trás de nomes de API com melhor aparência
A correção passa por separar as duas coisas que um mapeamento faz. O CreateFileMapping cria o objeto de secção e não custa espaço de endereçamento nenhum, seja qual for o tamanho do ficheiro. Só o MapViewOfFile gasta espaço de endereçamento, e nada o obriga a mapear a secção inteira: recebe um deslocamento inicial de 64 bits e um comprimento de vista. Deve criar-se a secção uma vez, mapear uma vista de 64 a 256 MB sobre a região a analisar, e desfazer o mapeamento antes de avançar: o custo em espaço de endereçamento é o de uma janela, não o de um ficheiro. Uma restrição: os deslocamentos de vista têm de ser múltiplos de SYSTEM_INFO.dwAllocationGranularity, na prática 64 KB, pelo que um pedido para o deslocamento 1.000.000 é arredondado por defeito para 983.040, e o ponteiro do chamador é ajustado para a frente pela diferença
Um mapeador de janela deslizante em Delphi
A classe abaixo encapsula toda esta disciplina: um objeto de secção, uma vista ativa, o realinhamento de granularidade, e leituras que atravessam um limite de janela tratadas fazendo crescer essa mesma vista em vez de unir duas
uses
  Winapi.Windows, System.SysUtils;

type
  TWindowedFileMapper = class
  private
    FFile: THandle;
    FMapping: THandle;
    FFileSize: Int64;
    FGranularity: DWORD;      // SYSTEM_INFO.dwAllocationGranularity
    FWindowSize: NativeUInt;  // tamanho de vista predefinido
    FViewBase: PByte;         // base da vista atual (alinhada)
    FViewOffset: Int64;       // deslocamento no ficheiro a que FViewBase corresponde
    FViewSize: NativeUInt;    // bytes mapeados na vista atual
    procedure Unmap;
  public
    constructor Create(const FileName: string;
      WindowSize: NativeUInt = 64 * 1024 * 1024);
    destructor Destroy; override;
    function Map(Offset: Int64; Size: NativeUInt): PByte;
    procedure ReadBytes(Offset: Int64; var Buffer; Count: NativeUInt);
    property FileSize: Int64 read FFileSize;
  end;

constructor TWindowedFileMapper.Create(const FileName: string;
  WindowSize: NativeUInt);
var
  Info: TSystemInfo;
begin
  inherited Create;
  FFile := CreateFile(PChar(FileName), GENERIC_READ, FILE_SHARE_READ, nil,
    OPEN_EXISTING, FILE_ATTRIBUTE_NORMAL, 0);
  if FFile = INVALID_HANDLE_VALUE then
    RaiseLastOSError;
  if not GetFileSizeEx(FFile, FFileSize) then
    RaiseLastOSError;
  // O objeto de secção não reserva espaço de endereçamento, seja qual for o tamanho do ficheiro
  FMapping := CreateFileMapping(FFile, nil, PAGE_READONLY, 0, 0, nil);
  if FMapping = 0 then
    RaiseLastOSError;
  GetSystemInfo(Info);
  FGranularity := Info.dwAllocationGranularity;  // na prática, 64 KB
  FWindowSize := WindowSize;
end;

destructor TWindowedFileMapper.Destroy;
begin
  Unmap;
  if FMapping <> 0 then CloseHandle(FMapping);
  if FFile <> INVALID_HANDLE_VALUE then CloseHandle(FFile);
  inherited;
end;

procedure TWindowedFileMapper.Unmap;
begin
  if FViewBase <> nil then
  begin
    UnmapViewOfFile(FViewBase);
    FViewBase := nil;
    FViewSize := 0;
  end;
end;

function TWindowedFileMapper.Map(Offset: Int64; Size: NativeUInt): PByte;
var
  AlignedOffset: Int64;
  Delta, MapSize: NativeUInt;
begin
  if (Offset < 0) or (Offset + Int64(Size) > FFileSize) then
    raise ERangeError.CreateFmt(
      'Map request at %d for %d bytes is outside the file',
      [Offset, Int64(Size)]);

  // Caminho rápido: o intervalo pedido já está dentro da vista ativa
  if (FViewBase <> nil) and (Offset >= FViewOffset) and
     (Offset + Int64(Size) <= FViewOffset + Int64(FViewSize)) then
    Exit(FViewBase + NativeInt(Offset - FViewOffset));

  Unmap;  // deslizar: nunca manter duas vistas ao mesmo tempo

  // As vistas têm de começar num limite de granularidade de alocação
  AlignedOffset := Offset - (Offset mod FGranularity);
  Delta := NativeUInt(Offset - AlignedOffset);

  MapSize := FWindowSize;
  if MapSize < Size + Delta then   // o pedido ultrapassa o final da janela:
    MapSize := Size + Delta;       // aumenta-se esta vista para o cobrir
  if AlignedOffset + Int64(MapSize) > FFileSize then
    MapSize := NativeUInt(FFileSize - AlignedOffset);  // limitar ao EOF

  FViewBase := MapViewOfFile(FMapping, FILE_MAP_READ,
    DWORD(AlignedOffset shr 32), DWORD(AlignedOffset and $FFFFFFFF),
    MapSize);
  if FViewBase = nil then
    RaiseLastOSError;

  FViewOffset := AlignedOffset;
  FViewSize := MapSize;
  Result := FViewBase + NativeInt(Delta);
end;

procedure TWindowedFileMapper.ReadBytes(Offset: Int64; var Buffer;
  Count: NativeUInt);
begin
  Move(Map(Offset, Count)^, Buffer, Count);
end;
Dois detalhes é que fazem a diferença. O caminho rápido no topo de Map devolve um ponteiro sem qualquer transição de kernel quando o intervalo pedido já está dentro da vista ativa; graças ao agrupamento em streams de objeto, este é o caso comum e é daí que vêm as poupanças. E um pedido que ultrapassa o final da janela predefinida faz crescer o MapSize para essa única vista, em vez de unir duas, o que mantém o ReadBytes numa única linha e liberta quem chama de ciclos de leitura parcial
O tamanho da janela é um parâmetro tolerante: a 64 MB, uma varredura completa de um ficheiro de 1,8 GB corresponde a 29 vistas; a 256 MB são 8, mas cada reserva é mais difícil de encaixar num espaço de 32 bits fragmentado; e abaixo de cerca de 16 MB, ficheiros com muitos saltos remapeiam com frequência suficiente para se notar. Em qualquer ponto do intervalo entre 64 e 256 MB, o tráfego de mapeamento é ruído estatístico
Contar as syscalls
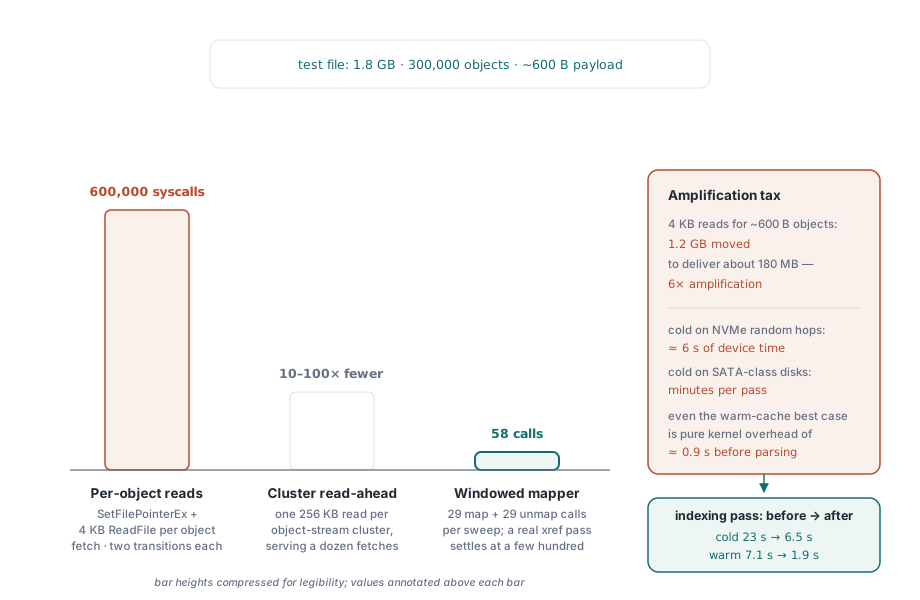
Agora, a aritmética. Ficheiro de teste: 1,8 GB, 300.000 objetos indiretos com uma média de cerca de 600 bytes de payload. Um parser por objeto acede a cada um com SetFilePointerEx mais um ReadFile de 4 KB: 600.000 transições de kernel. Uma syscall de leitura em cache tem um round-trip de aproximadamente 1,5 μs no hardware x64 atual, o que dá 600.000 × 1,5 μs ≈ 0,9 segundos de puro overhead de kernel antes de analisar um único byte — o melhor cenário possível, com a cache quente. A frio, cada salto é uma operação de dispositivo: com a latência efetiva de ~20 μs das leituras aleatórias de 4 KB em NVMe, 300.000 delas custam cerca de 6 segundos de tempo de dispositivo; em armazenamento de classe SATA, minutos
As leituras também movem os dados errados: 300.000 × 4 KB empurram 1,2 GB através de buffers de utilizador para entregar apenas cerca de 180 MB de payload — uma amplificação de seis vezes, com cada byte copiado do kernel para o utilizador
Um buffer de leitura antecipada dimensionado para os clusters de streams de objeto é a primeira melhoria honesta: uma leitura de 256 KB por cluster, em vez de uma por objeto, reduz a contagem de transições em uma a duas ordens de grandeza. É também a ferramenta certa onde o mapeamento é incómodo, normalmente em partilhas de rede
O mapeador em janelas vai mais longe. Uma varredura completa corresponde a 29 chamadas MapViewOfFile e 29 chamadas UnmapViewOfFile, 58 transições explícitas contra 600.000. Uma análise real orientada por xref não é uma varredura limpa, mas o caminho rápido absorve todos os acessos dentro da janela ativa; uma passagem de indexação de metadados sobre o arquivo de teste estabilizou em algumas centenas de remapeamentos. O mapeamento não elimina o trabalho de kernel: converte syscalls explícitas em page faults que o gestor de memória resolve em clusters de várias páginas, diretamente a partir da cache de ficheiros, sem cópia para espaço de utilizador, e regiões nunca tocadas não custam nada. De ponta a ponta, a passagem de indexação passou de 23 s a frio e 7,1 s a quente com leituras por objeto, para 6,5 s a frio e 1,9 s a quente com o mapeador; o que resta é o inflate do zlib, não a E/S
Onde encaixa o FILE_FLAG_NO_BUFFERING
O FILE_FLAG_NO_BUFFERING ignora a cache do sistema em troca de regras rígidas de alinhamento: deslocamentos, comprimentos e endereços de buffer todos alinhados por setor. Compensa em trabalhos sequenciais de passagem única que, de outro modo, inundariam a cache com bytes que ninguém volta a ler — uma reserialização em lote que reescreve todo o arquivo, ou uma passagem de linearização sobre a saída já concluída. Com buffers alinhados de 4 a 8 MB, aproxima-se da largura de banda sequencial do dispositivo sem poluir a cache
É exatamente o errado para a análise. Saltos aleatórios na xref através de um handle sem buffer transformam cada acesso a um dicionário de 300 bytes numa leitura física completa, sem cache para absorver a segunda visita — e a análise de PDF revisita regiões constantemente, porque páginas diferentes resolvem para as mesmas streams de objeto. E/S sem buffer para a reescrita sequencial, E/S mapeada ou em cache para a análise aleatória; a flag é definida por handle, pelo que um mesmo pipeline pode ter as duas no mesmo ficheiro
64 bits, working sets e o lado da escrita
Numa compilação de 64 bits, a objeção do espaço de endereçamento desaparece: basta passar o tamanho do ficheiro como janela, e a classe acima degenera num único mapeamento completo. O senão nos serviços de longa duração: páginas só de leitura, apoiadas em ficheiro, não consomem commit, pelo que os contadores de commit permanecem calmos, mas toda a página tocada entra para o working set; ao analisar a maior parte de 1,8 GB, o working set cresce na mesma proporção, expulsando tudo o resto. Janelas limitadas impõem um teto a isso, pelo que o padrão deslizante continua a ser a opção correta por defeito, mesmo onde o espaço de endereçamento é gratuito
Do lado da escrita, a E/S mais barata é aquela que nunca é emitida. O mecanismo de atualização incremental do PDF (ISO 32000-1 §7.5.6) anexa os objetos alterados e uma nova secção de referência cruzada depois dos bytes originais, que nunca se movem. Carimbar uma página no arquivo de 1,8 GB anexa dezenas de kilobytes; uma reescrita completa move todos os 1,8 GB, cinco ordens de grandeza de diferença, e a anexação é saída sequencial pura no final
Onde encaixam as bibliotecas da losLab
Ambas as bibliotecas de PDF da losLab oferecem esta disciplina como superfície de API. A HotPDF Direct File API lê contagens de páginas e estrutura através de um handle de ficheiro sem construir a árvore de objetos, copia e desencripta ao nível do ficheiro, e escreve deltas através de BeginIncrementalUpdate — a estratégia apenas de anexação descrita acima, já empacotada. A PDF Library for Delphi segue o mesmo caminho com a sua camada de Direct Access: um leitor em streaming que percorre a tabela de referência cruzada no próprio local, acede a objetos de forma preguiçosa, extrai intervalos de páginas de ficheiro para ficheiro, e persiste edições como revisões incrementais. Quem estiver a escrever o seu próprio parser pode ficar com a classe do mapeador; quem estiver a correr um pipeline de documentos pode deixar que seja a biblioteca a manter a janela honesta
Nota: o tratamento otimizado de E/S para documentos à escala do gigabyte está integrado diretamente no HotPDF Delphi VCL Component para Delphi e C++Builder