Um pipeline de receção de documentos aceita ficheiros escritos por desconhecidos. Faturas, digitalizações, anexos de um formulário web: cada um declara ser um PDF e transporta centenas de números que se espera que o analisador utilize. Comprimentos de fluxo, dimensões de imagem, deslocamentos em bytes, referências de objetos — cada um foi escolhido por quem produziu o ficheiro, e um envio truncado ou um documento deliberadamente malformado acabará por colocar um desses números num local onde causa danos. A diferença entre um analisador que sobrevive a esse ficheiro e um que bloqueia, ou continua a correr com memória corrompida, é um pequeno conjunto de hábitos que não dependem de nenhuma biblioteca PDF em particular
Estes hábitos partilham uma premissa: um valor lido do ficheiro é uma alegação, não uma medição. Só se torna utilizável depois de ser confrontado com algo que o próprio analisador mediu — o tamanho real do ficheiro, o número real de bytes que um descodificador produziu, a profundidade real de uma recursão. O que se segue é essa premissa aplicada aos pontos onde os analisadores de documentos realmente falham
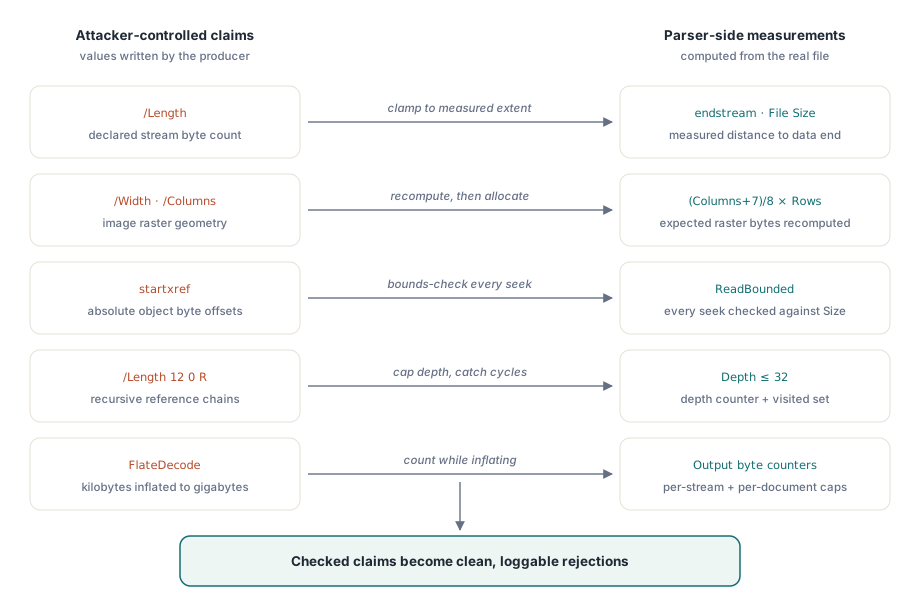
Um comprimento declarado é uma alegação, não uma medição
A discrepância mais simples é o comprimento do fluxo. Um objeto de fluxo PDF declara a sua contagem de bytes na chave /Length, e os dados reais situam-se entre as palavras-chave stream e endstream. Nada obriga as duas a coincidir. Um ficheiro truncado contém menos bytes reais do que a contagem declarada; um ficheiro de um gerador com falhas pode declarar um comprimento que ultrapassa o final do ficheiro ou invade um objeto vizinho. Alocar a partir do valor declarado e copiar até endstream provoca um transbordo do buffer; ler exatamente a contagem declarada sem verificar a disponibilidade faz sair do final do ficheiro. O valor declarado só deve controlar a alocação depois de ser limitado à distância medida até ao final dos dados, e uma discrepância deve ser tratada como um ponto de decisão — reparar procurando endstream, ou rejeitar o fluxo — nunca como algo a aceitar silenciosamente
Parâmetros de imagem que descrevem um raster maior do que o alocado
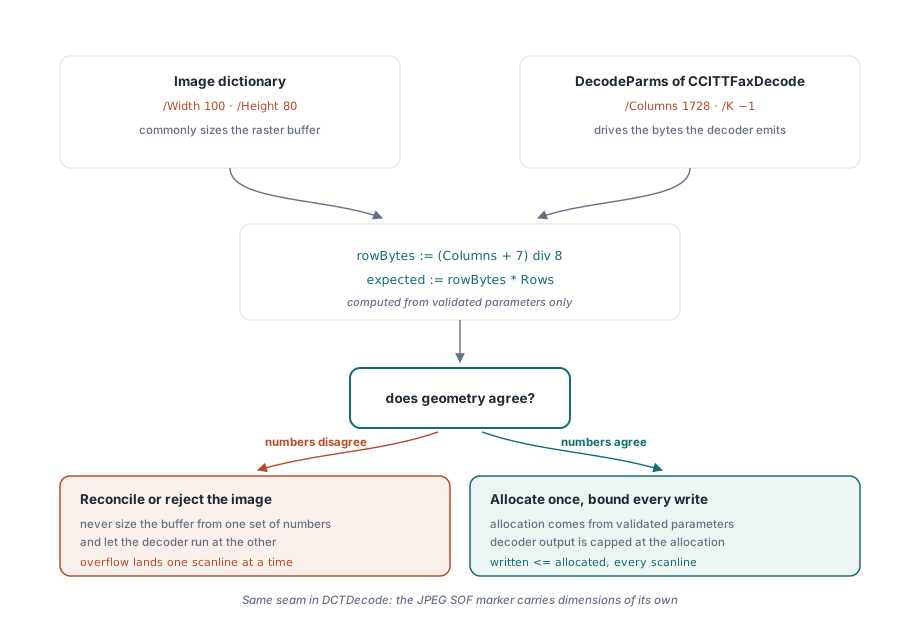
Os fluxos de imagem elevam a fasquia porque dois conjuntos independentes de números descrevem os mesmos píxeis. O dicionário de imagem transporta /Width e /Height, e os buffers de raster são normalmente dimensionados a partir destes. O filtro de descodificação transporta a sua própria geometria: o CCITTFaxDecode obtém /Columns, /Rows e /K a partir do seu DecodeParms, em que /K seleciona o esquema de Grupo 3 ou Grupo 4 e o descodificador emite (Columns + 7) div 8 bytes por linha de varrimento. Um ficheiro que declare /Width 100 mas entregue ao filtro /Columns 1728 — o valor predefinido — faz com que o descodificador produza mais de dezasseis vezes os bytes por linha que o buffer espera, e o transbordo cai, uma linha de varrimento de cada vez, no que estiver a seguir à alocação. Quando /Rows está ausente, o descodificador corre até os dados indicarem paragem, pelo que a contagem de linhas também deve ser limitada. O DCTDecode tem a mesma falha: os dados JPEG transportam a sua própria largura e altura no marcador SOF, e nada obriga a que coincidam com o dicionário
A regra defensiva é mecânica: calcular o tamanho de raster esperado a partir dos parâmetros de descodificação validados — os próprios /Columns e /Rows do filtro para CCITT, as dimensões do SOF para DCT — confrontá-lo com os limites definidos, alocar a partir dele e verificar durante a descodificação que a saída nunca ultrapassa a alocação. Quando o dicionário e o filtro discordam quanto à geometria, devem reconciliar-se ou a imagem deve ser rejeitada. O que um analisador nunca deve fazer é dimensionar o buffer a partir de um conjunto de números e deixar o descodificador correr segundo o outro
Armadilhas de aritmética e alocação em Delphi
Três comportamentos do Delphi comprometem mesmo um analisador que pretenda validar. O primeiro é a multiplicação em 32 bits: o Delphi avalia o produto de dois operandos Integer em 32 bits, independentemente da largura do destino, pelo que Width * Height * BytesPerPixel pode dar a volta mesmo quando cada fator passa a sua própria verificação de sanidade. Uma digitalização de 30000 por 30000 a três bytes por pixel dá 2,7 mil milhões de bytes, o que dá a volta para negativo em aritmética de 32 bits com sinal; fatores ligeiramente diferentes dão a volta para um comprimento positivo pequeno que é alocado e subdimensiona o buffer. Deve forçar-se toda a expressão a operar em largura maior convertendo o primeiro operando — Size := Int64(Width) * Height * BytesPerPixel — e só depois comparar com um limite explícito antes de algo chegar a SetLength
O segundo é a verificação de intervalos. A configuração de release predefinida do Delphi vem com esta verificação desligada, pelo que um índice fora do intervalo calculado a partir de dados do ficheiro não gera uma exceção — lê ou escreve memória adjacente ao array. Deve reativar-se com {$R+} (e {$Q+} para overflow aritmético) no topo de cada unidade que indexa com valores derivados do ficheiro. O custo é imensurável face à E/S que um analisador já faz de qualquer forma, e converte corrupção silenciosa num ERangeError detetável
O terceiro é o TMemoryStream.SetSize com um Int64 fornecido pelo ficheiro. Numa RTL atual, aloca o que quer que o ficheiro tenha pedido, pelo que um único fluxo que alegue quatro gigabytes se torna uma falha de falta de memória a meio da receção. Em RTL mais antigas, onde o SetSize recebe um Longint, o valor é primeiro estreitado silenciosamente: um valor declarado de $100000010 torna-se 16, a alocação é bem-sucedida, e a escrita dos dados reais avança muito para lá dela. Cada tamanho deve ser validado contra o tamanho medido da origem e um limite rígido antes de qualquer chamada de alocação o ver
Deslocamentos que apontam para fora do ficheiro
A tabela de referência cruzada associa números de objeto a deslocamentos absolutos em bytes, e o analisador posiciona-se onde quer que ela indique. Num ficheiro danificado ou hostil, esses deslocamentos caem para lá do final do ficheiro ou dentro de estruturas sem relação. O TStream torna a falha silenciosa: definir Position para lá de Size não é um erro, e um simples Read para lá do final limita-se a devolver menos bytes do que os pedidos, pelo que código que dispense a verificação da contagem continua a processar bytes obsoletos do objeto anterior. A defesa é um ponto de estrangulamento — um único auxiliar através do qual passam todos os posicionamentos e leituras conduzidos pelo ficheiro, validando o deslocamento e a contagem contra o tamanho medido do ficheiro antes de o fluxo se mover
uses
  System.SysUtils, System.Classes;

const
  MAX_OBJECT_BYTES = 64 * 1024 * 1024; // nenhum objeto isolado pode exceder 64 MB

type
  EPdfBoundsError = class(Exception);

// Todos os posicionamentos e leituras conduzidos pelo ficheiro passam por aqui. Offset e Count são
// alegações fornecidas pelo ficheiro; Source.Size é a medição a que têm de caber.
procedure ReadBounded(Source: TStream; Offset, Count: Int64;
  var Buffer: TBytes);
begin
  if (Offset < 0) or (Count < 0) or (Count > MAX_OBJECT_BYTES) or
     (Offset > Source.Size) or (Count > Source.Size - Offset) then
    raise EPdfBoundsError.CreateFmt(
      'object extent %d+%d exceeds file size %d',
      [Offset, Count, Source.Size]);
  SetLength(Buffer, Count);
  if Count = 0 then
    Exit;
  Source.Position := Offset;
  Source.ReadBuffer(Buffer[0], Count);
end;
Encaminhando os deslocamentos de referência cruzada, as extensões de fluxo e as leituras de ficheiros incorporados por aqui, um deslocamento inválido transforma-se numa rejeição limpa que identifica os números, em vez de uma violação de acesso três chamadas depois
Ciclos e profundidade no grafo de objetos
Um PDF é um grafo, não uma árvore. Qualquer valor pode ser uma referência indireta, uma referência pode resolver-se noutra referência — /Length 12 0 R, em que o objeto 12 contém 13 0 R — e nada impede que uma cadeia se feche sobre si própria. Um resolvedor que siga referências de forma ingénua recorre até a pilha nativa se esgotar, e o esgotamento da pilha não é algo que se consiga apanhar; termina o processo. Arrays e dicionários profundamente aninhados chegam ao mesmo fim sem qualquer ciclo
Devem usar-se duas proteções em conjunto: um contador explícito de profundidade limita o caso honesto-mas-profundo a um limiar a que nenhum ficheiro legítimo se aproxima, e um conjunto de visitados apanha um ciclo genuíno na sua segunda visita, transformando-o num erro preciso e reportável em vez de um simples disparo de limite
uses
  System.SysUtils, System.Generics.Collections;

const
  MAX_RESOLVE_DEPTH = 32; // muito mais profundo do que qualquer cadeia de referências legítima

type
  EPdfStructureError = class(Exception);

  TPdfValueKind = (pvNull, pvNumber, pvName, pvString, pvArray,
    pvDictionary, pvStream, pvReference);

  TPdfValue = record
    Kind: TPdfValueKind;
    RefNumber: Integer; // relevante quando Kind = pvReference
    // ... campos de dados para os restantes tipos
  end;

// LoadObject é uma rotina própria: procura o deslocamento xref para
// ObjNumber, lê o objeto com ReadBounded e analisa-o.
function ResolveObject(ObjNumber, Depth: Integer;
  Visited: TDictionary<Integer, Boolean>): TPdfValue;
begin
  if Depth > MAX_RESOLVE_DEPTH then
    raise EPdfStructureError.Create('reference chain exceeds depth limit');
  if Visited.ContainsKey(ObjNumber) then
    raise EPdfStructureError.CreateFmt(
      'circular reference through object %d', [ObjNumber]);
  Visited.Add(ObjNumber, True);
  try
    Result := LoadObject(ObjNumber);
    if Result.Kind = pvReference then // p. ex. /Length 12 0 R
      Result := ResolveObject(Result.RefNumber, Depth + 1, Visited);
  finally
    Visited.Remove(ObjNumber); // irmãos podem legitimamente partilhar este objeto
  end;
end;
A descompressão é um amplificador
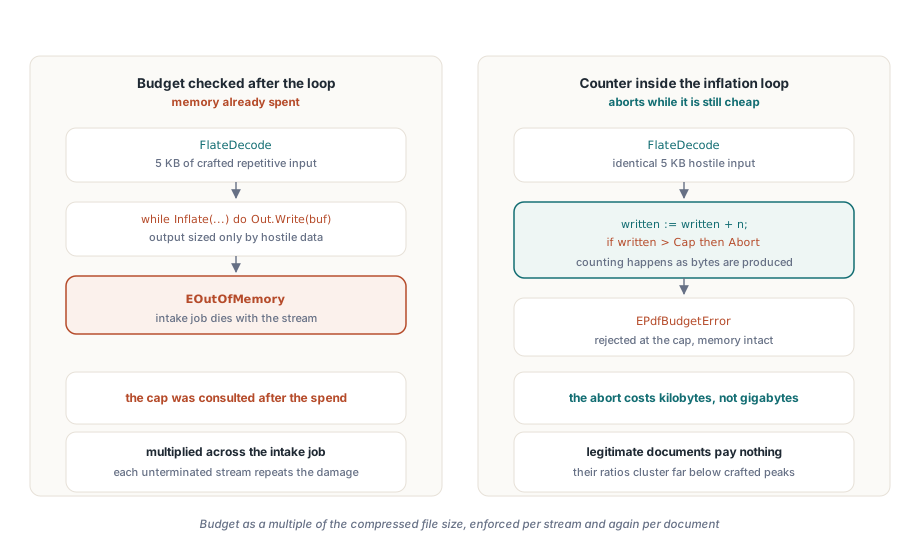
Uns poucos kilobytes de entrada FlateDecode podem inflacionar para gigabytes; a compressão de uso geral recompensa texto simples repetitivo, e um atacante pode torná-lo maximamente repetitivo. O tamanho inflacionado de cada fluxo deve ser limitado ao que o seu consumidor pode plausivelmente necessitar, mantendo também um segundo orçamento por documento: quinhentos fluxos, cada um mesmo abaixo do limite por fluxo, esgotam a memória tão certamente como um único fluxo gigante. A verificação pertence dentro do ciclo de inflação, contando os bytes de saída à medida que são produzidos e abortando em caso de violação, não depois do ciclo, quando a memória já foi gasta. Um orçamento por documento expresso como um múltiplo do tamanho do ficheiro comprimido funciona bem, uma vez que os documentos legítimos se concentram bem abaixo dos rácios que um fluxo forjado alcança
Defesa em profundidade para além das próprias unidades
As mesmas classes de falhas existem dentro das bibliotecas. Dois estudos de caso neste blog percorrem instâncias reais: as voltas de inteiros, a recursão sem limite e os buffers não inicializados corrigidos num motor Pascal nativo em Reforçar a Segurança de um Analisador de PDFs em Pascal Contra Ficheiros Maliciosos, e os riscos de convenção de chamada, largura de inteiros e propriedade de memória ao vincular um motor C em Reforçar um Binding do Componente PDFium: ABI e Segurança de Memória. Para receção genuinamente não confiável — um formulário público de envio, uma caixa de correio não autenticada — convém também correr o trabalho de análise e descodificação num processo separado com privilégios reduzidos, para que o ficheiro que derrota todas as proteções dentro do processo custe apenas uma tarefa falhada, em vez de um serviço em baixo
Uma lista de verificação preliminar
Antes do lançamento da próxima compilação, deve confrontar-se o analisador com esta lista: cada buffer de fluxo dimensionado a partir de um comprimento limitado e não do declarado; cada raster dimensionado a partir de parâmetros de descodificador validados e confrontado com a saída do descodificador; cada produto de dimensões avaliado em Int64 e comparado com um limite explícito; {$R+} ativo em cada unidade que indexa com valores derivados do ficheiro; cada posicionamento verificado contra o tamanho medido do ficheiro; cada resolução de referência limitada em profundidade e verificada quanto a ciclos; cada ciclo de inflação a contar a saída face a orçamentos por fluxo e por documento. Nenhuma destas verificações custa tempo mensurável num documento legítimo, e cada uma converte corrupção de memória numa rejeição limpa e registável
Nota: o HotPDF Delphi Component, a PDF Library for Delphi Delphi PDF Library e o PDFium Component da losLab aplicam internamente estas verificações de limites, limites de profundidade e tetos de expansão, pelo que um pipeline de receção construído sobre eles parte de uma base já reforçada