Um trabalho de relatórios corre bem durante um ano. Constrói uma pasta de trabalho, enche uma folha com o que a consulta devolver, e guarda-a. Depois um cliente com cinco anos de histórico pede uma exportação completa, a contagem de linhas ultrapassa o milhão, e o processo morre com um erro de memória esgotada muito antes de o ficheiro chegar ao disco. Não havia nada de errado com o código. Ele mantinha a pasta de trabalho inteira em RAM para a poder serializar no fim, e a memória de que precisava crescia a par do número de linhas que lhe pediam para escrever
A solução não é uma máquina maior. É um modelo de escrita diferente. O escritor direto em fluxo do HotXLS emite o pacote OOXML de forma incremental à medida que as linhas chegam, pelo que a memória que usa não depende de quantas linhas escreve. É o equivalente do lado da escrita ao leitor em fluxo: onde o leitor percorre uma folha enorme sem construir uma árvore de células, o escritor produz uma sem construir também nenhuma árvore de células
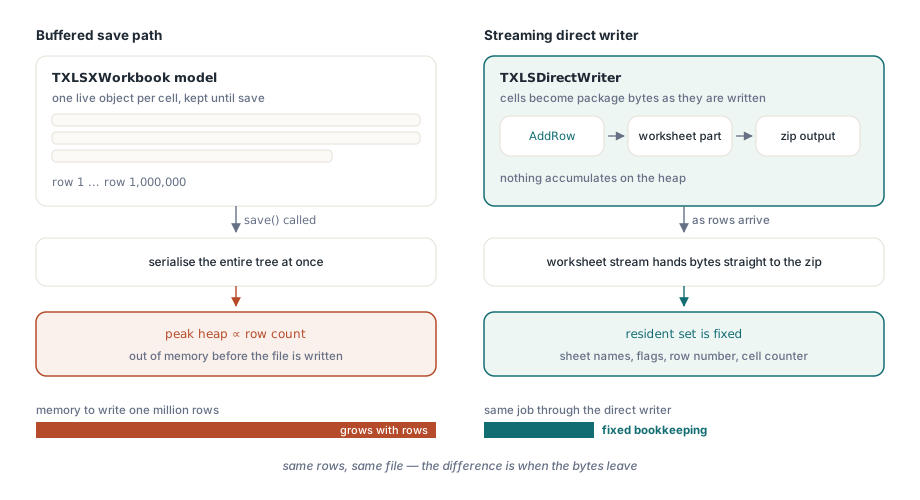
Por que razão o caminho normal de gravação cresce com os dados
O caminho habitual do TXLSXWorkbook constrói primeiro um modelo de objetos completo. Cada célula, com o seu valor, tipo e referência de estilo, vive como um objeto em memória até chamar a gravação, momento em que a árvore inteira é serializada para o pacote. Esse modelo é o correto quando quer ler uma folha, editá-la, recalcular e voltar a escrevê-la, porque o acesso aleatório a qualquer célula é exatamente aquilo de que a edição precisa. É o modelo errado quando está a despejar linhas numa só direção e nunca olha para trás, porque paga para manter cada linha residente sem benefício nenhum. Um milhão de linhas de objetos é um milhão de linhas de objetos, quer volte a visitá-las quer não
O escritor em fluxo elimina a árvore. Assim que uma célula é escrita torna-se bytes na parte da folha de cálculo, e esses bytes são entregues à saída zip. O fluxo da folha de cálculo é a única memória intermédia que cresce, e cresce do lado da saída, não como objetos Delphi vivos na heap. O que fica residente é uma quantidade fixa de contabilidade: os nomes das folhas, algumas flags, o número da linha atual, um contador de células. Esse conjunto não muda entre a linha um e a linha dez milhões
A tabela de strings partilhadas é a armadilha, e as strings inline são a saída
A maioria dos escritores de XLSX em fluxo porta-se bem até se encontrar com texto. O formato OOXML guarda normalmente as strings numa tabela de strings partilhadas: cada string distinta é escrita uma vez numa parte separada, e cada célula que contém essa string transporta um índice para a tabela em vez do texto. É uma boa otimização de espaço para ficheiros cheios de etiquetas repetidas, e é o comportamento por omissão do caminho de gravação padrão. O problema para um escritor em fluxo é brutal. Para eliminar duplicados, a tabela tem de ficar residente durante todo o trabalho, porque qualquer linha ainda por vir pode repetir uma string de uma linha já escrita, e só um mapa completo em memória das strings já vistas consegue atribuir o índice certo. Ou seja, a única estrutura que um escritor em fluxo não consegue transmitir é justamente a estrutura que devia tornar o ficheiro pequeno. Dados com muito texto derrotam o streaming que veio buscar
O escritor direto contorna a tabela por completo. As strings são escritas inline, como células t="inlineStr" cujo texto assenta diretamente dentro da célula num elemento <is><t>. Não há tabela para acumular nem mapa de strings vistas para reter, pelo que as colunas de texto não custam mais memória do que as numéricas. A troca é explícita e vale a pena dizê-la sem rodeios. As strings inline repetem o mesmo texto sempre que ele ocorre, pelo que um ficheiro com muitas etiquetas idênticas fica maior em disco do que o equivalente com strings partilhadas. Gasta tamanho de ficheiro para comprar memória constante. Para uma exportação de uma só passagem esse é o lado certo da troca, e a compressão zip absorve de qualquer modo grande parte da repetição à saída

A tabela de estilos chega no fim, com um formato de data
Os estilos apresentam a mesma tensão que as strings. Uma pasta de trabalho referencia a sua formatação através de uma parte de estilos, e um escritor em fluxo não consegue manter uma paleta de estilos em crescimento a par de células que já despachou. O escritor direto responde a isto mantendo a tabela de estilos pequena e fixa, e emitindo-a no fecho em vez de à partida. Um formato de célula por omissão cobre as células vulgares. Um formato numérico de data cobre as datas, registado com um código de formato yyyy-mm-dd numa posição conhecida da lista de formatos de célula
Esse formato de data é a razão de WriteDateTime existir como chamada própria. O Excel não tem tipo de data nativo; uma data é um número vestido com um formato de data. WriteDateTime escreve o valor como número de série simples e etiqueta a célula com o único estilo de data, para que a folha de cálculo a apresente como data em vez de um inteiro de cinco dígitos. O número de série que escreve importa para a ida e volta. Guarda o valor TDateTime diretamente ao abrigo do sistema de datas de 1900, que é a mesma convenção usada pelo caminho de gravação normal do TXLSXWorkbook. Como ambos os caminhos concordam quanto ao número de série, um ficheiro produzido pelo escritor em fluxo lê-se de volta através do leitor do HotXLS e abre no Excel com datas que correspondem ao que pretendia, sem surpresas de época ou de um dia de desvio entre o escritor e o leitor
A ordem é obrigatória, porque os bytes já se foram
O streaming paga o seu perfil de memória com uma regra que tem de respeitar. A saída é emitida à medida que avança e não pode ser revisitada, pelo que tudo tem de ser escrito pela ordem em que aparece no ficheiro. Dentro de uma linha, as células vão por ordem crescente de coluna. Dentro de uma folha, as linhas vão por ordem crescente. Não há memória intermédia que permita ao escritor ordenar as suas células a posteriori, porque a linha que fechou há instantes já são bytes no fluxo zip e deixou de estar acessível. Passe-lhe a coluna 5 e depois a coluna 2 na mesma linha e a saída fica malformada, já que o escritor se limita a emitir o que lhe der pela sequência em que lho der
A API de linhas tem uma pequena comodidade para o caso comum. AddRow recebe um índice de linha baseado em um, mas passar 0 significa avança para a linha seguinte à anterior, pelo que um preenchimento sequencial não tem de acompanhar e passar um contador incremental. Cada AddRow fecha a linha anterior, e cada AddSheet fecha a folha anterior, pelo que nunca termina explicitamente uma linha ou uma folha. Começa a seguinte e o escritor finaliza por si a estrutura aberta

O escape é tratado onde o texto entra no XML
Qualquer texto que escreva passa a fazer parte de um documento XML, pelo que as cinco entidades XML predefinidas têm de ser escapadas ou o pacote fica inválido no momento em que um valor contiver um E comercial ou um sinal de menor. O escritor escapa por si &, <, >, " e ' tanto no texto de strings inline como no texto de fórmulas, os dois sítios onde carateres fornecidos por quem chama aterram dentro da marcação. Passa uma WideString em bruto e o escritor torna-a segura. Um nome de produto como Smith & Co <Ltd> ou uma fórmula que referencia um nome de folha entre aspas sai como XML bem formado sem qualquer escape do seu lado
Ciclo de vida, e por que razão Destroy ainda fecha
Terminar o pacote é o que escreve a parte da pasta de trabalho, a parte de estilos, as partes de tipos de conteúdo e de relações, e por fim o diretório central do zip. Esse trabalho acontece em Close. Um pacote que nunca é fechado é um zip incompleto que nenhum programa de folha de cálculo abrirá, pelo que fechar não é uma limpeza opcional, é o passo que torna o ficheiro válido. Para proteger contra um Close esquecido num caminho de erro, Destroy executa um fecho de melhor esforço se o pacote ainda estiver aberto, pelo que libertar o escritor não fuga o objeto zip subjacente mesmo quando uma exceção saltou a chamada explícita. O padrão fiável continua a ser o de Delphi de sempre: escrever dentro de um try, chamar Close, e libertar no finally
Transmitir uma folha grande de ponta a ponta
A forma do trabalho é começar, acrescentar uma folha, despejar linhas, fechar. O exemplo abaixo escreve uma linha de cabeçalho e depois uma longa sequência de linhas de dados tipados, misturando strings, números, uma fórmula sem resultado em cache, e uma data. A memória que usa para dez linhas e para dez milhões de linhas é a mesma, porque cada célula parte para o fluxo zip assim que é escrita
uses
  lxDirectWrite;

procedure StreamReport(const Path: string; RowCount: Integer);
var
  W: TXLSDirectWriter;
  I: Integer;
begin
  W := TXLSDirectWriter.Create;
  try
    W.BeginFile(Path);
    W.AddSheet('Sales');

    // Linha de cabeçalho, escrita por ordem crescente de coluna
    W.AddRow(1);
    W.WriteString(1, 'Item');
    W.WriteString(2, 'Qty');
    W.WriteString(3, 'Price');
    W.WriteString(4, 'Total');
    W.WriteString(5, 'Date');

    // Linhas de dados; passe 0 a AddRow para avançar automaticamente
    for I := 1 to RowCount do
    begin
      W.AddRow(0);
      W.WriteString(1, 'Item ' + IntToStr(I));
      W.WriteNumber(2, I);
      W.WriteNumber(3, 1.5 + (I mod 10));
      W.WriteFormula(4, Format('B%d*C%d', [I + 1, I + 1]));
      W.WriteDateTime(5, EncodeDate(2026, 1, 1) + I);
    end;

    W.Close;                       // finaliza o pacote
  finally
    W.Free;
  end;
end;
Uma segunda folha é simplesmente outro AddSheet antes de continuar, e o escritor fecha a primeira folha ao abrir a segunda. As flags booleanas usam WriteBoolean, que escreve uma célula booleana tipada em vez do texto "True". Se quiser confirmar que o ficheiro está são e faz a ida e volta, a propriedade CellCount reporta quantas células foram escritas, e ler o resultado de volta com o leitor em fluxo deve reportar o mesmo total
  // Uma segunda folha de flags tipadas depois da folha de dados acima
  W.AddSheet('Flags');
  W.AddRow(1);
  W.WriteString(1, 'Name');
  W.WriteString(2, 'Active');
  W.AddRow(0);
  W.WriteString(1, 'alpha');
  W.WriteBoolean(2, True);

  WriteLn(Format('wrote %d cells', [W.CellCount]));
Escrever para um fluxo em vez de um ficheiro é o mesmo código com BeginStream no lugar de BeginFile, o que permite a um servidor enviar a pasta de trabalho para uma resposta HTTP ou para um fluxo em memória sem ficheiro temporário em disco. O escritor não é dono do fluxo que lhe passa, pelo que mantém o controlo do tempo de vida dele
Quando o trabalho é um ponto de acesso de servidor que constrói pastas de trabalho a pedido, os padrões em escritas em fluxo para trabalhos de servidor e em lote mostram como ligar isto a um handler de pedidos e a uma exportação agendada. Quando a questão é o custo mais amplo de pastas de trabalho muito grandes, tanto a ler como a escrever, desempenho com pastas de trabalho grandes em Delphi cobre para onde vão realmente o tempo e a memória. O escritor direto em fluxo é fornecido como parte do HotXLS Delphi Component para Delphi e C++Builder, a par das APIs completas de leitura, edição e gravação abordadas noutros pontos deste blogue