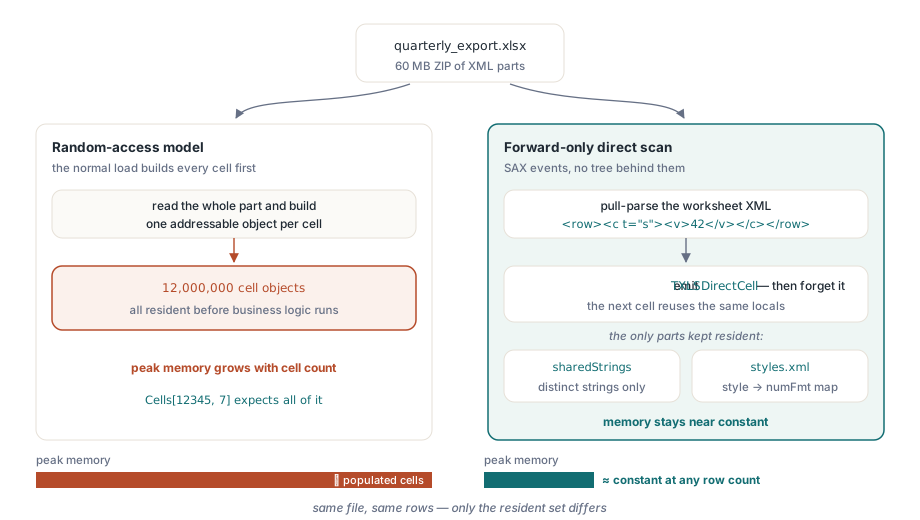
Uma folha de cálculo com um milhão de linhas e uma dúzia de colunas é uma exportação perfeitamente banal de um trabalho de relatórios sobre uma base de dados. Abra-a da forma habitual, carregando a pasta de trabalho inteira para um TXLSWorkbook, e o processo tem de materializar cada uma dessas doze milhões de células como um objeto vivo antes de correr a sua primeira linha de lógica de negócio. O ficheiro em disco pode ter sessenta megabytes de XML comprimido. A árvore de objetos em que se expande é várias vezes maior, e tem toda de estar residente ao mesmo tempo porque o modelo é de acesso aleatório por conceção. Para um relatório que tenciona ler de cima a baixo e deitar fora, isso é imensa memória gasta numa estrutura de que nunca precisou
Há um segundo caminho através do mesmo ficheiro. Em vez de construir um modelo, percorre o XML da folha de cálculo apenas para a frente, uma célula de cada vez, e deixa cada célula passar depois de a ter observado. Nada se acumula. A memória mantém-se quase constante quer a folha tenha mil linhas quer tenha dez milhões, porque o leitor nunca retém mais do que a parte que está a analisar naquele momento, mais um par de pequenas tabelas de consulta. É isto que o leitor direto do HotXLS faz, e o resto deste artigo é sobre por que razão se mantém pequeno e o que lhe dá em troca
Por que razão o modelo em memória não escala
Um ficheiro XLSX é um pacote ZIP de partes XML descrito pela norma ECMA-376. Cada folha de cálculo é a sua própria parte, xl/worksheets/sheetN.xml, e no seu interior cada linha é um elemento <row> que contém elementos de célula <c>. O caminho de carregamento normal lê essa parte e constrói um objeto endereçável para cada célula, para que possa mais tarde pedir Cells[12345, 7] e obter uma resposta em tempo constante. O acesso aleatório é a razão de ser de um modelo de pasta de trabalho, e é exatamente o que torna cómoda a edição, a avaliação de fórmulas e a aplicação de estilos
O custo é que o acesso aleatório exige que tudo esteja presente em simultâneo. Não se pode indexar uma estrutura que só foi construída em parte. Assim, a memória de pico de um carregamento completo é uma função da contagem de células, e numa folha com milhões de células preenchidas essa função aterra num sítio onde o seu serviço não quer estar, sobretudo se vários trabalhos destes correrem ao mesmo tempo numa máquina partilhada. Quando o padrão de acesso de que realmente precisa é sequencial, pagar por acesso aleatório é pagar por uma capacidade que não vai usar
Uma passagem SAX apenas para a frente que não constrói árvore alguma
O leitor direto abre o pacote ZIP e percorre cada parte de folha de cálculo com um analisador do tipo pull ao estilo SAX. SAX significa aqui que o analisador reporta eventos de análise à medida que os encontra, um elemento de abertura, um bloco de texto, um elemento de fecho, e segue em frente. Não deixa nenhuma árvore de nós atrás de si. O leitor acompanha a linha e a coluna atuais a partir dos atributos r, recolhe o tipo da célula, o índice de estilo, o valor e o texto da fórmula à medida que os eventos chegam, e quando vê a etiqueta de fecho </c> emite uma célula e esquece-a. A célula seguinte reutiliza o mesmo punhado de variáveis locais
Como nada é retido entre células, a pegada de memória não cresce com o número de células. É essa a propriedade que vale a pena guardar. Uma folha de duzentas linhas e uma folha de vinte milhões de linhas custam ao leitor a mesma memória residente, e a diferença entre elas é apenas quanto tempo a passagem demora. Abdica do acesso aleatório, a funcionalidade de cartaz do modelo, e em troca obtém um teto de memória que a contagem de células não consegue romper
O que fica residente, e por que razão são essas duas partes
A passagem não é inteiramente sem estado, e as exceções são instrutivas. Duas pequenas tabelas têm de ser mantidas em memória durante todo o percurso, porque uma célula por si só não transporta informação suficiente para ser interpretada sem elas
A primeira é a tabela de strings partilhadas. Em SpreadsheetML, uma célula de texto não guarda o seu próprio texto. Transporta t="s" e uma carga numérica que é um índice para xl/sharedStrings.xml, uma única lista sem duplicados de todas as strings distintas da pasta de trabalho. É uma boa troca de espaço para ficheiros onde as mesmas etiquetas se repetem ao longo de milhares de linhas, mas significa que o leitor tem de carregar essa tabela de strings à partida e mantê-la residente, porque qualquer célula em qualquer sítio de qualquer folha pode referenciar qualquer entrada dela. A tabela é dimensionada pelo número de strings distintas, não pela contagem de células, pelo que se mantém modesta mesmo em folhas enormes
A segunda é o mapeamento de formatos numéricos da parte de estilos. Uma célula numérica e uma célula de data são idênticas byte a byte no ficheiro: ambas são um número simples, porque uma data em SpreadsheetML é apenas uma contagem serial de dias. A única coisa que as distingue é o estilo da célula, que aponta através de cellXfs em xl/styles.xml para um id de formato numérico. Para reportar uma data como data em vez do número de série em bruto, o leitor carrega essa tabela de estilo para formato e mantém-na residente. Todo o resto do ficheiro, os dados de célula propriamente ditos que constituem o grosso dos bytes, passa em fluxo sem ser guardado
Cada célula reporta um tipo e um valor
Cada célula emitida chega como um registo TXLSDirectCell. Transporta o índice e o nome da folha, a linha e a coluna baseadas em um, um Kind semântico, o Value como Variant, o texto da Formula sem o sinal de igual inicial, e o StyleIndex em bruto. O tipo é um de xdkNumber, xdkString, xdkBoolean, xdkDate ou xdkError, pelo que pode ramificar consoante o significado da célula em vez de o voltar a deduzir a partir dos atributos. Uma célula com fórmula reporta o tipo do seu resultado em cache, com o texto da fórmula ao lado, pelo que um total calculado chega como um número que também lhe diz como foi produzido

type
  TReportScan = class
    procedure OnCell(Sender: TObject; const Cell: TXLSDirectCell;
      var Abort: Boolean);
  end;

procedure TReportScan.OnCell(Sender: TObject; const Cell: TXLSDirectCell;
  var Abort: Boolean);
begin
  case Cell.Kind of
    xdkString:  AccumulateLabel(Cell.Row, Cell.Col, VarToStr(Cell.Value));
    xdkNumber:  AddToTotals(Cell.Col, Double(Cell.Value));
    xdkDate:    NoteWhen(Cell.Row, VarToDateTime(Cell.Value));
    xdkBoolean: FlagRow(Cell.Row, Boolean(Cell.Value));
    xdkError:   LogBadCell(Cell.Row, Cell.Col, VarToStr(Cell.Value));
  end;
end;
Distinguir uma data de um número
A questão das datas merece um olhar mais atento porque é aí que a maioria dos leitores ingénuos se engana. Não existe tipo data numa célula numérica. Uma célula que contenha o valor serial 46000 pode ser uma quantidade, um preço, ou o 17 de fevereiro de 2025, e o ficheiro só lhe diz qual deles através do id de formato numérico alcançado pelo estilo da célula. A norma ECMA-376 reserva um bloco de ids de formato incorporados cujo significado é fixo em todos os produtores conformes, e os ids que transportam datas situam-se em duas gamas: 14 a 22 para os formatos padrão de data e hora, e 45 a 47 para os formatos de tempo decorrido como [h]:mm:ss. Com DetectDates ativo, como está por omissão, o leitor resolve o estilo de cada célula numérica até ao seu id de formato, e uma célula cujo id caia nessas gamas reservadas é reportada como xdkDate com o seu Value já convertido num TDateTime de Delphi. Os formatos personalizados também são verificados, inspecionando o código de formato à procura de marcas de data e hora, mas as gamas reservadas são a espinha dorsal de confiança. Desligue DetectDates e a tabela de estilos nem sequer é carregada, cada célula numérica chega como xdkNumber, e a passagem fica ligeiramente mais leve
Saltar folhas e abortar cedo
A leitura sequencial tem uma vantagem discreta que o acesso aleatório não consegue igualar: pode parar. O evento OnSheet dispara antes de cada folha de cálculo ser aberta, e dá-lhe dois interruptores. Ative SkipSheet e essa parte inteira nunca é analisada, que é como se percorrem apenas as folhas que interessam numa pasta de trabalho com várias folhas sem pagar para ler o resto. Ative Abort e a passagem inteira termina de imediato. O evento OnCell transporta o seu próprio Abort, pelo que pode parar no momento em que encontrar o que procurava, uma linha em particular, um valor sentinela, o fim de um bloco de cabeçalho, sem ler os restantes milhões de células. Numa passagem apenas para a frente, abortar é genuinamente grátis, porque o trabalho que salta é trabalho que ainda não tinha acontecido

procedure TReportScan.OnSheet(Sender: TObject; SheetIndex: Integer;
  const SheetName: WideString; var SkipSheet: Boolean; var Abort: Boolean);
begin
  // Percorre apenas a folha "Data"; deixa o resto por ler
  SkipSheet := SheetName <> 'Data';
end;
Contar células sem um handler
Vale a pena destacar um aperfeiçoamento recente porque transforma uma pergunta comum numa única chamada barata. O leitor conta todas as células preenchidas por que passa, e fá-lo esteja ou não um handler OnCell ligado. Antes, sem handler definido, a contagem de células preenchidas vinha a zero, já que contar era um efeito secundário de emitir. Agora a contagem é independente da emissão. Isso significa que pode fazer uma única pergunta, quantas células preenchidas contém realmente esta pasta de trabalho, e obter a resposta pelo preço de uma passagem sem quaisquer callbacks. ReadFile e ReadStream devolvem ambos esse total como Int64, e o mesmo número fica disponível depois na propriedade CellCount. Um retorno de -1 sinaliza que o ficheiro não pôde ser aberto ou não é um pacote OOXML
var
  Reader: TXLSDirectReader;
  Populated: Int64;
begin
  Reader := TXLSDirectReader.Create;
  try
    // Sem handler OnCell: um censo puro de células preenchidas, ainda com memória quase constante
    Populated := Reader.ReadFile('quarterly_export.xlsx');
    if Populated < 0 then
      raise Exception.Create('Not a readable XLSX package')
    else
      Writeln(Format('%d populated cells (CellCount = %d)',
        [Populated, Reader.CellCount]));
  finally
    Reader.Free;
  end;
end;
Para a passagem completa, liga o handler e chama ReadFile exatamente da mesma maneira. O contraste com um carregamento completo é o cerne da questão: onde carregar quarterly_export.xlsx para uma pasta de trabalho expandiria cada célula num objeto residente e reteria tudo, o leitor direto mantém apenas as strings partilhadas e a tabela de estilos enquanto os doze milhões de células atravessam o seu OnCell uma de cada vez. A aritmética que correu por célula não deixa nada para trás, pelo que a memória de pico é definida pela contagem de strings distintas da pasta de trabalho, não pela sua contagem de linhas
O leitor direto é a ferramenta certa quando o trabalho é ler uma pasta de trabalho grande uma vez e extrair ou resumir o seu conteúdo. Quando em vez disso precisa do acesso aleatório do modelo completo mas quer que ele se comporte em ficheiros grandes, a afinação em as nossas notas sobre desempenho com pastas de trabalho grandes em Delphi cobre esse caminho. E quando a direção se inverte, produzindo saída grande em vez de a consumir, o percurso de escrita em fluxo para trabalhos em lote no servidor aplica a mesma disciplina de memória constante à escrita. Os três são fornecidos como parte do HotXLS Delphi Component para Delphi e C++Builder, a par das APIs de leitura, escrita, fórmulas e formatação abordadas noutros pontos deste blogue