Um nome definido que se refere a uma coluna inteira é lido pelo Excel como uma única célula quando aparece numa posição escalar: =Vertical+1 na linha 7 significa «a célula da linha 7 de Vertical», e não a área toda. O HotXLS Delphi Component aplica essa interseção implícita na v2.382.4 a dois níveis, na avaliação e na extração de dependências, porque um modelo de crédito com 4805 fórmulas mostrou que acertar no valor não chega. Quando o walker de dependências expande o nome para a sua área completa, uma fórmula a jusante que alimente qualquer célula dessa área fecha um ciclo que não existe, e o TXLSXWorkbook.Recalculate recusa o livro inteiro
O modelo em questão é um livro-padrão de amortização de crédito. Com todos os valores em cache envenenados com 777 e uma corrida completa do Recalculate, as duas arquiteturas do motor devolveram 23, que é lxErrorRef, o código de referência circular. 3842 das 4805 fórmulas não correspondiam à expectativa independente, o B18 tinha #VALUE!, o E18 continuava a 777, e a contagem de pagamentos em J7 tinha lido os placeholders numa coluna de saldo inacabada. Estavam três defeitos distintos escondidos atrás de um único código de retorno, e este artigo percorre cada um com o código que o corrigiu
Porque é que uma referência escalar ao nome de uma coluna cria um ciclo falso?
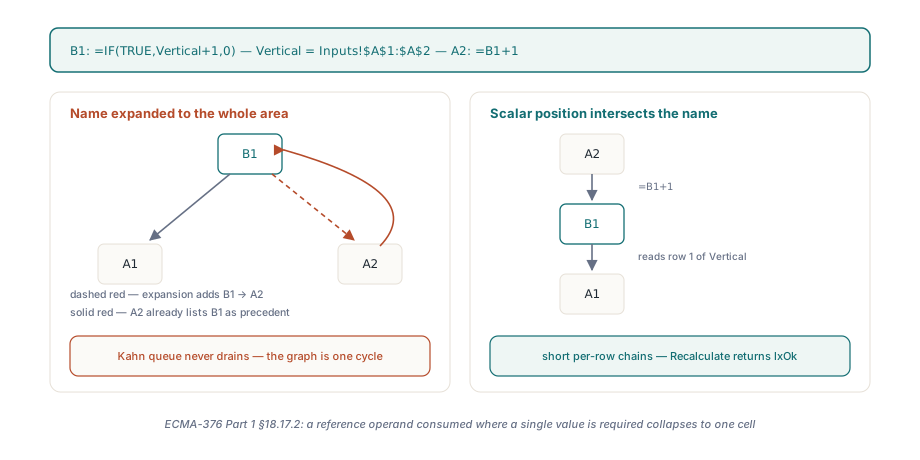
Porque um grafo de dependências só conhece arestas, e uma aresta de uma fórmula para uma área de 480 linhas são 480 arestas, uma das quais aponta de volta através de uma célula que depende da fórmula. Considere =IF(TRUE,Vertical+1,0) em B1 com Vertical definido como Inputs!$A$1:$A$2, e =B1+1 em A2. O Excel avalia B1 como A1+1 e A2 como B1+1, uma cadeia direta. Um walker que registe B1 como dependente de A1:A2 torna A2 um precedente de B1, A2 já lista B1 como precedente, e a fila de Kahn que alimenta o recálculo incremental no HotXLS nunca vê nenhum dos nós chegar a in-degree zero. É este o padrão de que são feitos os modelos de crédito: cada linha de período referencia colunas com nome para o saldo, a taxa e a contagem de pagamentos, cada nome abrange todo o plano, e cada linha escreve também nessas colunas. Expanda os nomes e o grafo é uma única e gigantesca componente fortemente ligada. Avalie-os com interseção implícita e o grafo passa a ser um conjunto de cadeias curtas, uma por linha, que é o que a ECMA-376 Parte 1 §18.17.2 descreve para um operando de referência consumido onde é exigido um único valor
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Posição escalar: Vertical colapsa em A1 porque a fórmula está na linha 1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Um nome cuja definição é outro nome também interseta, portanto isto é A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Argumento de classe referência: soma-se a área toda, sem interseção
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // A linha 6 fica fora de A1:A2, a interseção é vazia e o IFERROR apanha-a
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Antes da v2.382.4 este ramo era inalcançável: B1 -> A2 -> B1 era um ciclo
    end;
  finally
    Book.Free;
  end;
end;
Como é que o HotXLS decide que um argumento é escalar?
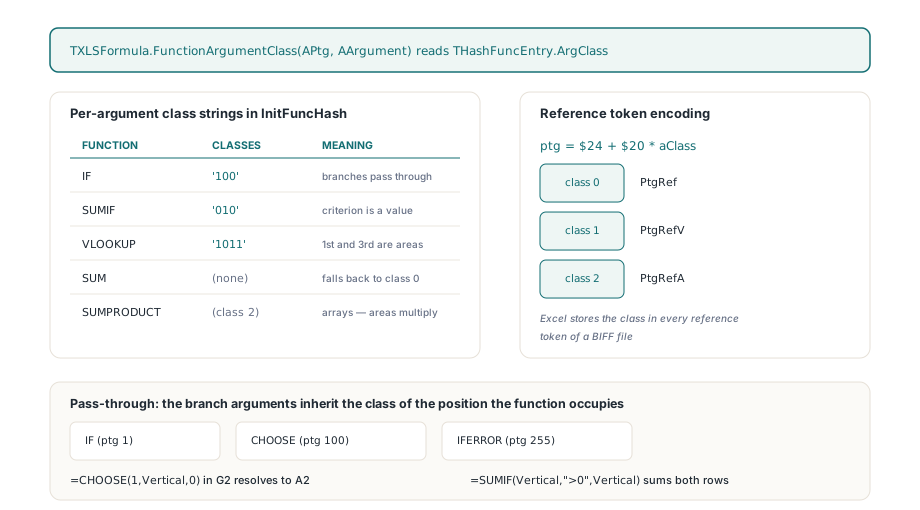
O HotXLS lê a resposta da tabela de funções e não da forma do argumento. Cada entrada em TXLSFormula.InitFuncHash é registada através de THashFunc.SetValue com uma string opcional de classe por argumento: 'IF' traz '100', 'SUMIF' traz '010', 'VLOOKUP' traz '1011', e 'SUM' não traz nenhuma, pelo que todos os seus argumentos caem na classe 0 ao nível da função. O novo TXLSFormula.FunctionArgumentClass(APtg, AArgument) expõe esse byte através de THashFuncEntry.ArgClass, e um resultado 1 significa classe de valor. São as mesmas três classes que a [MS-XLS] §2.2.2 atribui aos tokens de operando, e o encoder já dependia delas: ao escrever uma referência, calcula o ptg como $24 + $20 * aClass, o que dá PtgRef para a classe 0, PtgRefV para a classe 1 e PtgRefA para a classe 2. Um ficheiro BIFF escrito pelo Excel guarda essa classe em cada token de referência, pelo que um motor cuja tabela coincide com a especificação consegue responder a «este argumento é escalar» sem olhar para os dados. O argumento do meio do SUMIF é o critério, um valor; o primeiro e o terceiro são áreas, referências. O SUMPRODUCT está registado com classe 2 ao nível da função, array, e é por isso que =SUMPRODUCT(Vertical,Vertical) continua a multiplicar a área toda
Três funções não consultam a sua própria entrada da tabela para nada além do primeiro argumento. IF (ptg 1), CHOOSE (ptg 100) e IFERROR (ptg 255) deixam passar o que selecionam, pelo que os seus argumentos de ramo herdam a classe da posição que a própria função ocupa. É esta regra que permite que =CHOOSE(1,Vertical,0) em G2 resolva em A2 enquanto o =SUMIF(Vertical,">0",Vertical) ao lado continua a somar as duas linhas, e é a regra que um plano de amortização mais exercita, porque as suas células de período se apoiam no IF para testar se o crédito ainda está em aberto
Levar a classe através da caminhada de dependências
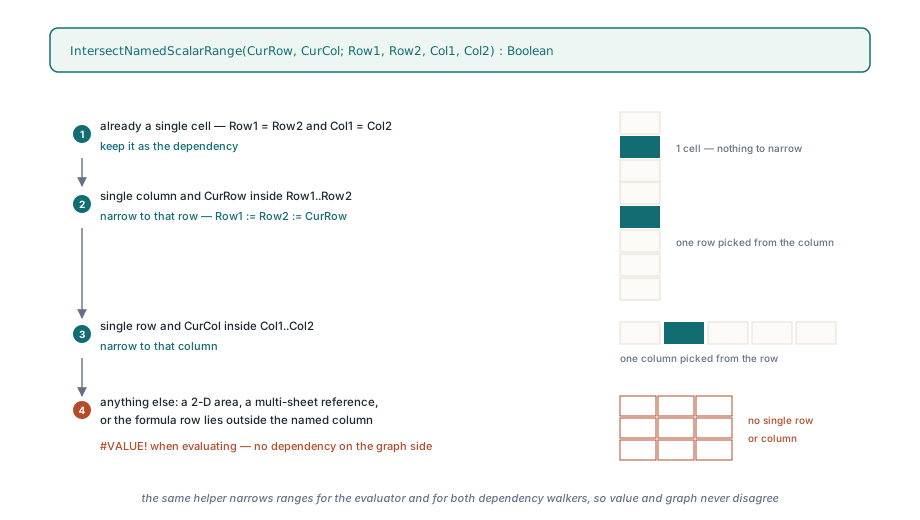
O extrator de dependências no lxCalc.pas é um Walk recursivo sobre a árvore sintática compilada, e existe duas vezes, uma no TXLSCalculator.ExtractDependencies para o grafo por livro e outra no ExtractWorkspaceDependencies para o grafo entre livros. A v2.382.4 dá aos dois walkers dois parâmetros extra. AScalar começa a True na raiz de uma fórmula, é recalculado para cada filho de função a partir de FunctionArgumentClass, e é passado sem alterações para os argumentos de ramo de ptg 1, 100 e 255. ANameRoot só passa a True quando o walker desce para a definição compilada de um nome, e só sobrevive através de nós SA_GROUP, os parênteses, pelo que um nome definido como =A1:A2+1 não é confundido com uma área simples. Quando os dois flags estão a True num nó SA_RANGE, o AddResolvedRange reduz a área com o mesmo helper que o avaliador usa antes de registar a dependência. O helper é curto o suficiente para ser citado por inteiro
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // já é uma célula
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // coluna única: ficar com esta linha
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // linha única: ficar com esta coluna
    Result := True;
  end;
end;
Tudo o que o helper rejeita — uma área bidimensional, uma referência multi-folha ou uma fórmula cuja linha fica fora da coluna com nome — produz #VALUE! do lado da avaliação e nenhuma dependência do lado do grafo, que é o que o Excel faz para uma interseção vazia. O lado da avaliação vive no TXLSCalculator.GetValueItemName: retira os invólucros SA_GROUP da definição compilada e, se a raiz for um SA_RANGE, chama o GetRangeInfo, interseta e vai buscar a única célula através do FGetValue em vez de avaliar a definição toda. As referências externas ficam no caminho antigo, porque não há nenhuma linha local contra a qual intersetar. De onde vêm originalmente o armazenamento e o âmbito de um nome é assunto de o artigo sobre nomes definidos e fórmulas entre folhas; o que aqui interessa é apenas o que o motor faz depois de o nome resolver
Porque é que o MATCH sobre uma coluna a meio calcular leu 777?
Porque o argumento de array de procura do MATCH é uma referência de varrimento, e as referências de varrimento foram deliberadamente excluídas da ordem de avaliação. O artigo sobre o varrimento de procura introduziu o TXLSDepRange.LookupScan e fechou com uma secção chamada «O que perde ao excluir as arestas de varrimento do ordenamento»: uma fórmula de procura pode correr antes de todas as células do seu intervalo terem sido recalculadas e ler valores desatualizados. Numa sessão interativa isso converge na passagem seguinte. Num recálculo em lote de um modelo envenenado, não, e o PaymentCount, definido como =MATCH(0.01,Balances,-1)+1, leu os placeholders a 777 que ainda estavam na coluna de saldo e devolveu uma contagem de períodos que não podia estar certa
O TXLSDepGraph.TopoOrder passa a tratar as arestas de varrimento como arestas de ordenação soft. A par do in-degree rígido, mantém um array ScanInDeg, que conta os precedentes de varrimento sujos por nó e o vai decrementando à medida que esses precedentes são emitidos, usando as listas ScanPrecedents, ScanDependents e ScanPrecedentCount que a alteração anterior já guardava. Em cada iteração, a fila de Kahn percorre a sua janela de nós prontos à procura do primeiro cujo ScanInDeg seja zero e troca-o para a cabeça; se todos os nós prontos estiverem ainda à espera de um precedente de varrimento, a cabeça é retirada na sua ordem estável. As arestas de varrimento nunca entram no in-degree rígido, pelo que um VLOOKUP autorreferente sobre a sua própria coluna continua a ser legal, mas uma procura que podia esperar por um precedente terminável agora espera. A regressão que fixa isto, LookupScan_WaitsForDirtyFormulaValues, envenena três células de saldo com 777 e espera que o PaymentCount volte como 3, depois põe a entrada a zero e espera que =IFERROR(PaymentCount,99) veja o #N/A e devolva 99
De onde vinha o truncamento a quatro casas decimais?
Da aritmética de Variant do Delphi, e apenas em posições aninhadas. Os operadores binários em TXLSCalculator.GetValueItem já copiavam um + ou - de nível superior para duas variáveis locais Double, pelo que =B1-A1 estava bem. Dentro de =IF(TRUE,B1-A1,0) a mesma subtração corria como Value := Value - SubValue sobre dois Variants, e quando um operando era um valor de célula Int64 e o outro um Double, o resultado que observámos era um Currency, um tipo de vírgula fixa com quatro casas decimais, pelo que 1066.1854641400994 menos 120 voltava truncado a quatro decimais. Ao longo de um plano em que cada pagamento é composto a partir da linha anterior, esse erro atravessa centenas de períodos antes de chegar aos totais
// TXLSCalculator.GetValueItem, ramo da aritmética binária (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// A aritmética Variant mista Int64/Double pode promover para Currency.
// A aritmética de folha de cálculo tem de manter a precisão de vírgula flutuante.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
A guarda corre antes de SA_ADD, SA_SUB, SA_MUL e SA_DIV por igual, e a regressão Arithmetic_MixedInt64AndDoubleKeepsPrecision guarda Int64(120) em A1 e 1066.1854641400994 em B1, e depois verifica a diferença e a soma aninhadas até 1E-10 e o produto e o quociente até 1E-8 e 1E-12. O HotXLS não reivindica conhecer todas as regras de promoção que a RTL aplica a tipos Variant mistos entre versões do compilador; reivindica que a aritmética de folha de cálculo é IEEE double, e agora converte ambos os operandos em double antes de o operador os ver, o que elimina a questão
O que é que a correção garante, e o que é que não garante
Depois da v2.382.4, as duas arquiteturas do motor devolvem lxOk para o modelo envenenado, todos os 4805 valores em cache coincidem com a expectativa independente linha a linha dentro de 1E-7, e verificam-se todas as asserções de que as caches estavam mesmo envenenadas, de que o hash de origem não mudou e de que todas as fórmulas continuam presentes. Não foi ativada nenhuma iteração nem suprimido nenhum código de erro para lá chegar. Um ciclo genuíno através de um nome, =B1 em A1 com B1 a ler ainda Vertical, continua a devolver erro, e o teste NamedScalarRanges_IntersectWithoutFalseCycles termina precisamente por afirmar isso
Vale a pena enunciar os limites com clareza. A interseção implícita aplica-se apenas a um nome cuja definição compilada, depois de retirados os parênteses, seja uma área de uma só coluna ou de uma só linha numa única folha; um nome bidimensional numa posição escalar dá #VALUE!, como no Excel, e uma função que a tabela não conheça recebe a classe 0 do FunctionArgumentClass, pelo que os seus argumentos de nome continuam a ser expandidos por inteiro. A ordenação soft é uma preferência, não uma garantia: um ciclo só de varrimento continua a ser avaliado na ordem estável e lê o que estiver em cache, que é o comportamento que o artigo sobre o varrimento de procura aceitou de propósito. E o resultado do modelo completo é verificado contra um script de expectativas independente, não contra outro motor de folha de cálculo, porque a suite de escritório de referência não acabou de recalcular o modelo original dentro de um orçamento de 60 segundos. O HotXLS é um componente nativo de folhas de cálculo para Delphi e C++Builder que lê, recalcula e escreve XLS, XLSX, ODS e CSV sem o Excel instalado; a interseção de nomes, a tabela de classes de argumento e a ordenação soft do varrimento aplicam-se a todos os formatos porque o motor de cálculo é partilhado, e a cobertura atual de funções está listada na página de produto HotXLS Delphi spreadsheet component