O HotPDF corre o Tesseract dentro do seu processo Delphi através do HPDFCreateTesseractDLLOCREngine, uma fábrica acrescentada na v2.772.0 que carrega dinamicamente uma DLL compatível com Tesseract 5, comanda a sua API C (TessBaseAPIInit2, TessBaseAPIRecognize, o iterador de resultados) e devolve um IHPDFOCREngine. O THotPDF.ApplyLoadedOCRTextLayer usa esse engine para acrescentar uma camada de texto Unicode invisível e pesquisável a páginas PDF digitalizadas
O mesmo reconhecedor já era alcançável pelo adaptador externo tesseract.exe que escreve um BMP e analisa TSV. Esse caminho funciona, mas cada página paga um lançamento de processo, um ficheiro de bitmap temporário e um formato de texto sem baselines e sem controlo sobre a segmentação de página. Chamar a DLL remove os três. Também remove a parede de processo, o que significa que uma binding Pascal senta-se diretamente sobre estruturas C, booleanos C e strings alocadas em C. A maior parte do que vale a pena saber sobre este adaptador é onde essa binding pode correr mal em silêncio
Como correr o Tesseract in-process de Delphi com o HotPDF?
Correr o Tesseract in-process com o HotPDF leva uma chamada de fábrica na unidade HPDFTesseractRecognition e a mesma chamada ApplyLoadedOCRTextLayer que todo o engine OCR do HotPDF usa. A fábrica valida de imediato. O ficheiro da DLL e o diretório tessdata têm de existir, o identificador de língua só pode conter letras ASCII, dígitos, _ e +, cada modelo numa combinação como chi_sim+eng tem de ter um ficheiro .traineddata correspondente, e todos os 21 exports obrigatórios têm de resolver antes de o engine ser devolvido. Erros de configuração levantam EArgumentException; uma DLL que falhe ao carregar levanta EOSError com o código de erro do Windows e uma dica para verificar arquitetura e dependências
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Uma aplicação Win64 precisa de uma DLL de 64 bits; dependências ficam ao lado
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // Uma lista de páginas vazia significa todas as páginas; páginas com texto são saltadas
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
O THPDFTesseractOptions.Default põe PageSegMode em tpsAuto, EngineMode em temDefault, TimeoutMilliseconds em 60 000 e MaxPixels em 16 777 216. O orçamento de pixels interessa mais do que parece. Uma página US Letter aos 300 DPI por omissão renderiza para 2 550 × 3 300 pixels, cerca de 8,4 milhões, o que cabe. A mesma página a 600 DPI é 5 100 × 6 600, cerca de 33,7 milhões, e o adaptador recusa-a antes de o Tesseract ver um pixel. Suba o MaxPixels (o teto é 67 108 864) ou mantenha o DPI onde está; cada lado também é limitado a 32 767 pixels
A DLL é carregada com LoadLibraryEx usando as flags de procura para a pasta própria da DLL mais os diretórios seguros por omissão, por isso as bibliotecas de imagem de que o Tesseract depende podem viver ao lado dele sem tocar no PATH nem no diretório atual. O HotPDF não embala nem descarrega nenhum runtime ou modelo OCR; você provisiona ambos
O que muda em comparação com o adaptador tesseract.exe?
O adaptador DLL troca isolamento de processo por output mais rico e menos overhead por página. Ambos os adaptadores ligam-se ao mesmo pipeline de camada de texto, por isso mapeamento de coordenadas, filtragem por confiança e a consolidação tudo-ou-nada são idênticos; o que difere é como os pixels entram e as palavras saem
| Aspeto | Adaptador tesseract.exe | Adaptador DLL Tesseract |
|---|---|---|
| Fábrica | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| Pixels a entrar | Ficheiro BMP num diretório temporário privado | Buffer em tons de cinzento de 8 bits em memória |
| Palavras a sair | TSV ao nível de palavra, limitado a 64 MiB | Iterador de resultados, UTF-8 por palavra |
| Baselines | Indisponíveis | Passadas através do TessPageIteratorBaseline |
| Segmentação de página e modo de engine | Só segmentação automática | THPDFTesseractPageSegMode, THPDFTesseractEngineMode |
| Timeout | Duro: o processo filho é terminado | Cooperativo: o Tesseract tem de notar |
| Isolamento de crashes e de memória | Processo separado | Nenhum, partilha o seu espaço de endereçamento |
Um custo não desaparece. Cada chamada Recognize cria a sua própria instância de API e chama TessBaseAPIInit2, por isso os modelos de língua são inicializados por página em vez de uma vez por engine. A cache de ficheiros do sistema operativo amortece o recarregamento, mas em conjuntos de modelos grandes multilingue continua a ser o custo fixo dominante por página, e conta para o prazo de reconhecimento. O engine DLL RapidOCR in-process toma o desenho oposto e mantém os seus modelos ONNX residentes pelo tempo de vida do engine; os problemas de fronteira (ABI C, buffers emprestados, trabalho nativo ininterruptível) são da mesma família
Porque é que o Delphi não pode copiar a struct monitor do Tesseract?
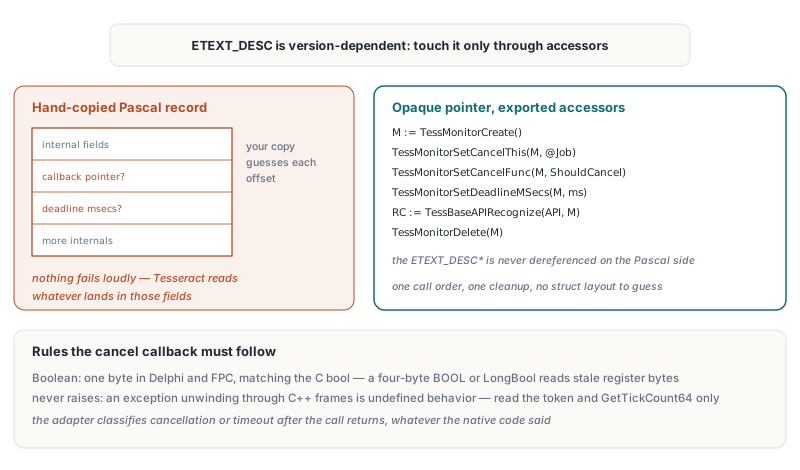
O Delphi não consegue espelhar com segurança o monitor de progresso do Tesseract porque o ETEXT_DESC contém campos internos dependentes da versão, por isso um registo copiado à mão põe o callback de cancelamento e o prazo nos offsets errados em algumas builds. Nada falha ruidosamente quando isso acontece. O Tesseract simplesmente lê o seu apontador de callback de um campo que agora guarda outra coisa, ou nunca chega a ver o prazo
O HotPDF trata por isso o monitor como um apontador opaco e toca nele só através de funções exportadas: TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs e TessMonitorDelete. Se você fizer a binding da API C você próprio para outro propósito, o mesmo padrão aplica-se. O esqueleto abaixo é código de binding seu, não API do HotPDF, e espelha as declarações que o HotPDF usa internamente
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, nunca desreferenciado
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Corre na stack do Tesseract: leia flags e o relógio, nunca levante
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// Uso, com os apontadores de função resolvidos por GetProcAddress:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
Dois detalhes nesse esqueleto são deliberados. O callback devolve Boolean, que é um byte tanto em Delphi como em Free Pascal, a condizer com o bool C no TessCancelFunc. O BOOL do Windows de quatro bytes ou o LongBool do Delphi parece intercambiável e não é: quando um lado escreve um único byte e o outro lê quatro, os bytes superiores do registo de retorno são o que lá ficou, e um false pode chegar como true. O mesmo header complica mais as coisas, porque funções como TessPageIteratorBoundingBox devolvem um int, que o HotPDF declara como Integer. Leia o tipo C de cada valor de retorno em vez de assumir uma convenção para a API inteira
O segundo detalhe é que o callback nunca levanta. Uma exceção Delphi a desenrolar através de frames C++ do Tesseract é comportamento indefinido, por isso o callback do HotPDF só lê o token de cancelamento e um valor GetTickCount64 monótono. O adaptador transforma o resultado num diagnóstico de cancelamento ou de timeout depois de o TessBaseAPIRecognize devolver, e faz essa verificação independentemente do código de retorno nativo
Que apontadores nativos são da posse do lado Delphi?
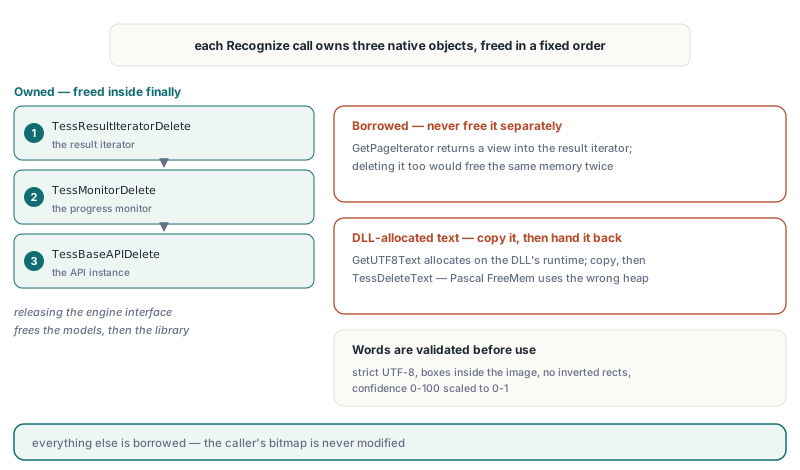
O adaptador DLL Tesseract do HotPDF é dono de três objetos nativos por pedido, a instância de API, o monitor e o iterador de resultados, e toma emprestado todo o resto. Cada chamada Recognize cria o seu próprio conjunto e liberta-o num bloco finally: TessResultIteratorDelete, depois TessMonitorDelete, depois TessBaseAPIDelete. Libertar a interface do engine descarrega a biblioteca
- O
TessResultIteratorGetPageIteratordevolve uma vista emprestada para dentro do iterador de resultados, não um objeto novo. O HotPDF usa-o paraTessPageIteratorBoundingBoxeTessPageIteratorBaselinee nunca o liberta; apagá-lo separadamente libertaria a mesma memória duas vezes - O
TessResultIteratorGetUTF8Textdevolve uma string alocada pelo runtime da própria DLL. O HotPDF copia-a e devolve-a através doTessDeleteTextnum blocofinally; umFreeMemPascal libertá-la-ia na heap errada - O texto das palavras é descodificado com validação UTF-8 estrita e verificação de comprimento antes da conversão. Palavras com caracteres de controlo, UTF-8 malformado, caixas fora da imagem, retângulos invertidos ou confiança fora de 0–100 falham o pedido em vez de ser remendadas em silêncio
- O texto total por pedido está limitado a 1 048 576 unidades de código UTF-16, e a contagem de palavras tem de caber no orçamento do pedido entregue pelo
ApplyLoadedOCRTextLayer
A confiança chega como 0–100 e é escalada para 0–1, por isso o THPDFOCRTextLayerOptions.MinimumConfidence significa a mesma coisa para todos os engines. Quando o Tesseract reporta uma baseline, ambos os pontos são passados; caso contrário o pipeline da camada de texto recua para a sua estimativa geométrica, exatamente como faz para input TSV
Porque validar um enum antes de ele chegar à DLL?
O HotPDF copia o ordinal cru do PageSegMode e do EngineMode para um Integer antes de verificar o intervalo, porque um compilador pode assumir que uma variável enum guarda sempre um valor declarado e dobrar Ord(X) > Ord(High(T)) numa constante false. Os ordinais não são enfeite: o THPDFTesseractPageSegMode segue a numeração de segmentação de página do Tesseract de 0 a 13, o THPDFTesseractEngineMode segue a numeração de modos de engine de 0 a 3, e ambos vão à DLL como inteiros simples. Um registo de opções construído com FillChar, preenchido a partir de um stream, ou passado do C++Builder com um integer com cast pode trazer um byte como 200. Validar o ordinal copiado transforma isso num EArgumentException no momento da fábrica em vez de um modo indefinido dentro do código nativo. A fábrica também rejeita tpsOSDOnly e tpsAutoOnly, que não produzem palavras, e exige osd.traineddata para tpsAutoOSD e tpsSparseTextOSD
O que garante afinal o timeout de reconhecimento?
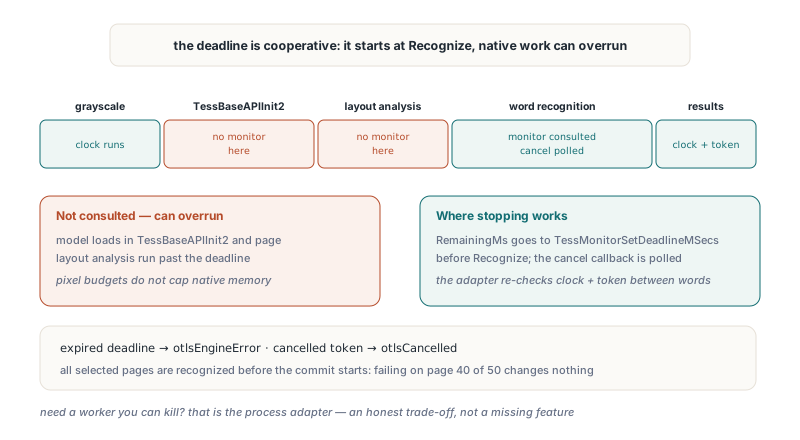
O timeout da DLL Tesseract é cooperativo: o HotPDF consegue parar o seu próprio trabalho e pedir ao Tesseract que pare, mas não consegue forçar código nativo a devolver. O relógio começa quando o Recognize começa, por isso a conversão de bitmap e a inicialização de modelos consomem o mesmo orçamento que o reconhecimento. O HotPDF verifica o tempo decorrido e o token de cancelamento durante a conversão para tons de cinzento e entre palavras enquanto itera resultados, e passa os milissegundos restantes ao TessMonitorSetDeadlineMSecs antes de chamar TessBaseAPIRecognize
A falha está dentro da chamada nativa. O monitor do Tesseract é consultado durante o reconhecimento de palavras, não durante o TessBaseAPIInit2 ou a análise de layout da página, por isso um load de modelo lento ou um layout patológico pode passar do prazo antes de o timeout ser reportado. Os orçamentos de pixels e de output também não limitam o uso de memória da própria biblioteca nativa. Se precisa de um worker que possa matar, use o adaptador de processo; essa é a troca honesta, não uma funcionalidade em falta
A segmentação de página é onde o adaptador DLL vale o que custa em input difícil. Formulários, etiquetas e tabelas digitalizadas com campos espalhados frequentemente reconhecem melhor com tpsSparseText do que com segmentação automática, que tenta montar colunas e parágrafos que não estão lá
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // campos espalhados, sem colunas montadas
  TessOptions.EngineMode := temLSTMOnly;     // precisa de modelos LSTM na tessdata
  TessOptions.TimeoutMilliseconds := 20000;  // inclui a inicialização de modelos
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        Writeln('Tesseract failed or timed out: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Um timeout aparece como otlsEngineError com o diagnóstico Tesseract DLL OCR timed out, enquanto um token cancelado aparece como otlsCancelled. Em ambos os casos o ApplyLoadedOCRTextLayer já reconheceu todas as páginas selecionadas antes de começar a transação de consolidação, por isso uma falha na página 40 de 50 deixa o documento carregado exatamente como estava. Note que tpsSingleLine, tpsSingleBlock e tpsSparseText mudam só a segmentação; nenhum endireita um scan torto
Free Pascal e Lazarus: pixels velhos e chinês perdido
Ambas as fábricas Tesseract funcionam em builds Free Pascal e Lazarus Windows Win32 e Win64 desde a v2.772.1, depois de duas correções específicas de FPC. Recompile primeiro o pacote Lazarus para a arquitetura alvo; a porta geral está coberta em HotPDF em Free Pascal e Lazarus Win64
A primeira correção diz respeito aos pixels. Um TBitmap da LCL escrito através de scanlines pode atualizar a sua imagem crua sem refrescar o handle de bitmap do Windows, por isso GetDIBits sobre esse handle devolve os pixels velhos. O sintoma era desconcertante: texto desenhado diretamente num bitmap era reconhecido, enquanto uma página renderizada pelo renderer PDF do HotPDF produzia uma lista de palavras vazia. Em FPC o adaptador lê agora um snapshot consciente do formato através do CreateIntfImage, que respeita o formato de pixels e a ordem de linhas da imagem crua. A build Delphi mantém o caminho GetDIBits sobre uma cópia privada de 24 bits. Nenhuma das builds modifica o bitmap do chamador
A segunda correção pertence ao adaptador tesseract.exe. O TStringList do FPC guarda strings ANSI, por isso atribuir texto TSV UTF-8 descodificado a Lines.Text deixava cair em silêncio cada carácter chinês ou do plano suplementar que a página de código ANSI do sistema não conseguisse representar. O caminho FPC agora mantém o TSV como bytes UTF-8, tira o BOM ao nível de bytes e descodifica cada palavra individualmente para UnicodeString. O adaptador DLL nunca teve este problema porque descodifica cada palavra diretamente do iterador
Referência rápida
- Fábrica:
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language[, Options])emHPDFTesseractRecognition, acrescentada na v2.772.0, suporte FPC na v2.772.1 - Predefinições:
tpsAuto,temDefault, 60 000 ms, 16 777 216 pixels; intervalo de timeout 1–3 600 000 ms, teto de pixels 67 108 864 - Faça a bitness da DLL corresponder à aplicação e coloque as DLLs de dependência ao lado da DLL Tesseract
- Trate o monitor como opaco; nunca copie
ETEXT_DESCpara um registo Pascal - Declare o callback de cancelamento
cdeclcom um resultadoBooleande um byte, e nunca deixe uma exceção escapar dele - Liberte o texto do iterador com
TessDeleteText; nunca liberte o iterador de página obtido do iterador de resultados - Espere que o prazo seja cooperativo: a inicialização de modelos e a análise de layout podem ultrapassá-lo
- Use o adaptador tesseract.exe quando precisar de terminação dura ou isolamento de crashes
O adaptador DLL Tesseract, os adaptadores de processo e o engine OCR integrado vêm todos com o componente PDF Delphi HotPDF para Delphi, C++Builder e Free Pascal; veja a página de produto do HotPDF para edições e downloads