Abrir um PDF produzido pelo Microsoft Word ou pelo Excel, percorrer as páginas e nada parece fora do normal. Carregá-lo num programa Delphi, ler de novo o número de páginas, e o valor está correto. Depois, ao voltar a guardá-lo com a encriptação ativada, o processo falha com um EListError, ou o ficheiro de saída abre com um aviso de tabela de referências cruzadas danificada. O ficheiro nunca esteve corrompido. É um ficheiro de referência híbrida, e é precisamente a estrutura que permite a um visualizador com quinze anos abri-lo que derrota um carregador que para de ler cedo demais
Esta é uma das formas mais comuns de um pipeline de PDF que passou em todos os testes internos se deparar com um ficheiro que não consegue processar de ida e volta. Todas as entradas eram geradas internamente, pelo que nunca eram híbridas. O primeiro ficheiro híbrido chega no dia em que um cliente reenvia uma fatura exportada de uma folha de cálculo
O que o Word e o Excel escrevem, na realidade
A norma ISO 32000-1 descreve o esquema de referência híbrida no §7.5.8.4. Uma aplicação que pretenda funcionalidades do PDF 1.5, como os fluxos de objetos (object streams), mas que ainda queira permitir que um leitor de PDF 1.4 abra o ficheiro, escreve a informação de referências cruzadas duas vezes. Existe uma tabela de referências cruzadas clássica, as linhas ASCII de largura fixa que encerravam todos os PDF até à versão 1.4, e existe um fluxo de referências cruzadas que indexa o resto. O trailer da secção clássica transporta uma entrada /XRefStm cujo valor é o deslocamento em bytes desse fluxo
A divisão de tarefas é deliberada. Os objetos que um leitor antigo precisa de alcançar, entre eles o catálogo e a árvore de páginas, são endereçáveis a partir da tabela clássica. Os objetos que foram compactados em fluxos de objetos comprimidos são marcados como livres na tabela clássica, com uma entrada do tipo f, para que um leitor 1.4 passe diretamente por cima deles e nunca tropece numa estrutura que não consegue interpretar. As suas localizações reais existem apenas no fluxo de referências cruzadas. A assinatura deste tipo de ficheiro está na sua cauda: uma secção clássica curta, muitas vezes nada mais do que xref seguido de um cabeçalho de subsecção 0 0, cujo trailer aponta para o /XRefStm onde residem os dados de recuperação reais
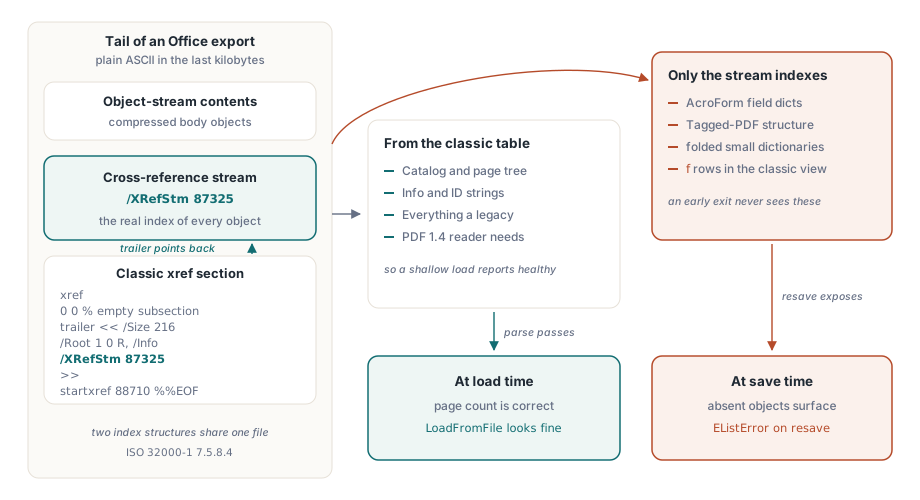
/XRefStm, enquanto o lado do fluxo detém o índice real de objetosPor que um número de páginas correto não prova nada
Como o catálogo e a árvore de páginas são propositadamente alcançáveis a partir da tabela clássica, um carregador que leia apenas essa tabela encontra /Root, percorre a árvore de páginas e reporta o número correto de páginas. Tudo o que um leitor antigo precisa está presente, pelo que o ficheiro parece saudável. Os objetos que desaparecem são os que foram compactados em fluxos de objetos: dicionários de campos AcroForm, elementos de estrutura de PDF etiquetado (tagged PDF), a longa cauda de pequenos dicionários que nunca precisaram de ser visíveis para um visualizador legado
A lacuna só se nota quando algo toca nesses objetos, e uma nova gravação completa toca em todos eles. Percorrer o documento para o reencriptar ou reescrever é precisamente a operação que exige, um a um, todos os números de objeto, razão pela qual o sintoma surge no momento de guardar e não no momento de carregar, longe da sua causa
A armadilha é um detetor que vê xref e para
A forma mais económica de decidir como um ficheiro está indexado é seguir startxref e inspecionar os primeiros bytes para onde aponta. A palavra-chave xref significa uma tabela clássica; um objeto de fluxo significa um fluxo de referências cruzadas. Este teste está correto para qualquer ficheiro que se comprometa com um único esquema. Está errado para um ficheiro híbrido, cujo startxref aponta para uma secção clássica com o único propósito de satisfazer leitores antigos, enquanto o /XRefStm no trailer dessa secção é onde a maior parte do documento está efetivamente indexada. Um detetor que devolve "clássico" ao encontrar o primeiro xref nunca lê o /XRefStm, e todos os objetos que existem apenas no fluxo tornam-se invisíveis
var
  Pdf: THotPDF;
  PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('Invoice_XLS.pdf');  // a contagem está correta
    // inspecionar ou editar aqui o documento carregado
    Pdf.SaveLoadedDocument('Invoice_secured.pdf');     // percorre todos os objetos
  finally
    Pdf.Free;
  end;
end;
Com o detetor de saída antecipada em vigor, o carregamento parece correto e é na nova gravação que os objetos ausentes se anunciam. A correção não passa por ler mais bytes no início; passa por reconhecer o trailer híbrido e seguir /XRefStm antes de considerar o ficheiro concluído
A ordem de fusão não é negociável
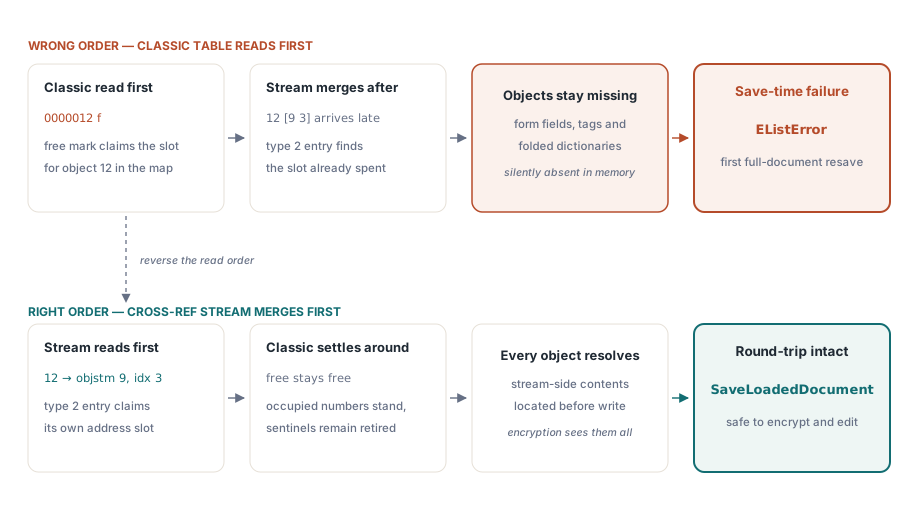
Depois de ambos os índices terem sido lidos, só podem ser combinados numa única direção. O fluxo de referências cruzadas tem de ser fundido primeiro, preenchendo-se as entradas clássicas à sua volta. A razão está no pequeno artifício no cerne do formato. Um ficheiro híbrido marca os seus objetos comprimidos como livres na tabela clássica, para que os leitores antigos os ignorem. Um carregador que siga uma política de "o primeiro visto vence" e leia primeiro a tabela clássica regista esses números de objeto como livres e depois descarta as entradas do fluxo que na realidade os localizam, porque as posições já estão ocupadas. Invertendo a ordem, as entradas do tipo 2 do fluxo, cada uma composta por um número de fluxo de objetos mais um índice, ganham as posições que lhes pertencem, e as entradas clássicas acomodam-se à sua volta
A mesma disciplina protege contra uma revisão mais antiga ressuscitar um objeto eliminado. As atualizações incrementais encadeiam-se para trás através de /Prev, e uma entrada livre do tipo 0 é uma sentinela que indica que uma secção mais recente retirou um número de objeto. Uma secção mais antiga, processada mais tarde na cadeia, não pode ter permissão para substituir essa sentinela por uma localização desatualizada. Tratando o primeiro-visto como autoritativo para os marcadores livres, o objeto eliminado permanece eliminado; tratando-o com descuido, o próprio histórico do ficheiro reanima conteúdo que a revisão mais recente removeu
O que isto significa no HotPDF
O motor resolve os ficheiros de referência híbrida automaticamente, e fá-lo em todos os percursos que têm de interpretar os dados de referências cruzadas. Carregar um documento com LoadFromFile ou LoadFromStream, fazer as alterações pretendidas e chamar SaveLoadedDocument; ou executar uma operação pontual, como EncryptFile, que lê uma entrada e escreve uma saída. De qualquer das formas, a recuperação lê o /XRefStm, funde a secção do fluxo antes das entradas clássicas e resolve os objetos que residem em fluxos antes de a escrita os enumerar. O percurso de encriptação AES-256 foi onde o problema se manifestou pela primeira vez, porque encriptar um documento reescreve todos os objetos e, por isso, exige que todos já tenham sido localizados
// Operação pontual: lê a entrada híbrida, escreve uma cópia encriptada com AES-256
Pdf.EncryptFile('Letter_DOC.pdf', 'Letter_secured.pdf',
  'owner-secret', '', aes256, [prPrint, prFillAnnotations]);
O pormenor que vale a pena reter está a montante da API. Os ficheiros que chegam do Word, do Excel, do PowerPoint e de uma longa lista de pipelines "Guardar como PDF" são rotineiramente híbridos, pelo que um carregador testado apenas contra a saída do próprio gerador pode nunca encontrar um durante os testes. Convém alimentar os conjuntos de teste com documentos exportados de aplicações Office reais, e não apenas com ficheiros produzidos pelo próprio código
Verificar um ficheiro suspeito
Duas verificações resolvem a questão rapidamente. Abrir o ficheiro numa vista hexadecimal e ler os bytes a seguir ao último startxref; um ficheiro híbrido mostra uma secção clássica curta cujo dicionário do trailer contém /XRefStm. Ou comparar o número de objetos que uma interpretação completa reporta com o número de objeto mais alto que /Size declara no trailer. Uma diferença grande significa que há objetos escondidos em fluxos que o carregador não abriu, que é a mesma falha que mais tarde se transforma numa falha no momento de guardar
A cauda de uma exportação típica do Excel torna a primeira verificação concreta. Tudo o que vem depois da última palavra-chave xref é ASCII simples, pelo que a assinatura é legível diretamente numa vista hexadecimal (deslocamentos ilustrativos, anotações acrescentadas)
xref
0 0                          % subsecção classic vazia: sem linhas nenhumas
trailer
<< /Size 216                 % um acima do maior número de objeto em uso
   /Root 1 0 R
   /Info 15 0 R
   /ID [<5C9A...> <5C9A...>]
   /XRefStm 87325            % byte offset da cross-reference stream
>>
startxref
88710                        % aponta para a secção classic acima
%%EOF
A subsecção 0 0 é o sinal revelador: uma tabela clássica com zero entradas existe apenas para transportar o trailer, e o trailer existe principalmente para dizer /XRefStm 87325. Um detetor que para na palavra-chave xref viu, neste ponto, um índice de nada. Quando se preferir automatizar a verificação em vez de a fazer visualmente, o marcador está sempre dentro dos últimos dois quilobytes do ficheiro, pelo que uma leitura limitada a partir do fim é suficiente
// Devolve o deslocamento do /XRefStm a partir da cauda do ficheiro, ou -1 se
// o marcador estiver ausente (o ficheiro não é híbrido, ou nem sequer é um PDF)
function FindXRefStm(const FileName: string): Int64;
var
  FS: TFileStream;
  Tail: AnsiString;
  Len, P: Integer;
begin
  Result := -1;
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Len := 2048;                        // o trailer reside na cauda
    if FS.Size < Len then
      Len := Integer(FS.Size);
    FS.Position := FS.Size - Len;       // leitura limitada a partir do fim: 2 KB no máximo
    SetLength(Tail, Len);
    FS.ReadBuffer(Tail[1], Len);
  finally
    FS.Free;
  end;
  P := Pos(AnsiString('/XRefStm'), Tail);
  if P = 0 then
    Exit;                               // sem marcador híbrido na cauda
  Inc(P, Length('/XRefStm'));
  while (P <= Len) and (Tail[P] in [' ', #9, #13, #10]) do
    Inc(P);                             // ignora espaços em branco após a chave
  Result := 0;
  while (P <= Len) and (Tail[P] in ['0'..'9']) do
  begin
    Result := Result * 10 + Ord(Tail[P]) - Ord('0');
    Inc(P);
  end;
end;

// Utilização: um resultado não negativo indica o byte onde o fluxo começa
if FindXRefStm('Invoice_XLS.pdf') >= 0 then
  Writeln('hybrid-reference file: resave will need the /XRefStm section');
Convém tratar esta sonda como triagem, não como um parser: ela indica quais os ficheiros de um lote que merecem atenção antes de correr um trabalho de nova gravação, e nada mais. O que um carregador deve depois fazer com o deslocamento que encontra — seguir a cadeia de secções, fundir as entradas do fluxo antes das clássicas, respeitar as sentinelas de entradas livres — é explicado passo a passo em o nosso artigo complementar sobre o tratamento de PDF de referência híbrida provenientes de aplicações Office
O lado da escrita desta história, como é que os fluxos de objetos e as referências cruzadas comprimidas são produzidos em primeiro lugar, é abordado no nosso artigo sobre fluxos de objetos e atualizações incrementais. Quando o ficheiro híbrido em questão também é muito grande, as técnicas de carregamento descritas em o percurso guiado da Direct File API para fluxos de trabalho com PDF de grande dimensão permitem inspecioná-lo sem ler tudo para memória. Ambos combinam naturalmente com a recuperação aqui descrita, que é fornecida como parte do HotPDF Delphi Component para Delphi e C++Builder, juntamente com as APIs de carregamento, edição, encriptação e assinatura abordadas noutras partes deste blogue