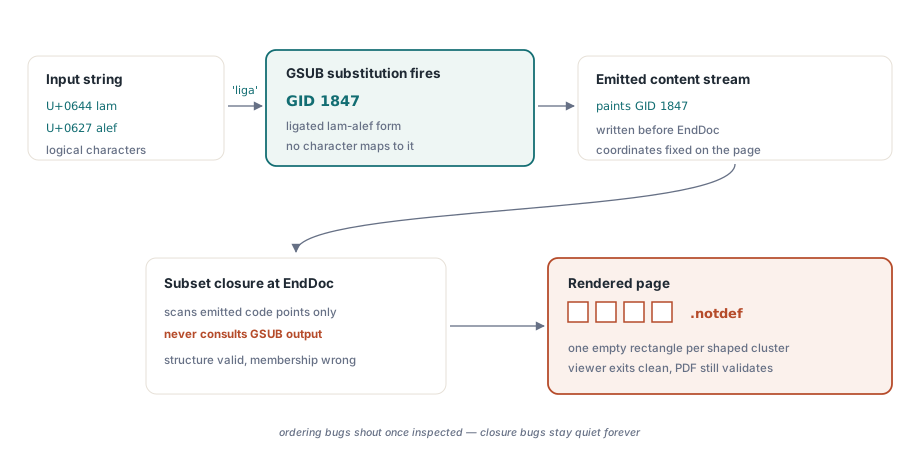
Os glifos moldados renderizam como caixas .notdef quando um subsetter de tipo de letra mantém apenas os glifos alcançáveis a partir dos pontos de código emitidos. O HotPDF, o componente VCL nativo de PDF para Delphi e C++Builder, carregou exatamente esse defeito até à versão 2.435.0: a saída GSUB do OpenType era registada num bitmap interno de utilização que o subsetter declarava que iria respeitar e depois nunca de facto lia
Esta é uma falha diferente da descrita no bug do EndDoc que desativava silenciosamente o subsetting de tipos de letra. Aquele bug era sobre quando o subsetting corria em relação à serialização, e desativava o subsetting por completo. Este é sobre o que o subset contém quando o subsetting corre perfeitamente no momento certo. O pipeline dispara no momento certo, o prefixo de subset de seis letras aparece em /BaseFont exatamente como o ISO 32000-1 §9.6.4 exige, o ficheiro fica mais pequeno, cada página em Latim sai limpa na prova, e uma página em árabe sai como uma fila de retângulos vazios. Bugs de ordenação são ruidosos assim que se olha. Bugs de fecho ficam calados para sempre, porque o subset é estruturalmente válido e só está errado quanto à sua própria lista de pertença
Porque é que os glifos moldados renderizam como .notdef?
Porque o conjunto de pontos de código que um documento emite não é o conjunto de glifos que o documento desenha, e um subsetter que confunde os dois elimina cada glifo produzido pelo shaping. O text shaping transforma uma sequência lógica de carateres numa sequência de glifos posicionados, e todo o seu propósito é produzir glifos a que nenhum carater de entrada isolado corresponde: um heh medial árabe, uma ligadura fi, um conjunto devanágari, uma alternativa contextual selecionada pela funcionalidade rclt. Cada um destes é um ID de glifo fabricado por um lookup GSUB, e não um que a tabela cmap entregue para qualquer carater da string. Um subsetter guiado apenas pelo cmap está, portanto, a percorrer o índice errado. Mantém fielmente cada glifo que o texto podia ter usado antes do shaping e descarta precisamente os glifos que o texto usa depois do shaping. O renderizador pede então ao tipo de letra incorporado o GID 1847, o subset zerou essa entrada em loca, e volta o índice de glifo 0. O índice de glifo 0 é .notdef por definição do OpenType, e é por isso que a assinatura da falha é uma caixa vazia em vez de uma letra errada ou uma falha. Nada no PDF está mal formado; o tipo de letra simplesmente não contém o glifo que o content stream pediu
Pontos de código não são glifos: as três fontes de um subset
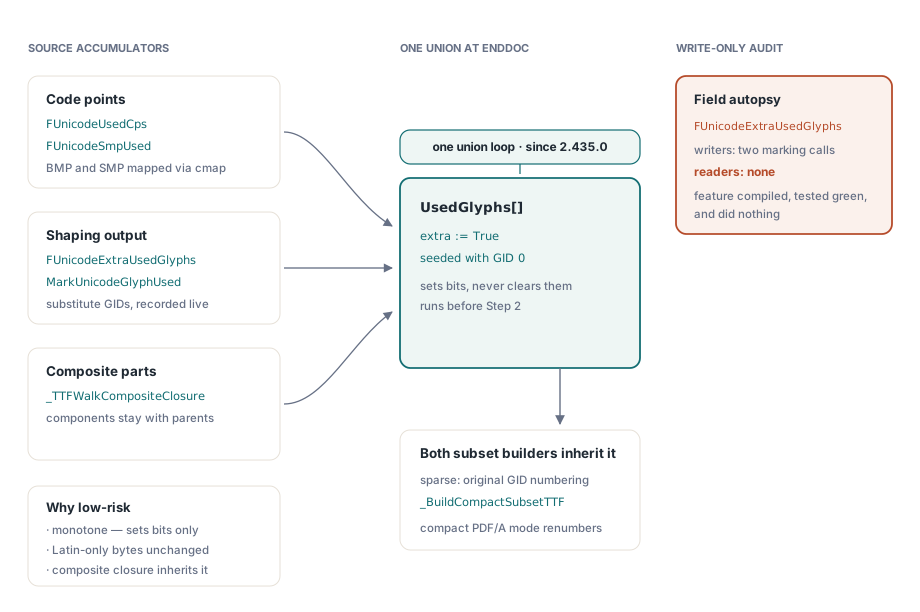
Um fecho de subset correto tem de unir três fontes independentes, cada uma com o seu próprio acumulador. A primeira é o conjunto derivado dos pontos de código: o HotPDF acumula FUnicodeUsedCps à medida que carateres BMP são emitidos e FUnicodeSmpUsed para carateres do plano suplementar alcançados através de pares substitutos, depois mapeia cada um através de FUnicodeCpToGid para um ID de glifo. A segunda é o conjunto derivado do shaping, os IDs de glifo que uma substituição GSUB produziu, registados através de MarkUnicodeGlyphUsed e EnableShapingFeatureForSubset em FUnicodeExtraUsedGlyphs. A terceira é o fecho de compostos: um glifo cujo numberOfContours é -1 em glyf é montado a partir de IDs de glifo componentes, e manter o composto enquanto se descartam os seus componentes produz um contorno vazio em vez de um .notdef, o que é discutivelmente pior porque se lê como um bug de espaçamento
O HotPDF sempre tratou a primeira e a terceira. BuildAndApplyUnicodeFontSubset, o ponto de entrada de subsetting que o EndDoc chama antes da serialização, semeia o array de glifos usados com o GID 0, percorre os pontos de código BMP, percorre a lista de utilização SMP, e entrega o array a um construtor de subset que resolve internamente os componentes de compostos. A segunda fonte foi escrita mas nunca consumida, e porque as três fontes falham em conteúdos diferentes, a lacuna consegue esconder-se durante anos numa base de código cujo corpus de regressão é maioritariamente em Latim
O array que foi escrito e nunca lido
O contrato estava documentado em três sítios e respeitado em nenhum deles. A declaração de FUnicodeExtraUsedGlyphs afirmava que o subsetter do EndDoc o unia com a utilização derivada dos pontos de código; o comentário de cabeçalho em ApplyArabicGSUBRefinement prometia que cada GID substituto emitido é passado por MarkUnicodeGlyphUsed para que o subsetter puxe o glifo para o tipo de letra incorporado; a mesma promessa aparece textualmente em ApplyArabicGSUBContextualRefinement para o caminho rclt. Ambos os chamadores cumpriram a sua metade. Uma pesquisa sobre cada referência ao campo resolveu a outra metade em cerca de noventa segundos: uma declaração, uma alocação SetLength dentro de RegisterUnicodeTTF, e escritas nas duas rotinas de marcação. Nem uma única leitura. Esse é o diagnóstico que vale a pena interiorizar, porque se generaliza bem para além de tipos de letra. Quando um campo é escrito por vários pontos de chamada e lido por nenhum, a funcionalidade que representa não existe, por mais bem comentada que esteja. O Passo 1 do subsetter é suficientemente pequeno para se ler num único ecrã, e a lacuna é óbvia assim que se sabe onde procurar
// Passo 1: deriva o conjunto de glifos usados (como estava antes da 2.435.0)
SetLength(UsedGlyphs, FUnicodeNumGlyphs);
for I := 0 to FUnicodeNumGlyphs - 1 do
  UsedGlyphs[I] := False;
UsedGlyphs[0] := True;                       // .notdef está sempre presente

for Cp := 0 to $FFFF do                      // fonte 1a: pontos de código BMP
  if (Cp < Length(FUnicodeUsedCps)) and FUnicodeUsedCps[Cp]
     and (Cp < Length(FUnicodeCpToGid)) then
  begin
    GID := FUnicodeCpToGid[Cp];
    if (GID > 0) and (GID < FUnicodeNumGlyphs) then
      UsedGlyphs[GID] := True;
  end;

for I := 0 to High(FUnicodeSmpUsed) do       // fonte 1b: pontos de código SMP
begin
  GID := FUnicodeSmpUsed[I].GID;
  if (GID > 0) and (GID < FUnicodeNumGlyphs) then
    UsedGlyphs[GID] := True;
end;

// a fonte 2 faltava aqui: nada alguma vez consultava FUnicodeExtraUsedGlyphs
A correção de um único ciclo, e marcar glifos você próprio
A correção é uma união, e o seu argumento de segurança vem da direção da operação: só ativa bits, nunca os limpa, pelo que nenhum glifo que antes sobrevivia ao subset pode agora começar a ser descartado
// v2.435.0: puxa glifos extra derivados de GSUB para dentro do subset.
// MarkUnicodeGlyphUsed / EnableShapingFeatureForSubset registam GIDs que
// o shaping produziu mas para os quais nenhum ponto de código emitido mapeia diretamente.
for I := 0 to FUnicodeNumGlyphs - 1 do
  if (I < Length(FUnicodeExtraUsedGlyphs)) and FUnicodeExtraUsedGlyphs[I] then
    UsedGlyphs[I] := True;
Três propriedades tornam isto uma alteração de baixo risco em vez de uma reescrita do motor de tipos de letra. É monótona, como acima. É um no-op em tipos de letra que nunca moldaram nada, já que FUnicodeExtraUsedGlyphs se mantém todo a Falso e a saída em bytes para um documento apenas em Latim não muda. E acontece antes do Passo 2, pelo que ambos os construtores de subset a herdam: o construtor esparso que preserva a numeração de GID original, e o construtor compacto _BuildCompactSubsetTTF que o HotPDF seleciona em PDF/A para renumerar os glifos mantidos para um intervalo denso, encolher o maxp.numGlyphs, e emitir o mapeamento antigo-para-novo como o stream /CIDToGIDMap exigido pelo ISO 32000-1 §9.7.4.2. Ambos chamam internamente _TTFWalkCompositeClosure, pelo que um glifo moldado que por acaso seja composto agora também arrasta consigo os seus componentes. O fecho de compostos nunca esteve avariado; simplesmente nunca era alcançado para estes IDs de glifo, porque os IDs de glifo não estavam no conjunto que ele percorre. Se conduzir o motor GSUB diretamente em vez de confiar nas passagens de refinamento incorporadas, o fecho passa a ser da sua responsabilidade, e cada ID de glifo substituto que emitir tem de ser marcado antes de o EndDoc congelar o conjunto de glifos usados
var
  Pdf: THotPDF;
  GIDs: array[0..1] of Word;
  LigGID: Word;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'shaped.pdf';
    Pdf.BeginDoc;
    Pdf.RegisterUnicodeTTF('C:\Fonts\NotoNaskhArabic-Regular.ttf');
    Pdf.ShapingFeatures := [sfArabicGSUB, sfStandardLigatures,
                            sfContextualAlternates];

    GIDs[0] := Pdf.GetUnicodeGlyphForCodepoint($0644);   // lam
    GIDs[1] := Pdf.GetUnicodeGlyphForCodepoint($0627);   // alef
    if Pdf.ApplyLigatureSubstitution(GIDs, 0, 'liga', LigGID) then
      Pdf.MarkUnicodeGlyphUsed(LigGID);   // omita isto e obtém .notdef

    Pdf.EnableShapingFeatureForSubset('rclt');
    Pdf.CurrentPage.RtLTextOut(50, 700, 0, WideString(ArabicText));
    Pdf.EndDoc;
  finally
    Pdf.Free;
  end;
end;
EnableShapingFeatureForSubset é a contraparte em lote da chamada de GID único, e é deliberadamente conservadora. Percorre a lista de lookups GSUB à procura dos lookups ligados a uma tag de funcionalidade de quatro bytes sob o caminho de script e idioma atualmente selecionado, e marca os IDs de glifo substitutos que esses lookups podem produzir. É um no-op defensivo quando o tipo de letra não transporta tabela GSUB ou quando a funcionalidade está ausente desse caminho, pelo que chamá-la incondicionalmente é seguro. É também uma sobreaproximação por design: pode manter glifos que um dado documento nunca desenha. Para subsetting, a inclusão em excesso custa bytes e a inclusão insuficiente custa correção, o que torna essa troca fácil. A estrutura destes lookups, e as tabelas de cobertura que decidem quais glifos participam, é coberta no percurso pelas alternativas estilísticas GSUB em Delphi puro
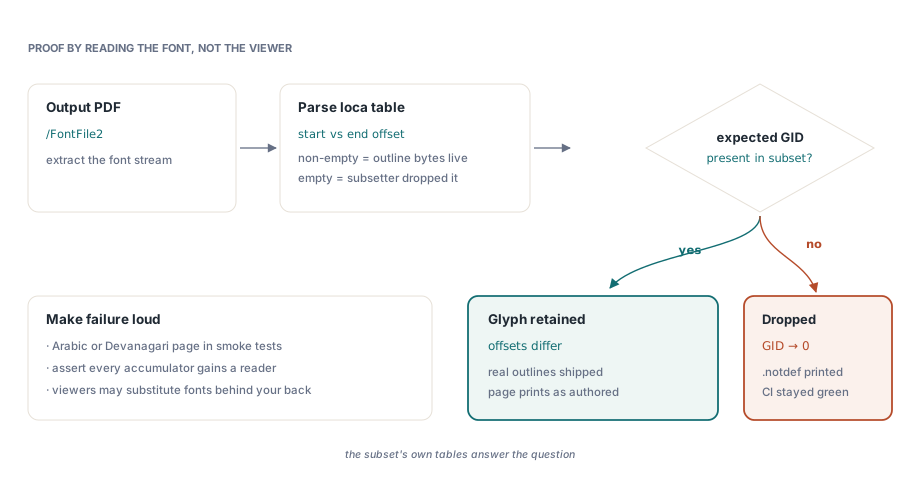
Como se prova que o glifo está realmente no subset?
Lendo o tipo de letra emitido, não olhando a olho para a página num leitor que pode estar a substituir por trás um tipo de letra do sistema. A verificação que apanha toda esta classe de bug é mecânica: extrair o stream /FontFile2 do PDF de saída, analisar loca, e confirmar que o ID de glifo esperado transporta uma entrada não vazia, ou seja os seus offsets de início e fim diferem. Uma entrada vazia é o subsetter ter decidido que o glifo não é usado. Dois hábitos tornam depois muito mais difícil enviar novamente a falha. Manter uma página de script moldado no corpus de smoke test automatizado em vez de apenas no conjunto de prova manual, porque o árabe, o devanágari e o khmer exercitam caminhos de fecho que nenhuma cobertura em Latim vai tocar. E sempre que existir um acumulador, verificar por assert que algo o consome, já que um campo apenas de escrita é uma funcionalidade que compila, passa nos testes no corpus errado, e não faz nada
Onde a correção para
O fecho de subset é necessário para que um glifo moldado renderize, e não é suficiente. O glifo também tem de ser endereçável a partir do content stream, o que é um problema separado com a sua própria fronteira. As passagens de refinamento árabe incorporadas do HotPDF só confirmam uma substituição quando cada ID de glifo substituto é alcançável através de um ponto de código de forma de apresentação Unicode via uma pesquisa inversa de cmap sobre cerca de 690 pontos de código entre U+FB50 e U+FDFF e U+FE70 e U+FEFF. Quando uma substituição cai num ID de glifo fora desse intervalo, a janela de entrada passa inalterada em vez de emitir algo que o leitor não consegue endereçar; alternativas específicas de tipo de letra em IDs de glifo arbitrários precisam de um ponto de código de uso privado sintético alocado entre U+E000 e U+F8FF para as transportar através do caminho de emissão. Por isso o resumo honesto é que a correção 2.435.0 removeu um bloqueador definitivo em vez de completar a história. Antes dela, um glifo podia ser corretamente moldado, corretamente emitido, e ainda assim desaparecer no momento do subset, o que significava que o motor de shaping não podia ser confiado de ponta a ponta por muito bons que fossem os seus lookups. O que resta é a endereçabilidade, e essa restrição pelo menos falha visivelmente no ponto de emissão em vez de silenciosamente num passo de build a correr depois de tudo o que se estava a observar. Para o lado da emissão do mesmo pipeline, ver o guia sobre shaping de texto árabe e RTL em PDFs Delphi
O subsetting de tipos de letra, o motor GSUB, e o shaping de scripts complexos aqui descritos vêm incluídos no HotPDF Delphi Component padrão para Delphi e C++Builder; a página de produto contém a referência de API completa para as chamadas de tipo de letra Unicode e shaping aqui nomeadas