Extrair o texto de uma página é a metade fácil do problema. No momento em que um utilizador escreve uma palavra numa caixa de pesquisa e espera que o visualizador salte para ela e a destaque a amarelo, precisa de algo que a cadeia de texto plana não lhe dá: a geometria da caixa onde a palavra apareceu
PDF Library for Delphi é uma biblioteca PDF nativa em Object Pascal para Delphi e C++Builder, e desde a v3.78.0 responde exactamente a essa pergunta. Três APIs de consulta assentam em cima do extrator de blocos de texto já existente: SearchText percorre um intervalo de páginas e devolve cada ocorrência como um registo com coordenadas; EnumPageElements fornece uma visão por página de texto e imagens; GetTextInAreaEx faz a consulta por região quando já sabe onde olhar. O importante não é que as APIs existam. É o facto de todas reutilizarem a mesma lista de blocos de texto com geometria, em vez de inventarem um segundo analisador paralelo
Porque a geometria vive na lista de blocos de texto, e não no funil
O instinto natural é reutilizar aquilo que GetPageText corre internamente. Esse caminho passa por um «funil» de extracção transitório que produz a cadeia de texto da página e depois se destrói antes de a chamada regressar. Quando já tem o resultado na mão, a estrutura geométrica já se foi. O funil foi feito para texto, não para caixas
As coordenadas, por outro lado, sobrevivem numa estrutura diferente. ExtractPageTextBlocks(3) devolve um identificador de lista de blocos de texto, cujos itens trazem cada um um quadrilátero de delimitação com oito valores Double, um nome de fonte, um tamanho de fonte e o texto do bloco. Esse identificador é o único sítio onde texto e geometria coexistem depois da extracção, o que faz dele a base certa para qualquer pesquisa que precise de desenhar um realce
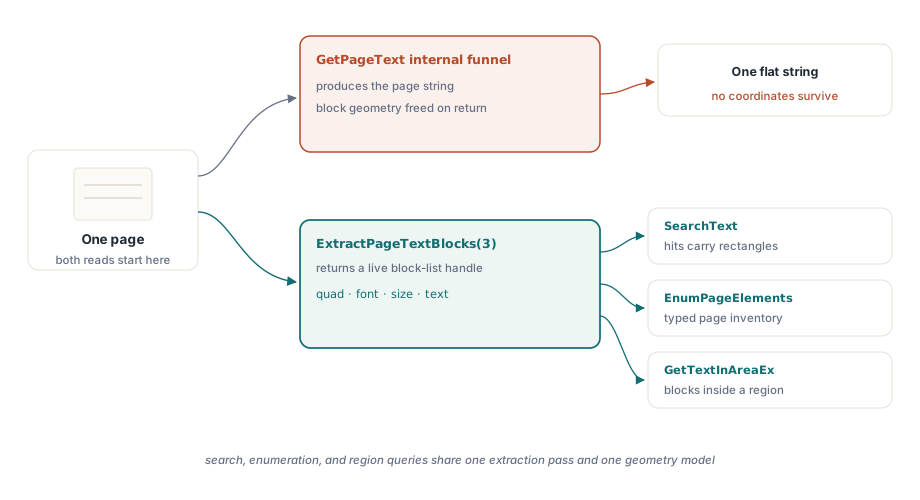
A forma de SearchText decorre dessa restrição. Para cada página no intervalo, extrai a lista de blocos, lê o texto de cada bloco com GetTextBlockText, testa-o contra a consulta e, para os blocos que correspondem, reduz o quadrilátero a um rectângulo e devolve a ocorrência como um pequeno record
type
  TPDFlibSearchHit = record
    Page: Integer;                       // página da ocorrência, a começar em 1
    Left, Top, Right, Bottom: Double;    // retângulo de hit alinhado aos eixos
    MatchText: WideString;               // o texto do bloco que continha a query
  end;
O array bound é intercalado em X/Y, não em quatro cantos
Este é o detalhe que primeiro costuma causar problemas. GetTextBlockBound(ListID, Index, BoundIndex) recebe um BoundIndex de 1 a 8, e esses oito valores não são «canto 1, canto 2, canto 3, canto 4» com dois campos agrupados como talvez esperasse. São X, Y, X, Y, X, Y, X, Y: os índices ímpares são coordenadas X, os pares são coordenadas Y; quatro pontos no total. Lê-los com o emparelhamento errado e o rectângulo não faz sentido
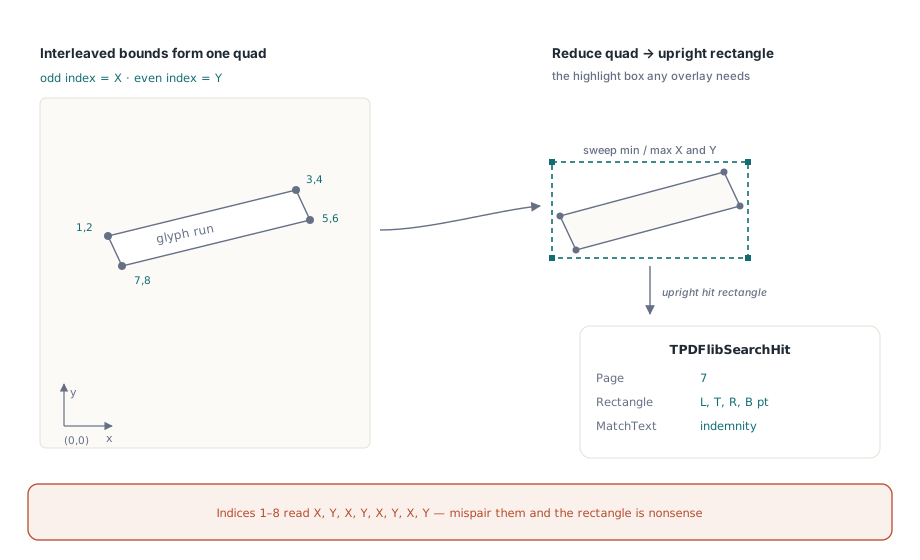
A razão de existir um quadrilátero, e não um simples rectângulo, é a rotação. Um bloco de texto colocado em ângulo tem um verdadeiro polígono de delimitação com quatro pontos, e os oito valores Double descrevem-no fielmente. Para o caso de realce e salto, quase sempre quer projectar esse polígono numa caixa alinhada aos eixos; é isso que os campos Left, Top, Right e Bottom do registo de ocorrência representam
var
  Pdf: TPDFlib;
  Hits: array[0..255] of TPDFlibSearchHit;
  Found, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('contract.pdf', '');
    // Search pages 1 to 10, case-insensitive, substring match.
    Found := Pdf.SearchText('indemnity', [], '1-10', Hits);
    for I := 0 to Found - 1 do
      if I <= High(Hits) then
        WriteLn(Format('p%d: [%.1f %.1f %.1f %.1f] %s',
          [Hits[I].Page, Hits[I].Left, Hits[I].Top,
           Hits[I].Right, Hits[I].Bottom, Hits[I].MatchText]));
  finally
    Pdf.Free;
  end;
end;
Note que o rectângulo está em pontos da área de utilizador do PDF, com a origem no canto inferior esquerdo da página, o mesmo sistema de coordenadas que passa para chamadas de desenho e anotação. Isso é deliberado: o rectângulo que recebe de uma ocorrência de pesquisa é o rectângulo que pode desenhar de imediato para o utilizar num realce ou numa anotação de texto em qualquer página já seleccionada
Sensibilidade a maiúsculas, palavras inteiras e onde o CJK difere
O segundo parâmetro é um conjunto TPDFlibSearchOptions formado por soCaseSensitive e soWholeWord. O conjunto vazio [] é o caso comum: uma pesquisa substring sem distinção entre maiúsculas e minúsculas. Adicione soCaseSensitive para tornar Indemnity e indemnity diferentes, adicione soWholeWord para impedir que sign corresponda dentro de signature, ou combine os dois
A correspondência de palavras inteiras precisa de uma definição de fronteira de palavra, e aqui a regra merece ser dita sem rodeios porque foi desenhada com base em ASCII. Um carácter conta como parte de uma palavra quando é uma letra ASCII, um dígito ASCII ou um sublinhado: a classe [A-Za-z0-9_] familiar das regras de identificadores. Uma correspondência só qualifica como palavra inteira quando os caracteres imediatamente antes e depois não são caracteres de palavra (ou quando a correspondência encosta à borda do bloco). Tudo o resto conta como separador. Isso mantém o comportamento previsível em formulários em inglês e código, mas também explica alguns resultados aparentemente estranhos noutros idiomas
A consequência para scripts não latinos é algo que convém saber antes de lançar uma caixa de pesquisa multilingue. Como os caracteres Han, kana e outras letras não ASCII ficam fora dessa classe, qualquer fronteira junto deles lê-se como extremidade de palavra. Isso faz com que a pesquisa por palavras inteiras seja muito conservadora em CJK. Se esse for o seu caso, deixe soWholeWord fora e trate a segmentação no nível da interface
Uma nota de implementação que explica uma classe de falhas subtis noutros sítios: a comparação sem distinção entre maiúsculas e minúsculas usa UpperCase sobre a WideString, não AnsiUpperCase. A variante Ansi devolve um AnsiString, que não alinharia com a WideString que o resto do caminho usa. Esse pormenor evita a armadilha dos dados truncados em meio caminho e mantém a comparação fora da via ANSI estreita
Um único analisador de intervalos para toda a biblioteca
O terceiro parâmetro é uma string de intervalo de páginas como "1,3,5-9". Não há nada de especial na forma como é analisada: o mesmo PLParsePageRangeList que suporta PrintPages e as rotinas de cópia de páginas também a trata aqui, portanto um intervalo que imprime correctamente também se pesquisa correctamente. Uma string de intervalo vazia é o sentinela para «todas as páginas»; nesse caso, o SearchText constrói a lista completa ele próprio
O escopo conta para o custo. Pesquisar uma faixa de dez páginas num documento de mil páginas extrai blocos de dez páginas, não de mil, porque o ciclo apenas selecciona e extrai as páginas nomeadas no intervalo. Quando já sabe que uma cláusula vive na secção 4, não paga o custo do resto do livro. É isso que torna a pesquisa por intervalo útil em trabalho interactivo e em lotes
Internamente, a pesquisa e a enumeração mudam ambas a página seleccionada à medida que percorrem o documento, por isso cada uma guarda a página seleccionada pelo chamador à entrada e restaura-a num bloco finally. Chamar SearchText a meio da montagem de uma página não lhe estraga o estado, e é esse tipo de disciplina que torna a API segura para composição
Enumerar uma página inteira: texto e imagens numa só lista
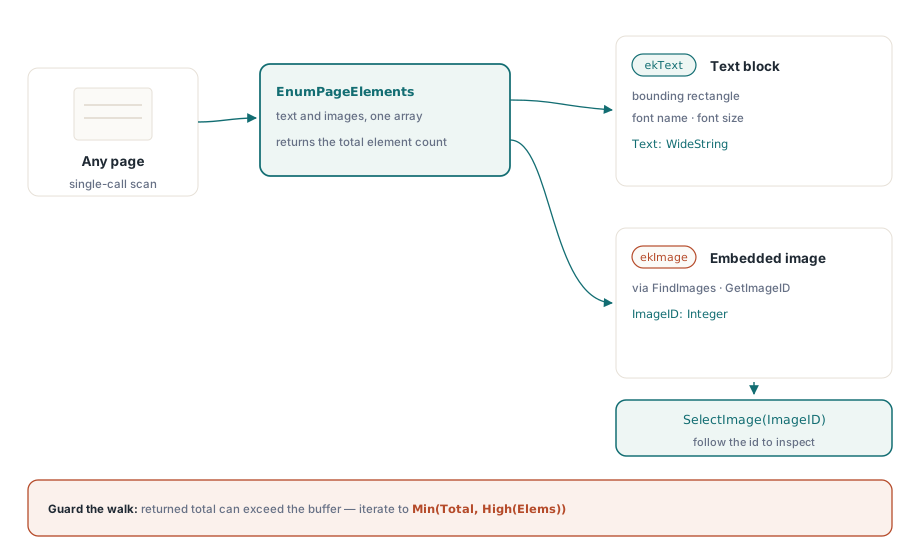
A pesquisa responde a «onde está esta palavra». A outra metade da introspecção é «o que existe nesta página», e isso é EnumPageElements. Devolve uma lista unificada onde cada elemento é ou um bloco de texto ou uma imagem incorporada, distinguida por TPDFlibPageElementKind. O resultado é uma vista estrutural da página, pronta para inspecção ou para indexação
type
  TPDFlibPageElementKind = (ekText, ekImage);

  TPDFlibPageElement = record
    Kind: TPDFlibPageElementKind;
    Page: Integer;
    Left, Top, Right, Bottom: Double;
    Text: WideString;        // ekText
    FontName: WideString;    // ekText
    FontSize: Double;        // ekText
    ImageID: Integer;        // ekImage; utilizável com SelectImage / GetImageID
  end;
Os elementos de texto vêm da mesma passagem ExtractPageTextBlocks, por isso cada um chega já com o seu rectângulo, o nome da fonte e o tamanho preenchidos. Os elementos de imagem vêm da lista de imagens incorporadas da página através de FindImages e GetImageID; o ImageID que transportam é o handle que alimenta o SelectImage para inspeccionar a imagem em detalhe. Os dois tipos caem no mesmo array, por isso uma única passagem por uma página vê tudo o que nela existe
var
  Pdf: TPDFlib;
  Elems: array[0..511] of TPDFlibPageElement;
  Total, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('report.pdf', '');
    Total := Pdf.EnumPageElements(1, Elems);
    for I := 0 to Total - 1 do
      if I <= High(Elems) then
        if Elems[I].Kind = ekText then
          WriteLn(Format('text  %s/%.1f  "%s"',
            [Elems[I].FontName, Elems[I].FontSize, Elems[I].Text]))
        else
          WriteLn(Format('image id=%d', [Elems[I].ImageID]));
  finally
    Pdf.Free;
  end;
end;
Há aqui uma convenção de contagem que segue o resto da biblioteca e que tem de respeitar ou vai ler memória não inicializada. O valor devolvido é a contagem total de elementos, que pode ser superior ao array que passou. A função preenche apenas os lugares que cabem e continua a contar o resto, exactamente como a enumeração de assinaturas funciona. Por isso a salvaguarda é sempre a mesma: limite o seu ciclo ao menor entre a contagem devolvida e High(array), nunca itere às cegas até à contagem. Os exemplos acima mostram a verificação I <= High(...) por essa razão. Se o valor devolvido exceder o seu buffer, dimensione um array maior e chame de novo
Se já usou os controlos de texto de nível inferior da biblioteca, esta é a camada tipada, consciente da geometria, em cima deles; a extracção subjacente é a mesma descrita em extracção de texto, imagens e fontes em PDF no Delphi com PDF Library for Delphi. E quando o objectivo não é «onde está este texto» mas «como está este documento estruturado para tecnologia assistiva», a história paralela do lado da leitura é a árvore de estrutura tagged PDF, que expõe a ordem de leitura lógica em vez da disposição física dos blocos
Consultas por região quando já sabe onde procurar
Por vezes não tem uma palavra de pesquisa; tem um rectângulo. Um modelo de factura coloca sempre o número da factura no canto superior direito, ou um layout digitalizado reserva uma faixa fixa para uma tabela. GetTextInAreaEx serve esse caso. É o homólogo com limites do GetTextInArea: onde a chamada mais antiga devolve uma lista plana de strings para uma região, esta devolve o rectângulo de cada bloco retido junto com o seu texto, por isso fica a saber não só o que está na caixa como onde cada linha se situa dentro dela
var
  Pdf: TPDFlib;
  Hits: array[0..63] of TPDFlibSearchHit;
  Found, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('invoice.pdf', '');
    Pdf.SelectPage(1);
    // Left, Top, Width, Height em pontos PDF na página selecionada.
    Found := Pdf.GetTextInAreaEx(360, 720, 180, 60, Hits);
    for I := 0 to Found - 1 do
      if I <= High(Hits) then
        WriteLn(Hits[I].MatchText);
  finally
    Pdf.Free;
  end;
end;
Há duas coisas que convém manter bem separadas. GetTextInAreaEx trabalha na página actualmente seleccionada, por isso chame SelectPage primeiro; ao contrário de SearchText, não recebe um intervalo. E um bloco é mantido quando intersecta o rectângulo da consulta, não apenas quando cabe por completo lá dentro. Isso torna-o útil para cabeçalhos, formulários e outros dados posicionados com exactidão
Pôr isto em prática
O fio condutor das três chamadas é que a geometria já não é algo que reconstrói a posteriori. Uma ocorrência de pesquisa conhece a sua página e a sua caixa. Um elemento de página conhece o seu rectângulo e, no caso do texto, a sua fonte. Uma consulta por região devolve o que intersecta a área, não uma string descontextualizada. Isso é o que permite ir da descoberta à acção sem uma segunda análise da página
Estas APIs de consulta fazem parte da PDF Library for Delphi Delphi PDF Library, juntamente com a camada completa de extracção de blocos de texto em que assentam e o restante conjunto de introspecção do lado da leitura para Delphi e C++Builder