O PDFlibPas, a PDF Library da losLab para Delphi, percorre name trees e number trees PDF com uma stack explícita e um conjunto de visitados desde a v3.539.45, por isso /Kids cíclicos, filhos partilhados e árvores com milhares de níveis de profundidade já não esgotam a call stack nem duplicam entradas. Desde a v3.539.51 um par /Limits em falta, malformado ou invertido nunca esconde um ramo que contenha a chave. Destinos nomeados, etiquetas de página, anexos e JavaScript ao nível do documento leem todos através destes dois caminhos de código, o que os torna parte da superfície de ataque de qualquer PDF que não produziu você próprio
O gatilho raramente é exótico. Um fuzzer, um upload hostil ou uma gravação incremental com bugs escreve uma entrada /Kids que aponta de volta para um ancestral, e um percursor recursivo morre com stack overflow num ficheiro de dois quilobytes. A falha mais silenciosa é uma procura que confia num array /Limits partido e reporta "not found" para um destino que está claramente lá
Onde é que as name trees e as number trees aparecem num PDF?
As name trees e as number trees aparecem onde quer que um PDF mapeie um conjunto grande de chaves para objetos, e o PDFlibPas lê pelo menos quatro delas através de APIs públicas. A ISO 32000-1 §7.9.6 define a name tree (chaves string, Table 36) e a §7.9.7 a number tree (chaves inteiras, Table 37). Ambas são árvores mais ou menos equilibradas cuja raiz e nós intermédios trazem /Kids, cujas folhas trazem os pares chave/valor ordenados em /Names ou /Nums, e cujos nós não raiz trazem um array /Limits de dois elementos com a menor e a maior chave por baixo deles
| Árvore | Onde vive | Especificação | API de leitura do PDFlibPas |
|---|---|---|---|
| Destinos nomeados | /Dests no dicionário de nomes | §12.3.2.3 | GetNamedDestination, depois GetDestPage / GetDestType |
| Etiquetas de página | /PageLabels no catálogo (number tree) | §12.4.2 | GetPageLabel |
| Anexos | /EmbeddedFiles no dicionário de nomes | §7.7.4, §7.11.4 | EmbeddedFileCount, GetEmbeddedFileStrProperty |
| JavaScript ao nível do documento | /JavaScript no dicionário de nomes | §7.7.4 | GlobalJavaScriptCount, GlobalJavaScriptPackageName |
Dois detalhes dessa tabela são fáceis de perder. Os destinos nomeados também têm uma forma mais antiga do PDF 1.1, um dicionário /Dests simples no catálogo indexado por objetos name, e o GetNamedDestination verifica esse dicionário primeiro antes de descer a name tree do PDF 1.2. E o GetDocJavaScript não é um leitor de name trees de todo: devolve os scripts ligados a triggers de documento no dicionário /AA do catálogo (WS, DS, WP, DP, DC), enquanto os pacotes de scripts nomeados que correm quando um documento abre vivem na name tree /JavaScript
Cada byte dessas estruturas vem do ficheiro. A especificação diz o que um escritor deve produzir; não consegue impedir um leitor de receber outra coisa, que é a mesma lição por trás de endurecer um parser PDF Pascal contra ficheiros maliciosos, aplicada aqui à forma da árvore em vez dos tamanhos de buffers
Porque é que um array /Kids cíclico crasha um percursor recursivo da árvore?
Um array /Kids cíclico crasha um percursor recursivo porque nada na recursão nota que já viu um nó antes, por isso um filho que referencie o seu próprio ancestral transforma um ficheiro finito numa descida infinita. Antes da v3.539.45, o NameTreeLookup, o NumTreeLookup, o EnumNumTree e o TPDFNameTree.ProcessNode interno chamavam-se todos a si próprios uma vez por filho. Uma única autorreferência chegava para acabar com o processo, e uma árvore legítima mas muito profunda podia fazer o mesmo sem ciclo nenhum
Uma variante mais suave corrompe resultados em vez de crashar. Quando duas entradas /Kids referenciam a mesma folha, uma enumeração ingénua visita-a duas vezes, e uma contagem de anexos ou uma lista de pacotes de scripts reporta entradas que não existem
A correção substitui a recursão por uma stack explícita last-in, first-out na heap e um conjunto de visitados indexado pela identidade do dicionário. Um nó é marcado quando é retirado, não quando é empurrado, por isso uma referência cíclica pode sentar-se na stack brevemente mas é descartada no momento em que volta a subir. Cada nó distinto expande os seus filhos exatamente uma vez, o que limita o trabalho total pelo número de dicionários distintos mais o comprimento total dos seus arrays /Kids. A profundidade deixa de interessar: uma cadeia de 4096 níveis são só 4096 iterações de um loop e 4096 entradas num hash set
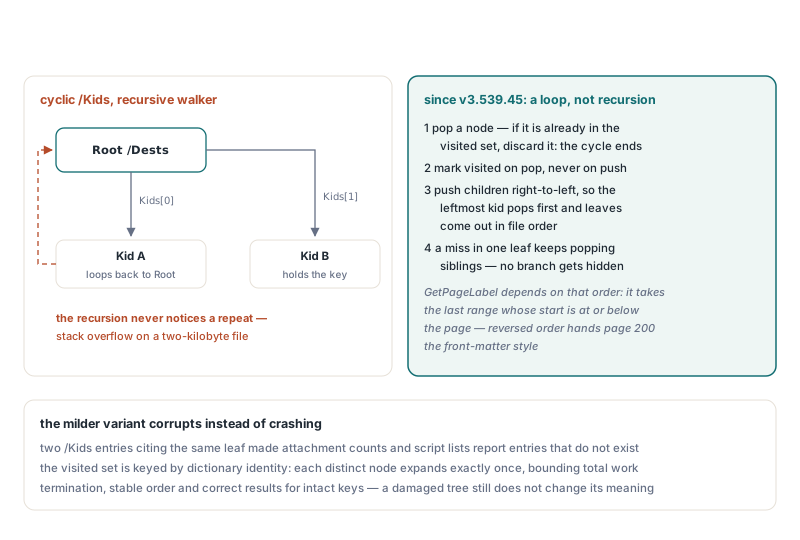
A ordem ainda interessa, no entanto, e a stack tem de ser alimentada ao contrário para a manter. Os filhos são empurrados do último índice para o primeiro, por isso o filho mais à esquerda é retirado primeiro e as folhas saem pela mesma ordem da esquerda para a direita com que o produtor as escreveu. O GetPageLabel depende disso: percorre todos os intervalos enumerados e aplica o último cujo índice inicial está no nível da página ou abaixo, por isso inverter a enumeração entregaria silenciosamente à página 200 o estilo da folha de rosto. O esqueleto abaixo mostra o padrão sobre um tipo de nó abstrato, independente de qualquer modelo de objetos PDF
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // vazio numa folha
    Keys: TArray<string>;      // chaves de folha, ordenadas por um produtor bem comportado
    Values: TArray<Integer>;   // paralelo a Keys
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// O /Limits é uma pista: só um par bem formado e ordenado pode podar um ramo
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // ciclo ou filho partilhado: já visto
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // Empurre da direita para a esquerda para o filho mais à esquerda sair primeiro
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // Uma falha nesta folha não é veredicto: continue a retirar irmãos
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
Porque é que uma procura não pode parar no primeiro ramo correspondente?
Uma procura não pode parar no primeiro ramo cujo intervalo corresponde, porque os intervalos /Limits num ficheiro real podem sobrepor-se ou mentir, e o ramo que reclama a chave não é necessariamente o ramo que a contém. As procuras anteriores à v3.539.45 punham uma flag Found no primeiro filho cujo /Limits cobria a chave, desciam nele e nunca olhavam para outro irmão. Se esse filho se revelasse vazio, obsoleto ou um loop de volta à raiz, a resposta era nil, mesmo quando o próprio irmão seguinte segurava a chave
O FindTreeValue reescrito, que agora sustenta tanto o NameTreeLookup como o NumTreeLookup, empurra cada filho cujo intervalo não exclui a chave e continua a retirar até encontrar uma correspondência ou esvaziar a stack. Uma falha dentro de uma folha é só uma falha dentro de uma folha. Numa árvore bem formada isto não custa nada extra; numa danificada custa mais algumas visitas a nós e devolve a resposta certa
A procura na folha segue a mesma filosofia. A ISO 32000-1 exige que as chaves num array /Names estejam ordenadas por valor de byte, por isso a folha é procurada primeiro com uma pesquisa binária. Se isso falhar, o PDFlibPas recua para uma varredura linear dos pares, porque uma folha fora de ordem tornaria uma chave presente invisível. Ordenar é um caminho rápido, não um filtro
A procura também se recusa a adivinhar numa contradição estrutural. A Table 36 deixa um nó trazer /Kids ou /Names, nunca ambos, e o caminho de procura trata um nó que traga ambos como malformado e salta-o em vez de escolher uma interpretação. Os caminhos de enumeração como o EnumNumTree são mais tolerantes e seguem /Kids quando ambos estão presentes
Para que pode um leitor confiar no /Limits?
Um leitor pode confiar no /Limits só para poupar trabalho, nunca para decidir que uma chave está ausente, e só quando o par está bem formado. A Table 36 diz que os nós intermédios e as folhas devem trazer /Limits como um array de dois elementos com a menor e a maior chave, mas na prática a entrada desaparece depois de edições à mão, contém números numa name tree, ou chega com os limites trocados. O PDFlibPas v3.539.45 e v3.539.51 resolvem cada caso da mesma maneira: se o intervalo não puder ser lido como um par ordenado do tipo certo, o filho continua pesquisável
/Limitsem falta: a antiga verificação de intervalo devolvia False e o filho era saltado por completo, por isso um produtor que esquecesse a entrada tornava toda a sua subárvore inalcançável. Desde a v3.539.45 o filho é pesquisado- Tipo errado ou comprimento errado, como números numa name tree ou um array de um elemento: tratado exatamente como uma entrada em falta desde a v3.539.45
- Limites invertidos como
[(Z) (A)]ou[9 0]: a v3.539.45 ainda os usava, e nenhuma chave pode satisfazerLo <= Key <= HiquandoLo > Hi, por isso o ramo era excluído para toda a procura. Desde a v3.539.51 um intervalo só é usado para podar quando o seu limite inferior não excede o superior - Bem formado, ordenado e correto: usado para saltar o ramo, que é todo o propósito da entrada
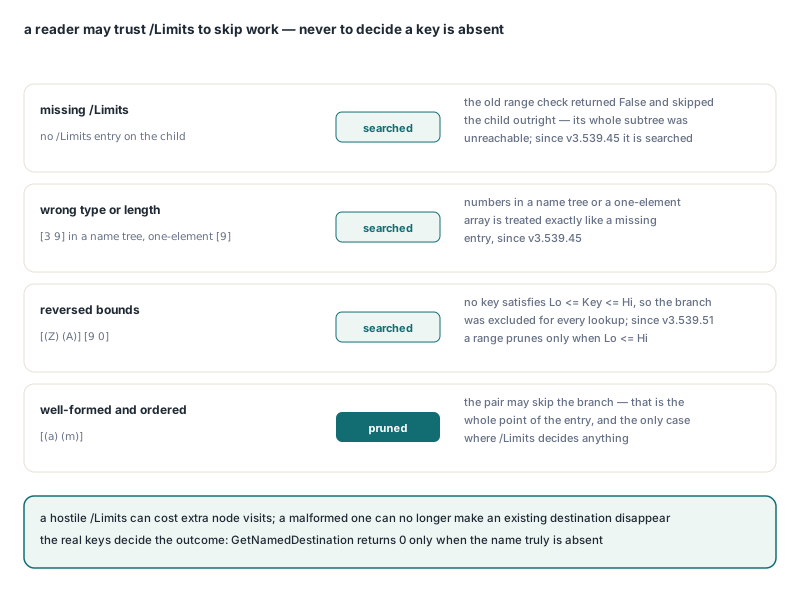
As chaves reais decidem o resultado em todos os casos. Um /Limits hostil pode fazer o PDFlibPas visitar mais nós do que o necessário, mas um malformado já não consegue fazer um destino existente desaparecer. Do lado de quem chama nada muda: o GetNamedDestination devolve 0 quando o nome realmente está ausente e um ID de destino caso contrário, e as funções de destino tomam-no a partir daí
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // Catálogo /Dests (PDF 1.1) primeiro, depois a name tree /Dests
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
      WriteLn('No destination named ', DestName)
    else if Lib.GetDestPage(DestID) = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Lib.GetDestPage(DestID),
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;
Corrido contra um ficheiro feito à mão cuja raiz /Dests tem um filho que faz loop de volta à raiz sob um intervalo [(a) (z)] e um segundo filho com a entrada real sob limites invertidos [(z) (a)], este procedimento resolve o destino para a página 2 com tipo de vista 2 (Fit). Antes da v3.539.45 a mesma procura devolvia 0, porque o filho em loop reclamava a chave primeiro e a procura nunca chegava ao irmão; só a v3.539.45 ainda devolvia 0, porque o intervalo invertido excluía a folha real. Se depois ler o outline que aponta para estes destinos, o artigo companheiro sobre ler ações de bookmarks e anotações PDF em Delphi cobre o lado das ações
Como é que uma folha com 32 769 nomes partiu o TPDFNameTree?
Uma folha com 32 769 pares nome/valor partiu o TPDFNameTree porque o seu FindIndex interno empacotava dois números num único Integer de 32 bits: a posição da folha na lista de arrays interna nos 16 bits altos e o offset da entrada dentro do array /Names dessa folha nos 16 bits baixos. Cada par ocupa duas posições do array, por isso o par 32 769, de índice 32 768, começa no offset 65 536, que é $10000. Esse valor transporta-se para a metade alta, e o descodificador lia-o de volta como offset 0 na folha seguinte
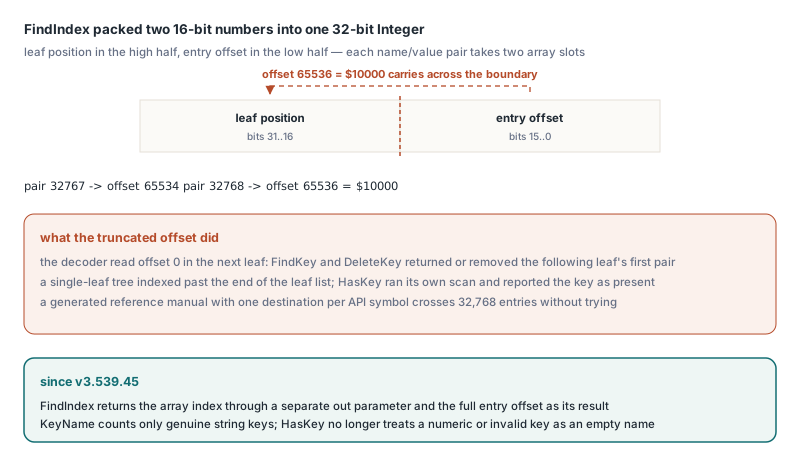
O TPDFNameTree é a classe por trás dos anexos, dos pacotes de JavaScript globais e das escritas de destinos nomeados, o que torna as consequências concretas. Numa árvore de folha única não há folha seguinte, por isso o FindKey e o DeleteKey indexavam para além do fim da lista de folhas; numa árvore de múltiplas folhas devolviam ou apagavam o primeiro par da folha seguinte em vez do pedido. Entretanto o HasKey corria a sua própria varredura e reportava a chave como presente, por isso a classe contradizia-se a si própria. Um manual de referência gerado com um destino nomeado por símbolo da API passa de 32 768 entradas sem se esforçar, e alguns produtores escrevem-nas todas numa única folha plana
Desde a v3.539.45, o FindIndex devolve o índice do array através de um parâmetro out separado e o offset completo da entrada como resultado, por isso nenhum valor é truncado. A mesma versão apertou dois vizinhos. O KeyName agora conta e devolve apenas chaves string genuínas e devolve uma string vazia para um índice de 0 ou abaixo, onde antes fazia cast do objeto que seguia uma chave inválida. O HasKey já não trata uma chave numérica ou inválida como um nome vazio. Para uma folha como [(Valid) 42 123 456], HasKey('') é agora False e KeyName(2) devolve uma string vazia
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // Number tree /PageLabels; ficheiros sem um devolvem números de página simples
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // Name tree /EmbeddedFiles; índices de base 1, chaves não string saltadas
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // nome, tipo MIME
    // Name tree /JavaScript: listar nomes de pacotes, executar nada
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
No mesmo ficheiro feito à mão, cuja raiz /PageLabels lista uma folha duas vezes e referencia-se a si própria, esta auditoria imprime i e A-1 para as duas páginas, cada intervalo uma vez, e o único pacote de scripts de uma árvore /JavaScript que também aponta de volta à sua própria raiz. O lado de escrita das etiquetas de página tem a sua própria história com raízes /Kids, coberta em corrigir etiquetas de página PDF guardadas em number trees /Kids; o AddPageLabels achata tal raiz antes de inserir, e depende da mesma enumeração EnumNumTree aqui descrita
O que é que este hardening ainda não garante?
O hardening garante terminação, ordem estável e resultados corretos para árvores cujas chaves reais estão intactas; não faz uma árvore danificada significar o que o seu autor pretendia. Vários limites valem a pena conhecer antes de construir sobre isto
- O conjunto de visitados funciona por identidade de objeto. Dois dicionários distintos com conteúdo idêntico são dois nós, por isso um produtor que copie uma folha em vez de a referenciar ainda produz entradas duplicadas
- Um
/Limitsbem formado, ordenado mas errado ainda poda. Um leitor que use intervalos como otimização não pode também ser imune a um intervalo que minta de forma plausível; a única alternativa é ignorar o/Limitspor completo e varrer todas as folhas - A enumeração preserva a ordem do ficheiro mas não ordena. O
GetPageLabelaplica o último intervalo enumerado no nível da página ou abaixo, por isso um produtor que escreva intervalos fora de ordem recebe semântica de ordem de ficheiro - A memória cresce com o número de nós e entradas distintos. O percurso acrescenta uma lista e um hash set, nada mais, mas uma name tree de 100 MB continua uma name tree de 100 MB depois da análise
- Chaves duplicadas dentro de uma folha não são reportadas. A pesquisa binária devolve o par correspondente que acertar primeiro; o fallback linear mantém a última correspondência que varre
Referência rápida: ler árvores PDF de ficheiros não confiáveis
- Faça upgrade para a v3.539.45 ou posterior para percurso de name trees e number trees seguro contra ciclos e contra stacks, e para a v3.539.51 ou posterior para que
/Limitsinvertidos já não escondam chaves - Trate o
GetNamedDestinationa devolver 0 como "ausente", e oGetDestPagea devolver 0 como "presente mas inutilizável" - Use
GlobalJavaScriptCounteGlobalJavaScriptPackageNamepara a name tree/JavaScript; oGetDocJavaScriptlê antes triggers/AAdo catálogo - Indexe anexos e pacotes de scripts de 1 até à contagem que a biblioteca reporta; chaves inválidas não são contadas
- No seu próprio código de árvores, marque nós como visitados ao retirar, empurre filhos pela ordem inversa, e deixe o
/Limitspodar só quando é um par bem tipado e ordenado
As ferramentas de pré-processamento, os arquivadores e os viewers leem estas árvores antes de qualquer página ser renderizada, por isso têm de sobreviver ao que quer que chegue a uma fila de uploads. Os leitores de árvores descritos acima vêm com o PDFlibPas, a PDF Library para Delphi, que compila tanto em Delphi como em Free Pascal