Um dicionário de encoder LZW está sempre uma entrada à frente do decoder que vai ler a sua saída, pelo que os dois lados não podem partilhar um único limite de largura de código. A PDFlibPas dá a TPLLZWEncoder e a TPDFLZWDecompressor limites separados derivados do mesmo flag EarlyChange, e essa vantagem de uma entrada é toda a razão pela qual o flag existe
Quase todas as implementações LZW feitas à mão falham no mesmo sítio. Escreve-se o decoder primeiro, porque é o que é preciso para abrir ficheiros. Funciona. Depois escreve-se o encoder, espelha-se a lógica do decoder linha a linha porque o LZW é simétrico, corre-se um teste de round-trip, e passa. Lança-se. Seis meses depois um cliente abre a sua saída num visualizador que não é o seu, e é lixo a partir de algum ponto no meio do stream. O espelho era o bug: as duas metades do LZW não são simétricas, e fingir que são produz streams que só o seu próprio código consegue ler
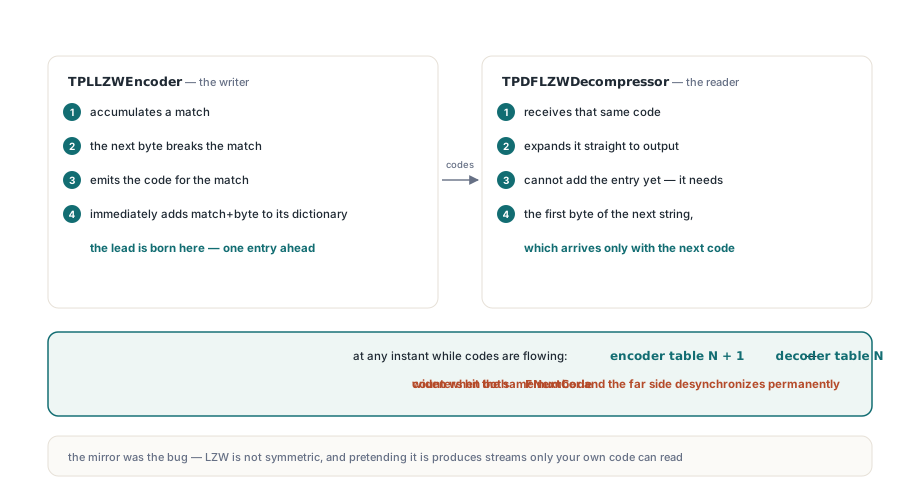
Porque é que o encoder precisa de um limite diferente do decoder?
Porque o encoder aprende cada entrada do dicionário um passo antes de o decoder poder. Isso não é uma escolha de design da PDFlibPas; é inerente à forma como o LZW funciona, e toda a implementação correta tem de compensar isso em algum lado. Percorra o loop e vê de onde vem a vantagem. O encoder acumula uma correspondência, descobre que o byte seguinte a quebra, emite o código para a correspondência e acrescenta logo correspondência-mais-byte ao seu dicionário. O decoder recebe esse mesmo código e expande-o, mas ainda não pode acrescentar a entrada correspondente, porque a nova entrada precisa do primeiro byte da string seguinte, que só chega com o código seguinte. Assim, em qualquer instante enquanto os códigos fluem, a tabela do encoder tem uma entrada a mais do que a tabela do decoder. Se os dois lados alargarem o código de 9 para 10 bits quando o seu próprio FNextCode atinge o mesmo número, alargam com um código de diferença e o leitor de bits do lado oposto fica permanentemente dessincronizado. Em TPDFLZWDecompressor.ResetDictionary o limite do decoder é calculado uma vez e guardado em FChangeCode:
// TPDFLZWDecompressor.ResetDictionary: o lado do decoder do limite
FCodeSize := FInitialCodeSize;                 // 9 para LZWDecode de PDF
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // alargar quando FNextCode chegar a 511
else
  FChangeCode := FBitMask + 1;                 // alargar quando FNextCode chegar a 512
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
O loop de descodificação alarga logo a seguir a acrescentar uma entrada, testando (FNextCode = FChangeCode) and (FCodeSize < 12) e recalculando tanto FBitMask como FChangeCode para a nova largura. Nove bits disparam em 511 ou 512, dez bits em 1023 ou 1024, onze bits em 2047 ou 2048, e doze bits é o teto onde o dicionário tem de ser lavado com um ClearCode em vez de crescer. O encoder não pode reutilizar nenhum desses números. O seu GrowCodeSize soma um para compensar a vantagem, pelo que com EarlyChange definido alarga em 512 enquanto o decoder alarga em 511:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 com 9 bits
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 com 9 bits
  // O decoder acrescenta a sua última entrada pendente antes de ler o EOI.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;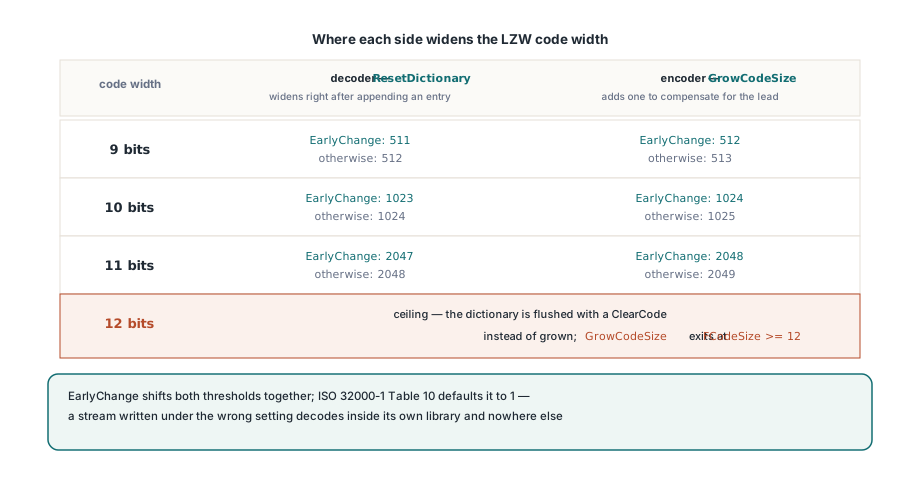
O último código de dados é onde os dois lados finalmente se encontram
O fim do stream é o único sítio onde o encoder tem de parar de liderar e pensar como o decoder, que é para isso que serve o parâmetro FinalDataCode em GrowCodeSize. Emita o código EOI com a largura errada e tudo o que vem antes continua perfeitamente válido, pelo que o defeito se esconde atrás de milhares de bytes corretos. A sequência é esta. O encoder emite o seu código de dados final e, ao contrário de todas as iterações anteriores, não acrescenta nada ao seu próprio dicionário depois, porque não há byte seguinte para estender a correspondência. O decoder faz o oposto: recebe esse código final, e só agora consegue completar a entrada que tem vindo a segurar desde a anterior. No último passo o decoder apanha o atraso, a vantagem colapsa para zero, e a largura que vai usar para ler o EOI é decidida por uma entrada que o encoder nunca fez. Dec(ChangeCode) é o encoder a fingir, durante exatamente uma chamada, que é o decoder:
// TPLLZWEncoder.Compress, a cauda do stream
EmitCode(CurCode);      // código de dados final, com a largura que estiver atual
GrowCodeSize(True);     // pode alargar usando o limite decrementado
EmitCode(FEOICode);     // EOI com a largura que o decoder vai realmente ler
FlushBits;
FlushOutput;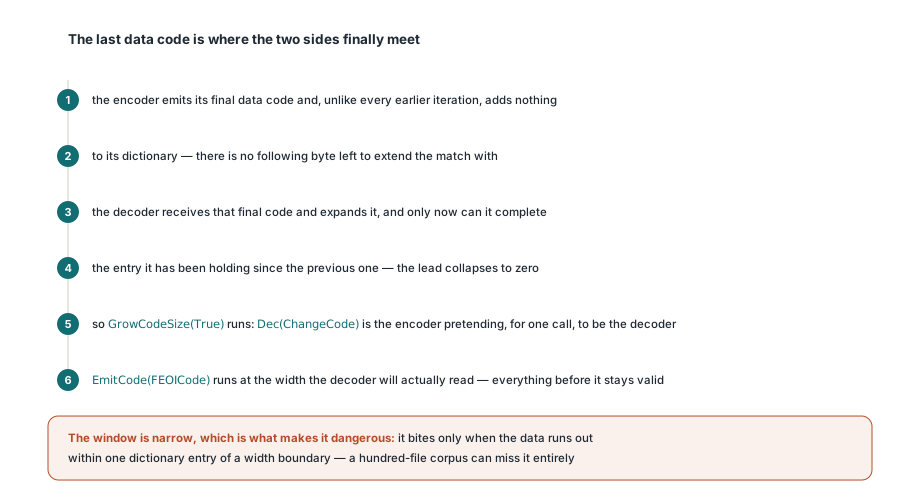
A janela em que isto importa é estreita, e é isso que a torna perigosa. Só morde quando os dados se esgotam a uma entrada de dicionário de uma fronteira de largura, pelo que um corpus de cem ficheiros de teste pode falhá-lo completamente enquanto um único ficheiro de um cliente lhe acerta todas as vezes. Os casos de fronteira em Compress têm de ser conduzidos deliberadamente: crie entradas cujo dicionário aterre em 510, 511 e 512 entradas, e depois leia a largura de bits do EOI emitido do stream à mão em vez de a inferir de uma descodificação bem-sucedida
Porque é que um teste de round-trip que passa ainda pode esconder um stream avariado?
Porque duas implementações que cometem o mesmo erro concordam uma com a outra. Se o seu encoder e o seu decoder alargarem ambos um código cedo demais, ou ambos um código tarde demais, ficam em passo sincronizado, o round-trip reproduz a entrada byte a byte, e a suíte fica verde enquanto o stream que produziu é ilegível por qualquer outra coisa. Essa é a coisa mais valiosa a tirar do exercício inteiro: para o LZW, a auto-consistência não vale nada como evidência. Por isso o round-trip consigo próprio não pode ser o teste principal, e a PDFlibPas valida o caminho LZW de outras três formas. Streams de código construídos à mão, com o padrão de bits esperado escrito à mão, para que a afirmação seja sobre os bytes e não sobre o resultado de os descodificar. Interoperabilidade bidirecional contra implementações independentes, onde streams produzidos por este encoder são descodificados noutro lado e streams produzidos noutro lado são descodificados pelo TPDFLZWDecompressor. E descodificação diferencial, lendo os mesmos bytes duas vezes com EarlyChange definido nas duas direções, para que um stream que descodifica limpo com a definição errada lhe diga que as fronteiras de largura nunca foram exercitadas de todo:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // deliberadamente a regra errada para PDF
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A tem de corresponder à fonte; B NÃO deve corresponder. Se B também corresponder,
// a entrada era demasiado curta para cruzar uma fronteira de largura de código.
São as entradas externas que realmente dão esta cobertura. O material de teste atual cruza larguras de 9, 10, 11 e 12 bits e força 34 resets de dicionário num único stream, que é a única forma realista de provar que o caminho ClearCode no teto de 4095 funciona de todo. Se os seus fixtures nunca excedem uns quilobytes, nenhum desse código correu alguma vez. E quando uma correção muda o que o seu encoder produz, trate a saída antiga como avariada em vez de a tratar como uma baseline de compatibilidade que vale a pena preservar; um stream que mistura larguras de código incorretamente não é um formato legado, é um bug que deu por acaso em ser escrito em disco
O PDF diz 1, o TIFF diz que depende
A PDFlibPas define EarlyChange como True por predefinição tanto em TPLLZWEncoder como em TPDFLZWDecompressor, porque a Tabela 10 da ISO 32000-1 define EarlyChange como um parâmetro de descodificação LZWDecode com valor predefinido 1, o que significa que o comprimento do código aumenta um código mais cedo. Isso é especificado na secção 7.4.4.2 da ISO 32000-1 juntamente com os parâmetros do predictor, e um PDF que queira o outro comportamento tem de dizer /EarlyChange 0 explicitamente no seu dicionário /DecodeParms. O TIFF é a razão pela qual o flag é uma propriedade em vez de uma constante: a secção 13 do TIFF 6.0 descreve a compressão LZW sem a mesma afirmação inequívoca, e os encoders no mundo real dividiram-se historicamente sobre isso, que é muito provavelmente a razão pela qual a especificação PDF sentiu necessidade de dar nome ao parâmetro. Num pipeline de TIFF-para-PDF a definição não é, portanto, algo que possa codificar à força em nenhuma das pontas. O que o lado TIFF vier a precisar tem de ser transportado explicitamente para o /DecodeParms do PDF, ou converte um ficheiro que abria bem num que não abre. O mesmo cuidado aplica-se a FillOrder, onde foTop e foBottom selecionam de que extremidade do byte o leitor de bits enche, e ao diferencial horizontal do TIFF Predictor 2, que TPDFLZWParms transporta através de Predictor, Colors, BitsPerComponent e Columns. As nossas notas sobre reforçar o descodificador TIFF integrado para BigTIFF e layouts em tiles cobrem o resto desse caminho
Duas armadilhas mais pequenas que vale a pena nomear
Ambas são fáceis de ligar mal quando se tem os objetos encoder e decoder abertos lado a lado e se assume que a simetria se mantém também aí:
InitialCodeSizenão significa o mesmo nas duas classes.TPLLZWEncoder.InitialCodeSizeé a largura do símbolo de raiz, validada de 2 a 8, com oInitDictionarya derivarFClearCodecomo1 shl FInitialCodeSizee a definirFCodeSizecomoFInitialCodeSize + 1.TPDFLZWDecompressor.InitialCodeSizeé a primeira largura de código, validada de 2 a 9, com oResetDictionarya derivarFClearCodecomo1 shl (FCodeSize - 1). Para dados PDF normais de 8 bits as predefinições são 8 e 9 respetivamente e nunca se nota; defina ambos para o mesmo número à mão e construiu um par descasado- Descodificar LZW não confiável é um problema de segurança de memória antes de ser um problema de correção, porque os índices do dicionário vêm diretamente do ficheiro.
TPDFLZWDecompressorrejeita qualquer código acima de 4095 ou igual ou acima deFNextCode, recusa acrescentar entradas para lá de 4095, verifica a entrada restante em bits antes de cadaGetNextCodee expõeSawExplicitEOIpara que um chamador consiga distinguir um stream corretamente terminado de um que apenas ficou sem bytes. Um stream truncado não é um sucesso parcial. O levantamento mais amplo em reforçar um parser PDF em Pascal contra ficheiros maliciosos cobre a classe de defeitos que estes guardas fecham
O que isto lhe deixa
O LZW parece simétrico e não é. O dicionário do encoder lidera por uma entrada ao longo do corpo do stream e a vantagem desaparece no código final, pelo que uma implementação correta transporta dois limites mais um caso especial, e o flag EarlyChange desloca os dois limites em conjunto. Falhe um único código em qualquer um deles e produz uma saída que é válida até deixar de ser, sem erro e sem exceção em lado nenhum, apenas um visualizador algures a renderizar ruído. A fronteira honesta é que nada disto é testável a partir de dentro: nada na sua própria suíte consegue distinguir um stream correto de um consistentemente errado, pelo que a verificação de interoperabilidade não é uma passada extra opcional, é a única evidência real que alguma vez vai ter. As duas classes vêm na PDF Library for Delphi, que também trata do trabalho estrutural à volta descrito nas nossas notas sobre object streams e cross-reference streams, para Delphi e C++Builder em todas as versões de compilador que a biblioteca suporta