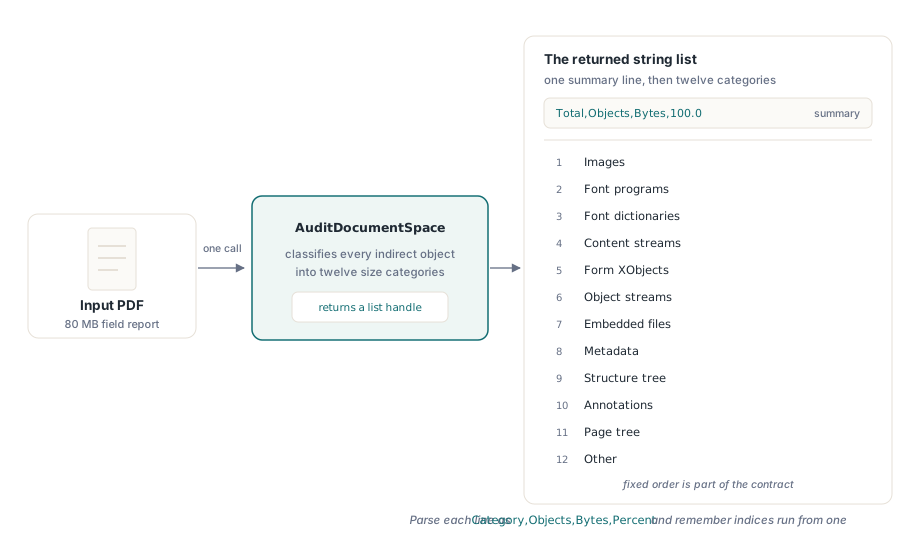
Para descobrir onde vai realmente o tamanho de um ficheiro PDF, a losLab PDF Library disponibiliza AuditDocumentSpace, que classifica cada objeto indireto em doze categorias — imagens, programas de tipo de letra, dicionários de tipo de letra, streams de conteúdo, form XObjects, object streams, ficheiros incorporados, metadados, árvore de estrutura, anotações, árvore de páginas, outros — e reporta a contagem de objetos, os bytes armazenados e a percentagem de cada categoria
A situação para a qual isto existe é familiar. Um relatório de 40 páginas sai do seu gerador com 80 MB, o cliente pergunta porquê, e tudo o que consegue oferecer é um palpite. Provavelmente as imagens. Talvez os tipos de letra. Então ativa a subamostragem, envia, e o ficheiro fica com 74 MB porque o peso real estava algures completamente diferente. O nosso artigo complementar sobre subconjuntos de tipos de letra e subamostragem de imagens cobre como reduzir um PDF; este cobre o passo que deveria vir primeiro, que é medir aquilo que está prestes a reduzir
Por que medir antes de comprimir?
Porque as três passagens de otimização standard têm ganhos radicalmente diferentes em qualquer ficheiro dado, e nada no ficheiro lhe diz qual se aplica até contar. Criar subconjuntos de tipos de letra num documento cujos tipos de letra já são 2% dos seus bytes é uma tarde gasta a mover um erro de arredondamento. Subamostrar imagens num ficheiro cujo volume são streams de conteúdo não comprimidos produz a mesma desilusão. O otimizador não é a parte difícil — todas as bibliotecas têm um. Saber para que otimizador apontar este ficheiro é a parte difícil, e essa é uma questão de contabilidade, não de compressão. Uma auditoria também apanha os casos em que nenhum otimizador é a resposta: um ficheiro que se revela ser 60% anexos incorporados não precisa de melhor compressão, precisa de uma conversa sobre se esses anexos pertencem ao documento, e um ficheiro que é 30% árvore de estrutura está a pagar por marcação de acessibilidade, o que é normalmente um custo deliberado que não deve retirar silenciosamente. Uma vez atribuídos os bytes, está a tomar uma decisão de produto com números por detrás em vez de recorrer ao interruptor mais próximo
O que contém o relatório de doze categorias
AuditDocumentSpace devolve um handle de lista de strings em vez de um registo, para que o relatório sobreviva intacto às fachadas planas de DLL e COM. A lista contém uma linha de resumo Total,Objects,Bytes,100.0 seguida de exatamente doze linhas Category,Objects,Bytes,Percent numa ordem fixa que faz parte do contrato: Images, Font programs, Font dictionaries, Content streams, Form XObjects, Object streams, Embedded files, Metadata, Structure tree, Annotations, Page tree, Other. Treze linhas, sempre, mesmo quando uma categoria está vazia
var
  Lib: TPDFlib;
  ListID, I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    ListID := Lib.AuditDocumentSpace;   // 0 quando nenhum documento está selecionado
    if ListID = 0 then
      Exit;
    try
      // GetStringListItem é baseado em 1: os itens vão de 1..GetStringListCount
      for I := 1 to Lib.GetStringListCount(ListID) do
        Memo1.Lines.Add(Lib.GetStringListItem(ListID, I));
    finally
      Lib.ReleaseStringList(ListID);
    end;
  finally
    Lib.Free;
  end;
end;
Um detalhe do Delphi naquele ciclo vai morder-lhe exatamente uma vez. GetStringListItem usa índices de item baseados em 1, coincidindo com GetStringListCount, e um índice fora do intervalo devolve uma string vazia em vez de lançar uma exceção. Escreva o ciclo como for I := 0 to Count - 1 por hábito e obtém uma primeira linha em branco, uma última linha silenciosamente perdida, e nenhuma exceção em lado nenhum a dizer-lhe que a indexação está errada. O próprio relatório vai parecer quase correto, que é o pior modo de falha que uma ferramenta de diagnóstico pode ter
Por que usa a auditoria o comprimento armazenado em vez do tamanho descodificado?
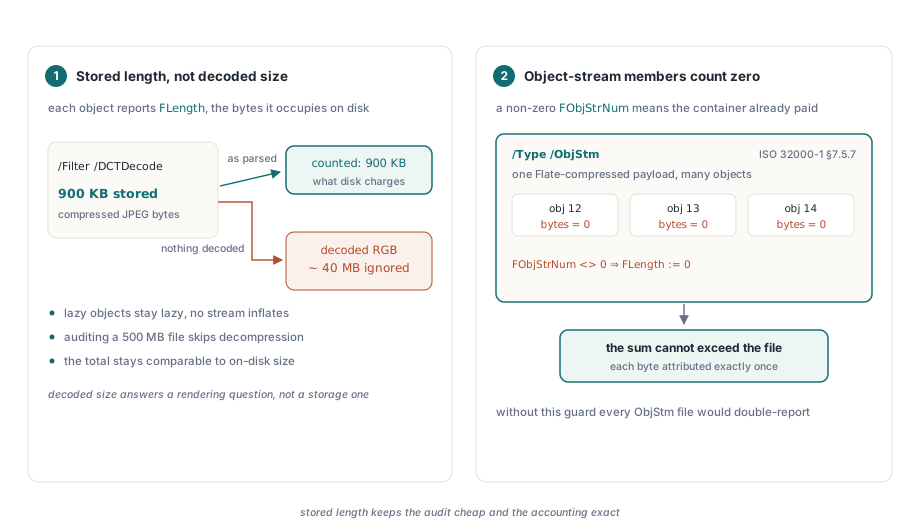
Porque o comprimento armazenado é ao mesmo tempo o número que se quer e o número que é barato de obter. Cada objeto indireto transporta TPDFIndObj.FLength, o comprimento em bytes em bruto que o objeto ocupa no ficheiro conforme analisado. Usá-lo significa que uma imagem DCTDecode de 900 KB é reportada como 900 KB — os bytes que lhe custa em disco — em vez dos 40 MB de amostras RGB para que descodifica. Também significa que a auditoria nunca tem de descodificar nada: os objetos carregados de forma preguiçosa permanecem preguiçosos, os filtros permanecem por executar, e auditar um ficheiro de 500 MB é uma passagem pelos cabeçalhos de objeto em vez de um ciclo completo de descompressão
A segunda regra é uma defesa contra contagem dupla. Quando um objeto vive dentro de um object stream comprimido, indicado por um FObjStrNum diferente de zero, a sua contagem de bytes é registada como zero. O seu armazenamento já foi pago uma vez pelo stream contentor, que a ISO 32000-1 §7.5.7 define como um stream /Type /ObjStm que contém muitos objetos numa única carga comprimida em Flate. Cobrar a cada membro a sua própria parte e depois cobrar de novo o contentor inflacionaria o total para além do tamanho real do ficheiro. Isto tem uma consequência direta na forma como lê o output, coberta abaixo e com mais profundidade no nosso artigo sobre object streams e cross-reference streams
Por que não consegue um programa de tipo de letra classificar-se a si próprio?
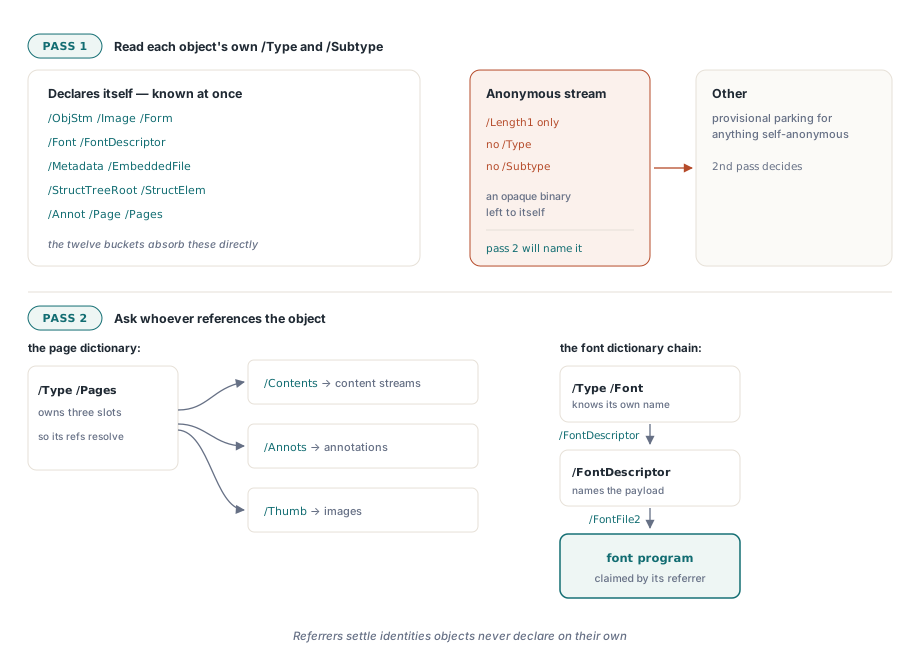
Porque um ficheiro de tipo de letra TrueType incorporado num PDF não tem qualquer marca a dizê-lo. A ISO 32000-1 §9.8.1 define o programa de tipo de letra incorporado como o valor de /FontFile, /FontFile2 ou /FontFile3 num descritor de tipo de letra, e o dicionário de stream do outro lado dessa referência transporta as chaves /Length1 e de filtro mas nenhum /Type e nenhum /Subtype que o identifique como um tipo de letra. Visto isoladamente, é um stream binário anónimo. Só o descritor que aponta para ele sabe o que é. A mesma assimetria aparece para as anotações: a §12.5.2 torna /Type /Annot opcional num dicionário de anotação, pelo que o sinal fiável é a pertença a um array /Annots de página, não o próprio dicionário
Assim, a classificação corre duas vezes. A primeira passagem lê o próprio /Type e /Subtype de cada objeto e apanha os ganhos fáceis: /ObjStm, /Subtype /Image, /Subtype /Form, /Type /Font e /Type /FontDescriptor, /Metadata, /EmbeddedFile e /Filespec, /StructTreeRoot e /StructElem, /Annot, /Page e /Pages. Tudo o resto cai provisoriamente em Other. A segunda passagem percorre depois o lado referenciador e sobrepõe: cada dicionário de página reatribui o seu /Contents a streams de conteúdo, as suas entradas /Annots a anotações, e o seu /Thumb a imagens, enquanto cada dicionário de tipo de letra percorre a sua própria cadeia de descritor
// Forma da segunda passagem: quem referencia nomeia o objeto
Descriptor := DictOf(FontDict.FindValueByKeyName('FontDescriptor'));
if Assigned(Descriptor) then
begin
  MarkRef(FontDict.FindValueByKeyName('FontDescriptor'), catFontDicts);
  MarkRef(Descriptor.FindValueByKeyName('FontFile'),  catFontPrograms);
  MarkRef(Descriptor.FindValueByKeyName('FontFile2'), catFontPrograms);
  MarkRef(Descriptor.FindValueByKeyName('FontFile3'), catFontPrograms);
end;
// Os tipos de letra Type0 mantêm o descritor um nível abaixo
Descendants := FontDict.FindValueByKeyName('DescendantFonts', True);
if (Descendants is TPDFArray) and (TPDFArray(Descendants).Count > 0) then
  MarkFontProgramRefs(DictOf(TPDFArray(Descendants).Item[0]));
Ler o relatório e escolher o próximo passo
Leia primeiro as percentagens, depois as contagens de objetos, e trate qualquer grande diferença entre as duas como um sinal. Um PDF moderno coloca a maioria dos seus pequenos dicionários dentro de object streams, pelo que Page tree e Structure tree mostram rotineiramente dezenas de objetos contra bytes quase nulos — o seu custo real foi absorvido pela linha Object streams. Se Object streams for por si só grande, o ficheiro está denso de estrutura tipo metadados em vez de conteúdo, e a alavanca é a poda de objetos, não a compressão. Os streams de aparência de anotação comportam-se de forma semelhante: transportam /Subtype /Form, pelo que um documento fortemente carimbado mostra o seu peso em Form XObjects enquanto a linha Annotations permanece pequena
function CategoryShare(Lib: TPDFlib; ListID: Integer;
  const Category: string): Double;
var
  I: Integer;
  Parts: TArray<string>;
  Inv: TFormatSettings;
begin
  Result := 0;
  Inv := FormatSettings;
  Inv.DecimalSeparator := '.';   // o relatório é independente de configuração regional
  for I := 2 to Lib.GetStringListCount(ListID) do   // a linha 1 é o Total
  begin
    Parts := string(Lib.GetStringListItem(ListID, I)).Split([',']);
    if (Length(Parts) = 4) and SameText(Parts[0], Category) then
      Exit(StrToFloatDef(Parts[3], 0, Inv));
  end;
end;
Dois factos de formatação importam se estiver a analisar as percentagens em vez de as apresentar. O separador decimal é sempre um ponto literal independentemente da localidade da máquina, pelo que analisar com as FormatSettings ambientes numa estação de trabalho alemã ou francesa vai falhar ou, pior, ler mal. E os zeros à direita são cortados, pelo que uma categoria que detém exatamente 40% dos bytes é impressa como 40, não 40.0 — nunca assuma uma casa decimal fixa. Com a percentagem em mãos, o encaminhamento é mecânico: uma percentagem de Images dominante aponta para DownsampleImages, uma percentagem de Font programs dominante para SubsetEmbeddedFonts, e Content streams volumosos para CompressContent
O que a auditoria deliberadamente não lhe diz
O total é uma soma sobre objetos indiretos, e um ficheiro PDF é ligeiramente mais do que os seus objetos. O cabeçalho do ficheiro, o trailer, os espaços em branco entre objetos e uma tabela de referências cruzadas clássica não são objetos indiretos, pelo que esses bytes não são atribuídos a nada e o total da auditoria fica ligeiramente abaixo do tamanho em disco. Um cross-reference stream é diferente — é um objeto real com /Type /XRef, pelo que num ficheiro moderno esses bytes aparecem, na categoria Other. Nenhum dos dois comportamentos é um defeito, mas se estiver a reconciliar a auditoria com uma contagem de bytes do sistema de ficheiros, é daí que vem a diferença
Mais duas fronteiras valem a pena ser ditas com clareza. Primeiro, os números descrevem um ficheiro que foi carregado, não um que está a ser autorado: para objetos construídos em memória que ainda não têm comprimento armazenado, o tamanho recorre ao output serializado com uma tolerância nominal para o dicionário de stream, o que é uma estimativa da eventual gravação em vez de uma medição. Faça a auditoria depois de gravar e recarregar se quiser números exatos. Segundo, uma linha Other volumosa é um achado, não um relatório de erro — normalmente significa objetos órfãos que já ninguém referencia, o que é um trabalho para recolha de lixo mark-and-sweep em vez de qualquer passagem de compressão
Usada desta forma, a auditoria muda a forma da conversa. Em vez de adivinhar sobre o relatório de 80 MB, abre-o, executa uma chamada, e lê que as imagens são 8%, os programas de tipo de letra são 61%, e o documento incorpora nove programas de tipo de letra completos para um estilo corporativo que usa três famílias. Essa é uma resposta corrigível com um número associado. AuditDocumentSpace, juntamente com as passagens de otimização para que aponta, é disponibilizado na losLab PDF Library para Delphi e C++Builder, onde as páginas de referência documentam a lista completa de categorias e a API de lista de strings à sua volta