Concatenar PDFs parece barato. O conteúdo das páginas já está paginado, as fontes já estão incorporadas, as imagens já estão comprimidas. Em princípio, uma mesclagem é apenas trabalho administrativo: renumerar os objectos à medida que entram e escrever os bytes de referência actualizados. O problema é que o PDF não funciona assim no detalhe, porque os objectos indirectos carregam IDs que atravessam o ficheiro inteiro
PDF Library for Delphi é um motor PDF nativo em Object Pascal para Delphi e C++Builder, e o seu percurso de mesclagem rápida existe para saltar essa volta sempre que isso é comprovadamente seguro. A ideia é estreita, mas compensa em conjuntos de documentos inteiros: para um objecto não-stream não modificado, a engine toma os bytes de origem tal como estão e faz uma única reescrita ao nível dos bytes das referências indirectas que eles contêm, transformando cada N G R em (N+Offset) G R. Sem tokenizer, sem árvore de objectos, sem serializador
Porque a renumeração de objectos é o verdadeiro custo de uma mesclagem
Cada PDF traz o seu próprio espaço de numeração de objectos. O ficheiro A tem o objecto 1, o objecto 2 e assim por diante; o ficheiro B tem o seu próprio objecto 1, objecto 2, e assim sucessivamente. Não pode despejar os objectos de B no ficheiro A sem alterações, porque os números colidiriam. A correcção é um deslocamento: se A termina no total de objectos Offset, o objecto N de B passa a objecto N+Offset na saída, e cada referência N G R que apareça em qualquer ponto dos objectos de B tem de ser deslocada para (N+Offset) G R para corresponder. E não basta mudar só os números que vê no topo: os números de objecto aparecem dentro de streams, anotações, árvores de estrutura, formulários e catálogos. Mesclar é, no fundo, reescrever apontadores, não copiar páginas
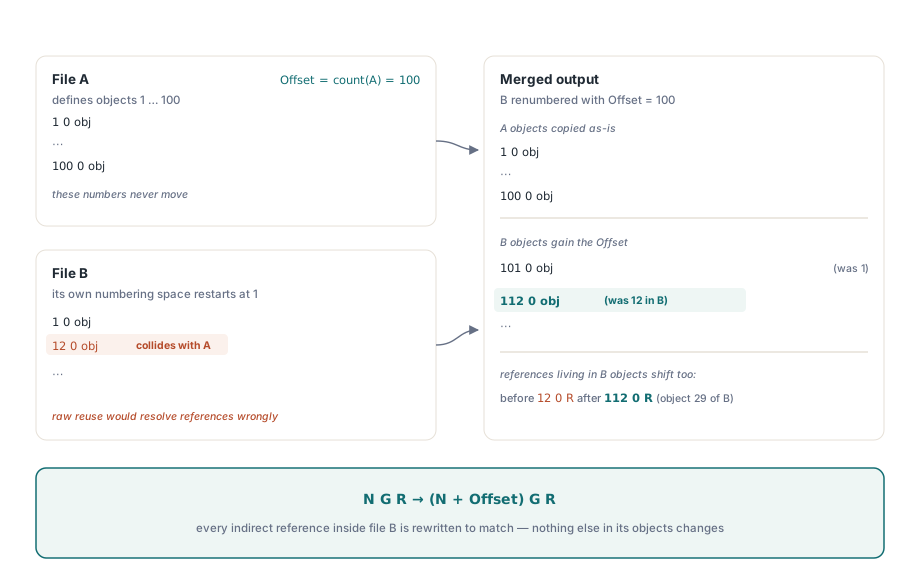
Esse deslocamento é o verdadeiro trabalho semântico da mesclagem do corpo. As correcções da page tree e a fusão do AcroForm são edições pequenas e limitadas a um punhado de objectos. O trabalho pesado é reescrever referências em milhares de objectos, e a forma ingénua de o fazer é percorrer cada objecto com um parse para encontrar as referências estruturalmente. A MergeFileListFast da PDF Library for Delphi defende o ponto de vista oposto: as referências também são localizáveis nos bytes em bruto, desde que se respeitem os contextos em que uma sequência dígito-espaço-dígito-espaço-R não é uma referência. Salte o parse, desloque no próprio lugar, e o custo por objecto colapsa para uma única passagem linear pelos bytes que iam ser copiados de qualquer forma
Quando reutilizar bytes de origem é comprovadamente seguro
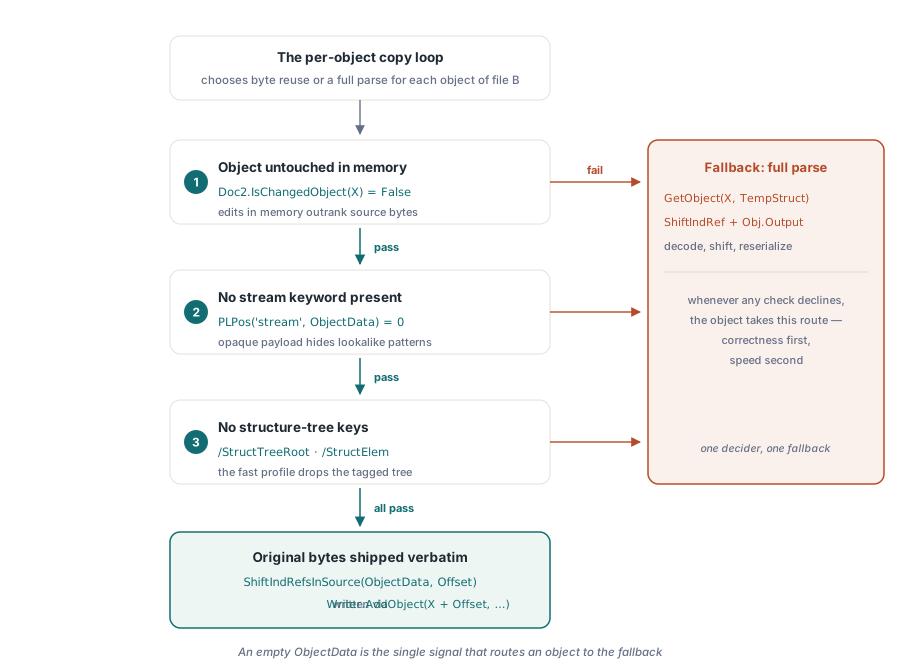
O caminho byte a byte só é usado quando se verificam três condições para o objecto que está a ser copiado de um documento seguinte. Se qualquer uma falhar, o objecto regressa ao percurso completo de descodificação e reserialização, pelo que a correcção não depende de um atalho optimista
Doc2.IsChangedObject(X)é False. Se o motor de mesclagem já alterou o objecto em memória, por exemplo um objecto de página cujo/Parentfoi redireccionado, a árvore em memória é a fonte da verdade e os bytes originais já não servem- Os bytes de origem não contêm a palavra-chave
stream. O corpo de um objecto de stream é binário opaco enquadrado porstream/endstream, e uma passagem ingénua de procura de referências sobre dados de stream comprimidos ou cifrados poderia "encontrar" e corromper padrões de bytes que parecem referências. Os objectos de stream mantêm o caminho original, consciente dos streams - Os bytes de origem não contêm nem
/StructTreeRootnem/StructElem. No perfil rápido, a árvore de estrutura tagged PDF é abandonada em vez de mesclada, pelo que esses objectos têm de seguir o caminho de descodificação, onde a engine os pode anular deliberadamente
A decisão vive no ciclo de cópia por objecto. Quando as três verificações passam, os bytes do objecto seguem directamente para ShiftIndRefsInSource e depois para o writer; caso contrário, os bytes são rejeitados e o objecto é reconstruído com GetObject, deslocado com ShiftIndRef e serializado
ObjectData := '';
if not Doc2.IsChangedObject(X) then
begin
  ObjectData := FastMergeObjectSource(Reader2, X);
  if (PLPos('stream', ObjectData) > 0) or
     ((not PreserveStructTree) and (PLPos('/StructTreeRoot', ObjectData) > 0)) or
     ((not PreserveStructTree) and (PLPos('/StructElem', ObjectData) > 0)) then
    ObjectData := ''                                  // recai para decode
  else
    ObjectData := ShiftIndRefsInSource(ObjectData, Offset);
end;

if ObjectData <> '' then
  Writer.AddObject(X + Offset, Doc2.GetGenNum(X), ObjectData)
else
begin
  Obj := Doc2.GetObject(X, TempStruct);              // caminho de parse completo
  // ... anular os objetos da struct tree, ShiftIndRef, Obj.Output ...
end;
Um ObjectData vazio é o sinal de que o caminho rápido recusou o objecto. Esse único sentinela mantém os percursos rápido e lento alinhados: existe exactamente um ponto onde a decisão é tomada, e exactamente uma fuga para o fallback
A máquina de estados de deslocamento de referências e os seus casos-limite
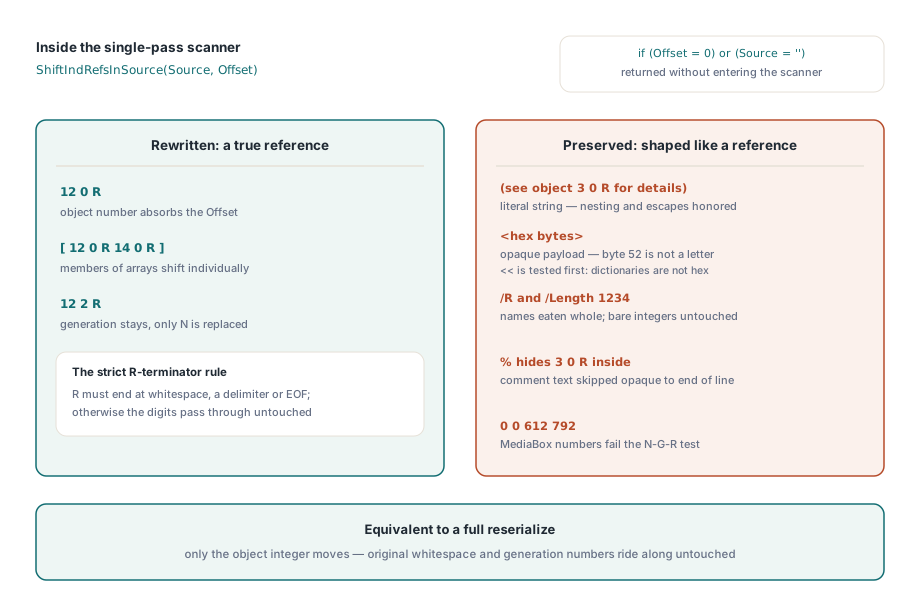
Uma reescrita de referências indirectas é traiçoeira, porque R e sequências de dígitos aparecem em todo o PDF em contextos que não são referências. ShiftIndRefsInSource é um pequeno scanner manual que percorre os bytes uma única vez e reescreve um número apenas quando este é seguido, com whitespace PDF entre os tokens, de outro número e de um delimitador R, somando o offset ao número de objecto e deixando todo o resto intocado
A correcção do scanner depende de reconhecer os contextos em que uma sequência com aparência de referência tem de ser deixada em paz. Estas são as fronteiras mais fáceis de falhar, e cada uma é tratada explicitamente:
- Strings literais delimitadas por
(e)são copiadas verbatim, com seguimento da profundidade de aninhamento e respeito pelo escape com barra invertida, para que um parêntesis escapado não estrague a contagem. Uma string como(see object 3 0 R for details)continua a ser texto, não uma referência - Strings hexadecimais entre
<e>passam sem interpretação. Os bytes52dentro de uma string hexadecimal são o código ASCII deR, e um scanner que tratasse o payload hexadecimal como texto podia fabricar uma referência fantasma. O<<de abertura de um dicionário é detectado primeiro, para que um dicionário não seja confundido com uma string hexadecimal - Objectos de nome começados por
/são consumidos por inteiro, da barra até ao próximo whitespace ou delimitador. Sem isto, um nome como/R(uma chave de recursos comum) podia ser lido como oRde uma referência - Comentários começados por
%são copiados até à quebra de linha e nunca são analisados como estrutura PDF. O scanner salta-os sem hesitar - O teste número-seguido-de-R é rigoroso. Uma referência só é reconhecida como
NwhitespaceGwhitespaceR, com oRterminado por whitespace, um delimitador ou o fim da entrada. Se faltar o número de geração, ou se umRfor seguido de uma letra, os dígitos são emitidos sem alterações. É isto que protege o inteiro em/Length 1234e os quatro números de umMediaBoxde serem incrementados às escondidas
O núcleo desse teste rigoroso lê quase exactamente como a frase da especificação descreve:
if (P <= N) and (Source[P] = 'R') and
   ((P = N) or PLIsPdfWhite(Source[P + 1]) or PLIsPdfDelimiter(Source[P + 1])) then
  Obj1 := PLStrToIntDef(PLCopy(Source, I, E1 - I), -1);

if Obj1 >= 0 then
begin
  AppendStr(PLIntToStr(Obj1 + Offset));   // número do objeto deslocado
  AppendBytes(E1, P - E1);                 // original whitespace + generation
  AppendBytes(P, 1);                       // the 'R'
end;
Só o número do objecto é reescrito; o número da geração e o whitespace exacto entre tokens são copiados tal e qual, pelo que a saída é byte-identical à entrada excepto pelo único inteiro que tinha de mudar. Isso é importante porque preserva a validade de assinaturas, filtros e consumidores sensíveis a espaços
Porque os bookmarks não podiam reutilizar AppendOutline
Mesclar os bookmarks de vários documentos numa única árvore de outline parece um trabalho para o auxiliar AppendOutline, que já sabe enxertar os bookmarks de topo de um documento noutro. É o instrumento errado aqui, e a razão é um desalinhamento subtil de camadas. O AppendOutline localiza o último bookmark de topo actual percorrendo o reader sobre os bytes originais do ficheiro. Mas a mesclagem rápida prepara as suas edições numa área de novos objectos através de ChangeObject, e o reader nunca vê essas edições. Encadeie três ou mais documentos e cada injecção volta a apontar o último bookmark original do primeiro documento para o documento mais recente, pelo que os bookmarks dos documentos intermédios caem fora da cadeia — só o /Count acumulado é que fica certo, o que torna o bug fácil de não notar até alguém abrir o painel de bookmarks
O caminho rápido resolve isso com uma injecção em duas fases, orientada por metadados, que nunca volta a percorrer o reader. A primeira passagem por todas as entradas recolhe, por documento, o objecto raiz da outline e os números de geração, o primeiro e o último número de bookmark de topo, e o /Count da raiz. A partir desse resumo, o código calcula, por aritmética pura de números de objecto, os números globais de cada ligação que precisa de forjar — o /Parent de topo de cada documento para a raiz partilhada, o /Prev do primeiro bookmark para o último do documento anterior, o /Next do último bookmark para o primeiro do documento seguinte. Existe uma restrição de ordem de escrita por trás disto: os objectos do primeiro documento são escritos antes mesmo de qualquer documento seguinte ser aberto, pelo que todas as edições de outline do primeiro documento (o /Count e o /Last da raiz, e o /Next do antigo último bookmark) têm de ser expressas como aritmética que não precisa de nenhum documento posterior em mão. As edições de cada documento seguinte são aplicadas no lugar depois de aberto mas antes de ser escrito, pelo que saem pelo mesmo caminho de change-object. A segunda passagem escreve os novos objectos já com as referências deslocadas e o outline remendado em simultâneo
A invariante de alinhamento dos offsets que junta tudo
Tanto o deslocamento de referências como a injecção de bookmarks dependem de uma única invariante aritmética, e ela é a suposição mais frágil de toda a concepção. Uma referência injectada num documento seguinte é escrita como o alvo global menos o número de objecto inicial desse documento, para que, quando o objecto for mais tarde deslocado por ShiftIndRef(Offset), o valor caia no número global pretendido. O primeiro documento recebe Offset = 0 e usa os números globais directamente
Resiste, porque há uma propriedade na forma como as mesclagens de páginas e formulários funcionam: AddPages, AddFields e AddFieldFonts só modificam os objectos existentes do primeiro documento, nunca acrescentam novos. Assim, a contagem de objectos do primeiro documento continua fixa, e o deslocamento dos documentos seguintes pode ser calculado de forma determinística
Três pontos de entrada sobre um único motor
O caminho rápido não é um fork do código de mesclagem. Na mesma linha de trabalho, o motor ao nível dos bytes foi factorizado numa única rotina interna, MergeFileListInternal(ListName, OutputFileName, PreserveStructTree, StrictMode), e as funções públicas só variam os parâmetros que importa expor
MergeFileListFastchama o motor com a preservação da árvore de estrutura desligada - o caminho mais leve, que abandona a árvore tagged PDF para que o percurso por bytes se aplique ao maior número possível de objectosMergeFileListchama-o com a preservação ligada, para que a tagged PDF tree sobreviva sempre que o objecto possa ser copiado tal como estáMergeFileListStrictmantém a mesma estrutura mas desactiva os atalhos tolerantes, útil quando quer medir exactamente o que o writer faz sem optimizações defensivas
Juntar os percursos também permitiu reconstruir a mesclagem normal de um ciclo par-a-par O(N²) - mesclar o ficheiro um com o dois, depois esse resultado com o três, e assim sucessivamente, reanalisando o acumulador crescente a cada passo - para uma única passagem sobre a lista de ficheiros. Isso removeu um segundo conjunto de caminhos quase iguais, e com ele uma classe de divergências difíceis de diagnosticar. Os dois pontos de entrada antigos para dois ficheiros e dois streams, MergeFiles e MergeStreams, ficaram intocados e continuam disponíveis para quem realmente quiser uma mesclagem par-a-par
Uma nota honesta sobre o comportamento da árvore de estrutura, porque isso deu cabo do conjunto de testes. O "drop" do caminho rápido não é total: remove a referência do catálogo do primeiro documento para /StructTreeRoot, mas o próprio objecto da árvore de estrutura continua no ficheiro se alguma parte anterior o tiver deixado alcançável. Assim, os bytes da saída rápida ainda contêm a string /StructTreeRoot, e não se distingue a saída rápida da comum por procurar essa string — a diferença real é se o catálogo ainda alcança a árvore de estrutura, que é o que determina se o ficheiro continua a ser um tagged PDF navegável. Isso é suficiente para os consumidores que só seguem o catálogo, mas não é uma purga completa do objecto
Quando escolher cada caminho
O caminho por bytes é uma optimização de throughput para montar muitos documentos quando não precisa de preservar a tagged PDF structure tree - bundling de relatórios, lotes de extratos, concatenação em massa. Medido em mesclagens repetidas sobre conjuntos grandes, o ganho vem de evitar descodificar e reescrever objectos que já estavam correctos. O caminho lento continua a ser o padrão quando a estrutura etiquetada importa mais do que o tempo total. Se precisar da árvore de estrutura intacta para acessibilidade, use o caminho de mesclagem comum de tagged PDF, que a preserva; e se estiver a trabalhar com um ficheiro único muito grande em vez de muitas entradas, as técnicas de cópia de bytes descritas no artigo complementar sobre a mesclagem e divisão de PDFs grandes com acesso directo ao ficheiro aplicam a mesma filosofia — copiar bytes, evitar a árvore de objectos completa — à escala do ficheiro
As rotinas de mesclagem e as suas variantes rápida e estrita fazem parte da PDF Library for Delphi Delphi PDF Library, cuja documentação inclui a referência completa para a API de listas de ficheiros e para as opções de mesclagem aqui descritas