Uma busca por "two-x" num PDF recém-gerado pode voltar com zero resultados enquanto a página mostra claramente esses cinco caracteres. Despeje a string extraída como code points e a razão está bem ali: o hífen voltou como U+00AD SOFT HYPHEN, e o espaço depois dele como U+00A0 NO-BREAK SPACE. Os dois parecem idênticos na tela. A diferença mora no CMap ToUnicode, a tabela que um reader consulta para transformar códigos de caractere de volta em Unicode, e ela vem de um glifo da fonte compartilhado por dois code points
Ferramentas de string comuns pioram o descasamento. Uma exportação CSV quebra a linha de um jeito diferente, uma ferramenta de diff marca duas linhas que se leem igual em todo viewer, e um verificador ortográfico trata "two-x" com hífen condicional como palavra desconhecida. A normalização Unicode só socorre pela metade: NFKC dobra o U+00A0 num espaço comum porque o NBSP tem decomposição de compatibilidade, mas o U+00AD não tem decomposição alguma, então o hífen condicional sobrevive a toda forma de normalização
Por que espaços extraídos voltam como U+00A0?
Espaços extraídos viram U+00A0 quando o CMap ToUnicode é indexado por glifo e um glifo pode ser alcançado por dois code points. Na Arial, o glifo 3 serve tanto ao U+0020 quanto ao U+00A0, e o glifo do hífen serve tanto ao U+002D quanto ao U+00AD. Um CMap construído pelo lado do glifo precisa dizer algo sobre o CID 0003, e o gerador do PDFium em FPDFText_LoadFont acaba dizendo duas coisas: uma entrada bfchar que o mapeia para U+0020, e um bfrange em forma de array que mapeia o mesmo CID para U+00A0
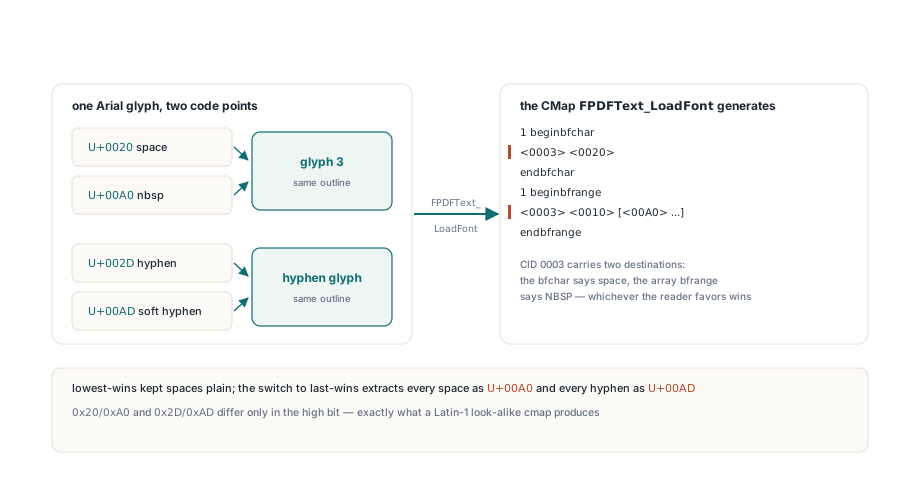
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
A ISO 32000-1 §9.10.3 descreve como bfchar e bfrange mapeiam códigos para Unicode, mas não diz qual entrada vence quando duas reivindicam o mesmo CID. Readers escolhem uma regra de precedência própria. Um reader que mantém o mapeamento menor ou primeiro extrai um espaço comum; o reader do PDFium mantém o último, e como o range em array vem depois do bloco bfchar, todo espaço gravado por um CMap indexado por glifo é extraído como NBSP e todo hífen como hífen condicional. O mesmo texto pode, portanto, ser extraído de forma diferente em dois viewers do mesmo arquivo
Os pares seguem um padrão. 0x20/0xA0 e 0x2D/0xAD diferem só no bit alto, que é o que uma fonte produz quando o cmap dela manda parecidos do Latin-1 para o contorno já usado pelo caractere ASCII. O Omega maiúsculo grego (U+03A9) e o sinal de Ohm (U+2126) compartilham um glifo na Arial também. Se um código de extração que antes passava agora falha em caracteres que você não consegue ver, imprima os code points em vez de confiar na visão de string do debugger; o básico de ler texto de uma página está em extração de texto de documentos PDF com PDFium em Delphi
Como o PDFium Component chaveia fontes do sistema por code point
O PDFium Component nunca pede ao engine que gere esse CMap para fontes do sistema que trazem um cmap Unicode. Quando o TPdf.AddText precisa de uma fonte, o componente lê a própria tabela sfnt cmap da fonte, preferindo uma subtable de formato 12 e recuando para o formato 4. Os code points voltam ordenados e sem duplicatas, e o CID k+1 é atribuído ao k-ésimo code point, com o CID 0 reservado para .notdef. Um CIDToGIDMap explícito manda cada CID para o seu glifo. U+0020 e U+00A0 recebem, portanto, dois CIDs diferentes que desenham o mesmo contorno, e o CMap ToUnicode que o componente grava mapeia cada CID para exatamente um code point
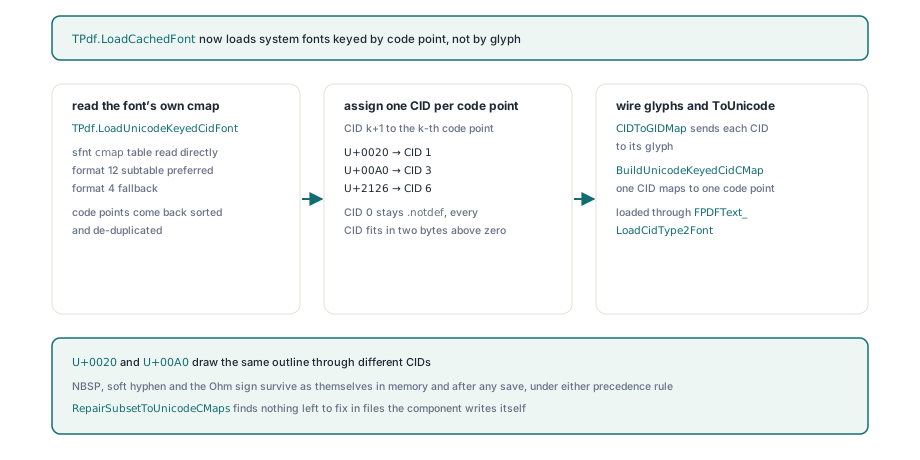
A fonte é carregada via FPDFText_LoadCidType2Font, o mesmo entry point por trás da escrita em nível de glifo em embutimento de fontes CID Type 2 com mapas CID-to-GID explícitos. Quando o FPDFText_SetText grava uma string depois, a busca reversa cai num único CID por caractere. Nada disso depende da regra de precedência do reader, porque não existe um segundo mapeamento para a regra escolher. O arquivo salvo também carrega o stream ToUnicode do próprio componente, então a extração depois de recarregar vê a mesma tabela um-para-um que o documento vivo usava
O custo é um CIDToGIDMap maior: dois bytes por code point que a fonte cobre. Suponha uma fonte que mapeia cerca de 3.000 code points. O mapa fica em torno de 6 KB, entregue ao engine junto com cada fonte. A troca vale a pena todas as vezes. Alguns kilobytes compram uma extração que lê igual no PDFium, em viewers que mantêm o primeiro mapeamento e em qualquer indexador que o seu cliente rodar no ano que vem
O round trip abaixo grava uma string que contém todos os pares problemáticos, extrai-a do documento não salvo, salva, recarrega e extrai de novo. As duas strings devem casar exatamente com a entrada; o helper CodePoints está ali só para tornar um descasamento legível:
uses
  SysUtils, PDFium;

const
  // Espaço/U+00A0 e hífen/U+00AD compartilham um glifo da Arial, assim como
  // o Omega grego (U+03A9) e o sinal de Ohm (U+2126)
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // documento vivo, não salvo
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // depois de um ciclo completo de salvar e recarregar
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
Mantenha o NBSP e o hífen condicional na string de exemplo mesmo que seus documentos raramente os contenham. Um teste que grava só ASCII passa contra um CMap indexado por glifo também, porque nada nele pede ao reader que escolha entre dois mapeamentos
Por que uma entrada bfrange pode apagar um bloco inteiro?
Um único bfrange cujo trecho de CIDs cruza uma fronteira xxFF faz o PDFium descartar o bloco inteiro em que ele está. A ISO 32000-1 §9.10.3 só deixa o último byte do destino variar dentro de um range, e o lado do CID tem uma armadilha correspondente no parser do PDFium: ele deriva o CID alto como (low and $FFFFFF00) or (high and $FF). Um trecho do CID 00FE a 0101 é lido como 00FE a 0001, baixo maior que alto, e o bloco inteiro é marcado como inválido. O SetText tem sucesso, a página renderiza corretamente, e a extração devolve U+0000 para cada caractere desse bloco
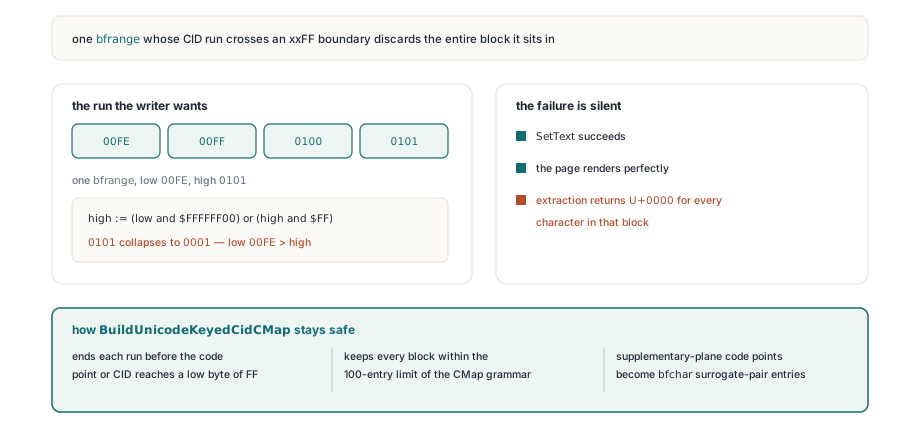
Uma fonte indexada por code point é exatamente onde isso morde. Os CIDs são densos e sequenciais, então qualquer fonte com mais de 255 code points produz trechos de CID que cruzariam 00FF, 01FF e por aí vai se o escritor simplesmente fundisse entradas consecutivas. O CMap que o PDFium Component grava encerra um trecho antes que o code point ou o CID alcance um byte baixo FF, e divide as entradas em blocos de no máximo 100, o limite que a gramática do CMap impõe a cada seção beginbfrange e beginbfchar
Code points acima de U+FFFF recebem entradas bfchar individuais cujos destinos são pares substitutos UTF-16, já que incrementar um par substituto dentro de um range não tem significado definido. O lado dos substitutos da história está em tratamento de emoji, CJK e pares substitutos em Delphi. Um CMap só com bfchar contornaria o problema de fronteira por completo, ao custo de várias vezes o tamanho, e é por isso que os ranges seguem como forma principal e as regras de divisão carregam o peso
Reparando conflitos ToUnicode em arquivos de outras ferramentas
O RepairSubsetToUnicodeCMaps na unidade FPdfCompress conserta o conflito indexado por glifo em arquivos que o componente não escreveu. O TPdf.SaveAs o executa em todo salvamento completo, não incremental, e você pode chamá-lo diretamente sobre qualquer stream. Para cada CID que carrega dois destinos, a entrada bfchar vence. Sem bfchar para o CID, um par que difere só no bit alto resolve para o code point base-Latin menor. Qualquer outro conflito mantém o primeiro mapeamento
O reparo edita os valores hex em conflito no lugar, com substituições de comprimento igual. O layout dos blocos, a cobertura de CIDs e todos os outros bytes do stream ficam como eram, então o CMap permanece na forma que o reader do PDFium já aceitava. Um CMap reconstruído do zero pareceria mais arrumado num dump hexadecimal. Também mudaria a estrutura de um stream que um reader estrito já aceitava, e essa é uma aposta sem vantagem quando só meia dúzia de valores de destino está errado
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // Só edições de mesmo comprimento; arquivos sem conflito reparável,
      // e arquivos com cross-reference stream ou object stream, são copiados como estão
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.
A rotina reconstrói uma tabela de cross-reference clássica, então documentos que usam cross-reference streams, referências híbridas ou object streams passam byte a byte. Salvamentos incrementais (saIncremental) pulam o reparo por design, porque uma revisão incremental precisa continuar append-only. Para texto que o próprio componente grava, nenhum dos casos importa: as fontes indexadas por code point dele nunca produzem um conflito para o reparo encontrar
Onde o caminho indexado por code point se aplica
O caminho indexado por code point cobre toda fonte que expõe uma subtable cmap Unicode, e o carregamento indexado por glifo do PDFium cuida do resto. Detalhes que valem saber antes de depender dele:
- Fontes symbol que só trazem um cmap (3,0), e qualquer fonte que o caminho CID não consegue carregar, passam pelo
FPDFText_LoadFont, em que um glifo compartilhado por dois code points fica sujeito à regra de precedência do reader - Com apenas uma subtable de formato 4 o mapa cobre o Basic Multilingual Plane; uma subtable de formato 12 na plataforma (3,10) ou na plataforma Unicode acrescenta code points do plano suplementar
- O glifo 0 e code points substitutos ficam de fora, e a contagem de entradas tem teto de 65535 para que todo CID caiba em dois bytes acima de zero
- TrueType Collections pedem cuidado extra: o
GetFontDatada GDI devolve o .ttc inteiro, e oFPDFText_LoadCidType2Fontnão tem parâmetro de índice de face, então passar a coleção adiante embutiria a face 0, SimSun, quando você pediu a NSimSun do simsun.ttc. O componente confere o nome de família contra a tabela de nomes da fonte (nameID 1 e 16) e entrega a face pedida como um sfnt independente; uma coleção que ele não consegue decodificar passa inteira e usa a face 0 - Se nenhuma fonte do sistema com o nome pedido puder ser lida, o
AddTextentrega o nome da fonte aoFPDFPageObj_NewTextObj, que o procura entre as fontes padrão do PDFium
Dobre caracteres invisíveis no índice, mantenha-os no texto
Uma vez que a extração devolve os code points reais, surge outra pergunta: o que um índice de busca deve fazer com um NBSP ou hífen condicional genuíno que o autor digitou de propósito? Dobre-os na camada de indexação e deixe o TPdf.Text em paz. A string extraída é o registro do que o documento diz; um índice é uma visão com perdas construída para casar padrões, e as regras de dobramento pertencem a ele
O helper abaixo é uma função que você acrescenta ao seu próprio código. Ele mapeia NBSP para um espaço e descarta o hífen condicional, que pela norma Unicode só marca um ponto em que a linha pode quebrar. Ele deixa o U+2126 intocado de propósito. A normalização NFC transformaria o sinal de Ohm em Omega, porque o U+2126 tem decomposição singleton canônica para U+03A9, e se uma busca em datasheets deve casar os dois é decisão de produto, não de extração:
uses
  SysUtils, Classes, PDFium;

// Helper seu para um índice de busca; não faz parte do PDFium Component
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // o texto exato continua em Pdf.Text
    end;
  finally
    Pdf.Free;
  end;
end;
Rode o IndexDocument no arquivo codepoints.pdf do primeiro exemplo e a linha indexada deve ler "two-x yz ΩΩ", onze caracteres com um sinal de Ohm como o último, enquanto o Pdf.Text ainda devolve todos os doze caracteres originais, NBSP e hífen condicional incluídos
Fontes indexadas por code point, o reparo de CMap e a extração de texto assentam todos no mesmo modelo de página em Delphi, C++Builder e Lazarus; a API de fontes e texto está coberta por completo na página de produto do PDFium Component for Delphi