Um lote de digitalizações pode ser nada além de um JPEG por página, sem fontes, sem anotações e sem bookmarks, e ainda assim falhar como PDF/raster. A ISO 23504-1 pede mais do arquivo que só páginas raster: ele precisa se identificar com um comentário %PDF-raster-1.0 na área de trailer, carregar metadados XMP e um /ID de trailer, e manter o catálogo e o dicionário Info em listas curtas de permitidos. Checar um lote de captura leva, portanto, duas leituras diferentes, uma sobre os bytes crus e outra sobre o que cada página realmente desenha
Duas leituras do mesmo arquivo
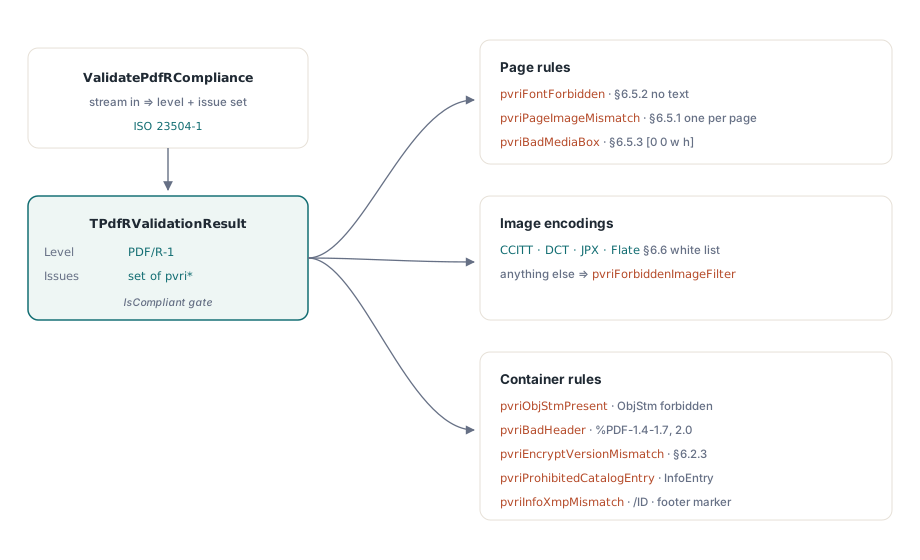
A validação PDF/R e o SaveAsPdfR vêm com as edições Small Business e Enterprise do PDFium Component, que divide a validação ao longo dessa linha. O ValidatePdfRCompliance na unidade FPdfPdfr lê um stream e confere as regras de nível de byte: versão do cabeçalho, o marcador raster, object streams, entradas de catálogo e Info, XMP, /ID de trailer, origens de MediaBox, recursos de fonte, nomes de filtro proibidos e se o número de objetos de imagem casa com o número de páginas. O ValidatePdfRPageFacts confere uma página por vez a partir de um record TPdfRPageFacts: quantos objetos de texto, path, form e shading a página desenha, onde a única imagem de faixa está, seu tamanho em pixels, profundidade de bits, espaço de cores e cadeia de filtros
Ambas as leituras reportam por uma única enumeração, TPdfRValidationIssue, e os entry points combinados as fundem num único TPdfRValidationResult. O campo Conformance dele vira prc1 só quando o marcador raster é achado, e o IsCompliant retorna True apenas quando o nível é prc1 e o conjunto de issues está vazio. Um arquivo perfeito em todo o resto mas sem o marcador reporta prcNone, o que surpreende as pessoas na primeira vez em que passam uma digitalização limpa por ali
A pergunta é de onde vêm os page facts. O TPdf.ValidatePdfR os coleta do documento carregado, mas primeiro serializa esse documento para um armazém temporário e roda as checagens de byte na cópia re-salva, então os vereditos de marcador e catálogo descrevem um salvamento fresco, que pode diferir do arquivo no disco. O ValidatePdfRasterSource em FPdfBusinessWorkflows tira um snapshot do stream de entrada e roda as duas leituras contra ele. Para um arquivo que está prestes a entrar num acervo, essa é a chamada a usar: o veredito então se refere aos bytes sendo arquivados
uses
  System.Classes, System.SysUtils, System.TypInfo,
  FPdfPdfr, FPdfReport, FPdfBusinessWorkflows;

procedure CheckDeliveredScan(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Options: TPdfRasterSourceValidationOptions;
  Report: TPdfRasterSourceValidationReport;
  Issue: TPdfRValidationIssue;
  I: Integer;
begin
  Options := TPdfRasterSourceValidationOptions.Default;
  Options.MaxInputBytes := 512 * 1024 * 1024;     // o orçamento padrão é 64 MiB
  Options.Validation.MinimumResolutionDpi := 200; // nosso contrato de captura
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if not ValidatePdfRasterSource(Src, Options, Report) then
    begin
      Log.Add(Format('Check stopped (%s): %s',
        [GetEnumName(TypeInfo(TPdfRasterSourceStatus), Ord(Report.Status)),
         Report.ErrorMessage]));
      Exit;
    end;
  finally
    Src.Free;
  end;

  if Report.IsCompliant then
    Log.Add('PDF/R-1 conformant')
  else
  begin
    // Validation.Issues guarda os issues de nível de byte mais cada issue de página
    for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
      if Issue in Report.Validation.Issues then
        Log.Add('File: ' + GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue)));
    // PageIssues diz quais páginas rescanejar
    for I := 0 to Report.ProcessedPageCount - 1 do
      for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
        if Issue in Report.PageIssues[I] then
          Log.Add(Format('Page %d: %s', [Report.Pages[I].PageNumber,
            GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue))]));
  end;

  // Guarde o veredito legível por máquina junto ao arquivo arquivado
  Log.Add(Report.ToJson(TPdfReportLimits.Default));
end;
Dois padrões no TPdfRasterSourceValidationOptions importam para lotes de digitalização. MaxInputBytes é 64 MiB e MaxPages é 1000; um lote longo de digitalizações coloridas pode estourar o orçamento de bytes, e a checagem então termina com status prssBudgetExceeded e Complete False. MemoryLimitBytes é 8 MiB, além do qual o snapshot transborda para TemporaryDirectory e o relatório define SnapshotSpilled. O Report.IsCompliant também exige Complete, então uma checagem que parou no meio nunca lê como aprovada
Por que uma camada de texto OCR reprova no PDF/R?
Porque uma página raster desenha a imagem digitalizada e nada mais. Uma camada OCR invisível é um acréscimo normal num fluxo PDF/A, e ela põe no arquivo duas coisas que o PDF/R exclui: um recurso de fonte, reportado pela leitura de bytes como pvriFontForbidden, e objetos de texto na página, reportados pela leitura de página como pvriNonRasterPageContent. O mesmo issue de página dispara para paths vetoriais, shadings e form XObjects, então um número de página carimbado ou uma borda desenhada falham do mesmo jeito que texto oculto
A relação página-imagem é igualmente estrita. Cada página precisa carregar exatamente uma imagem de faixa; o pvriPageImageMismatch dispara numa página sem imagem e numa página cuja digitalização foi gravada como duas imagens lado a lado. No lado dos bytes a contagem é feita sobre todo objeto cujo /Subtype é /Image, então qualquer objeto de imagem extra, uma soft mask anexada à faixa por exemplo, empurra o total para além da contagem de páginas
A geometria ganha duas checagens. O pvriBadMediaBox reporta um MediaBox que não começa em [0 0 ...]; a leitura de bytes inspeciona arrays numéricos inline. A leitura de página então compara os limites desenhados da faixa com o MediaBox e reporta pvriStripGeometryInvalid quando qualquer borda desvia mais que GeometryTolerancePoints, 0.5 ponto por padrão. Um driver de scanner que deixa uma margem branca escalando a imagem para 98% da página falha aqui, mesmo que a página pareça bem na tela. Definir RequireFullPageStrip como False desliga o teste de cobertura para arquivos internos em que uma margem é aceitável
Quais codificações de imagem passam
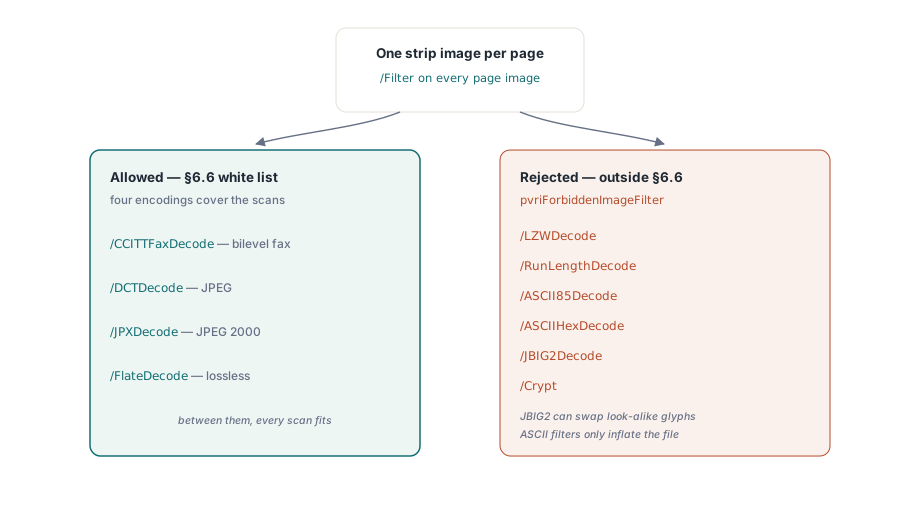
O validador aceita quatro filtros de faixa: /CCITTFaxDecode, /DCTDecode, /JPXDecode e /FlateDecode. A leitura de bytes marca os outros filtros padrão pelo nome como pvriForbiddenImageFilter: /LZWDecode, /RunLengthDecode, /ASCII85Decode, /ASCIIHexDecode, /JBIG2Decode e /Crypt
O JBIG2 é a rejeição que equipes de captura encontram primeiro. Ele é permitido no PDF/A e comprime páginas bilevel muito bem, então um perfil de captura construído para PDF/A pode já emiti-lo. O modo de casamento de padrões com perdas dele também é conhecido por trocar um glifo digitalizado por outro de aparência parecida, um problema documentado com dígitos em formulários digitalizados, e um acervo raster existe precisamente para que o que estava no papel seja o que está no arquivo. Recodificar essas páginas como CCITT Group 4 as mantém bilevel e sem perdas
A leitura de página vai um passo além e olha a cadeia de filtros junto com a profundidade de bits e o espaço de cores da imagem, reportando descasamentos como pvriImageCompressionParametersInvalid:
- Uma cadeia de mais de um filtro é rejeitada, então uma imagem Flate embrulhada em ASCII85 falha duas vezes, uma no lado dos bytes e outra aqui
/CCITTFaxDecodeprecisa estar numa faixa DeviceGray de 1 bit/DCTDecodeprecisa estar numa faixa de 8 ou 24 bits em DeviceGray ou DeviceRGB/FlateDecodeé aceito em faixas de 1 bit; uma página Flate de 24 bits reprova nesta checagem/JPXDecodeé aceito a 1, 8 ou 24 bits por pixel
Independentemente do filtro, uma faixa cujo espaço de cores não é DeviceGray nem DeviceRGB recebe pvriImageColorInvalid. Uma digitalização baseada em ICC ou CMYK, portanto, precisa ser convertida antes de ser embrulhada, e o lugar mais barato para isso é o perfil do scanner, antes de qualquer PDF ser gravado
Como a resolução da faixa é calculada
Quando a imagem carrega a própria resolução, a leitura de página a usa. Quando não carrega, a resolução efetiva é derivada de pixels e tamanho de página: largura em pixels vezes 72 dividido pela largura do MediaBox em pontos, e o mesmo para a altura. Suponha um scanner que grava uma faixa de 2550 por 3300 pixels numa página US Letter de 612 por 792 pontos. Isso dá exatamente 300 dpi nas duas direções. A mesma página a 600 por 776 pixels dá cerca de 70.6 dpi na horizontal, abaixo do mínimo padrão de 72, então a página leva pvriImageResolutionInvalid
A faixa padrão no TPdfRValidationOptions é de 72 a 2400 dpi. Esses limites só apanham páginas evidentemente quebradas. Um contrato de captura costuma prometer um mínimo específico, frequentemente 200 ou 300 dpi, e esse valor pertence ao MinimumResolutionDpi: uma página de 150 dpi passa na faixa padrão, e é exatamente a página que esse contrato foi escrito para excluir. Definir qualquer um dos limites como 0 desliga aquele lado da checagem
O ValidatePdfRPageFacts é público, então as mesmas regras podem rodar antes de qualquer PDF existir, direto do que o scanner reporta sobre cada imagem:
uses
  FPdfPdfr;

// Constrói page facts a partir da saída do scanner; este helper é seu, não faz parte da biblioteca
function ScannerStripFacts(PixelW, PixelH: Integer;
  PageWidthPt, PageHeightPt: Single; const Filter: string;
  BitsPerPixel: LongWord; ColorSpace: Integer): TPdfRPageFacts;
begin
  Result := Default(TPdfRPageFacts);
  Result.PageNumber := 1;
  Result.MediaWidth := PageWidthPt;
  Result.MediaHeight := PageHeightPt;
  Result.ImageCount := 1;
  Result.ImageRight := PageWidthPt;   // a faixa cobre a página inteira
  Result.ImageTop := PageHeightPt;
  Result.PixelWidth := PixelW;        // HorizontalDpi deixado em 0: derivado
  Result.PixelHeight := PixelH;
  Result.BitsPerPixel := BitsPerPixel;
  Result.ColorSpace := ColorSpace;    // 1 = DeviceGray, 2 = DeviceRGB
  SetLength(Result.Filters, 1);
  Result.Filters[0] := Filter;
end;

var
  Opts: TPdfRValidationOptions;
  Issues: TPdfRValidationIssues;
begin
  Opts := TPdfRValidationOptions.Default;
  Opts.MinimumResolutionDpi := 300;

  // JPEG colorido a 300 dpi em Letter: conjunto vazio
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'DCTDecode', 24, 2), Opts);

  // A mesma página comprimida com Flate a 24 bits:
  // [pvriImageCompressionParametersInvalid]
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'FlateDecode', 24, 2), Opts);
end;
Catálogo, dicionário Info e XMP
Além do /Type e do /Pages obrigatórios, a ISO 23504-1 só permite Version, ViewerPreferences, PageLayout, PageMode, AcroForm e Metadata no catálogo. O validador confere o catálogo contra as 21 chaves padrão fora desse conjunto e levanta pvriProhibitedCatalogEntry quando qualquer uma aparece, entre elas Outlines, Names, PageLabels, OpenAction, StructTreeRoot, MarkInfo, Lang, OCProperties e OutputIntents. A última importa na prática: um arquivo PDF/A sempre carrega um output intent, então um único arquivo não pode satisfazer os dois perfis
O dicionário Info pode guardar Creator, Producer, CreationDate e ModDate; Title, Author, Subject, Keywords e Trapped levantam pvriProhibitedInfoEntry. Um catálogo sem stream /Metadata leva pvriMissingXmpMetadata. Quando o stream está lá mas o XMP dele carece de qualquer um entre xmp:CreateDate, xmp:ModifyDate e xmp:MetadataDate, a constatação é pvriMetadataInvalid. O pvriInfoXmpMismatch compara Producer com pdf:Producer e Creator com xmp:CreatorTool. Datas ficam de fora dessa comparação porque as duas codificações legitimamente diferem, e valores do Info guardados como strings hex são pulados. Um gatilho típico é uma ferramenta posterior reescrevendo o Producer do Info sem tocar no XMP
As regras de contêiner restantes são curtas. O cabeçalho precisa ser %PDF-1.4 a %PDF-1.7 ou %PDF-2.0 (pvriBadHeader), qualquer stream /Type /ObjStm levanta pvriObjStmPresent, e um arquivo criptografado precisa usar cabeçalho %PDF-2.0 (pvriEncryptVersionMismatch). Com o RequireEncryptedPdf20Profile deixado ligado, o dicionário de criptografia também precisa declarar /V 5 ou 6 com /R 5 ou maior, ou o arquivo leva pvriEncryptedPdf20ProfileInvalid
Gravando os marcadores
O TPdfRSaveOptions carrega Creator, Producer, CreationDate, ModDate, DocumentId e InstanceId, e não tem campo para Title, Author, Subject ou Keywords porque o perfil os proíbe. StripInfoOptionalEntries e StripCatalogOptionalEntries têm como padrão True e removem as entradas excluídas da origem; defina qualquer uma como False e as entradas ficam, ao custo da conformidade. O TPdf.SaveAsPdfR preenche campos de opção vazios com os metadados e identificadores de arquivo do próprio documento carregado, remove a segurança, e então grava o marcador, os dicionários aparados, o pacote XMP e o /ID de trailer
uses
  System.Classes, System.SysUtils, PDFium, FPdfPdfr;

procedure WrapScanAsPdfR(const InFile, OutFile: string; Log: TStrings);
var
  Pdf: TPdf;
  Opts: TPdfRSaveOptions;
  Written: TFileStream;
  Res: TPdfRValidationResult;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := InFile;
    Pdf.Active := True;
    Opts := TPdfRSaveOptions.Default;
    Opts.Creator := 'Capture Station 4';   // Producer, datas e IDs vêm da origem
    if not Pdf.SaveAsPdfR(OutFile, Opts) then
      raise Exception.Create('PDF/R save failed: ' + InFile);
  finally
    Pdf.Free;
  end;

  // Confira os bytes que foram gravados, não o documento em memória
  Written := TFileStream.Create(OutFile, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfRCompliance(Written);
    if pvriPageImageMismatch in Res.Issues then
      Log.Add('A source page still has no single strip image');
    if pvriFontForbidden in Res.Issues then
      Log.Add('The source carries fonts; rescan or drop the text layer');
  finally
    Written.Free;
  end;
end;
Embrulhar muda só metadados e identificação. Uma página de origem que desenha texto vetorial, ou que não carrega imagem de faixa, sai do SaveAsPdfR com o mesmo conteúdo de página e reprova nas mesmas checagens de página. O conteúdo da página é deixado quieto de propósito, já que re-renderizar uma digitalização em silêncio mudaria justamente os pixels que o acervo pretende preservar. Rodar o CheckDeliveredScan da primeira listagem sobre o OutFile dá o veredito completo, leituras de página incluídas
Onde o PDF/R se encaixa num pipeline de captura
O PDF/R serve a entregas em que a digitalização em si é o registro e fidelidade é o contrato inteiro: imagem para fins probatórios, captura de cheques e remessas, acervos de desenhos de um scanner de grande formato. Assim que um documento precisa de texto pesquisável, tags, anexos ou bookmarks, ele pertence ao PDF/A, porque cada um desses recursos aterrissa nas listas de excluídos acima
Muitas equipes mantêm os dois. Um original PDF/R é gravado uma vez e nunca muda, e um derivado PDF/A com camada OCR serve à recuperação. Os validadores são independentes, então um único trabalho em lote pode conferir cada arquivo contra o perfil que ele alega. O lado de arquivamento está coberto em conformidade de arquivamento PDF/A e validação de preflight PDF/A, e a saída para impressão em validação de documentos PDF/X prontos para impressão
As checagens PDF/R mostradas aqui fazem parte das edições Small Business e Enterprise do PDFium Component para Delphi, C++Builder e Lazarus, ao lado de validadores para PDF/A, PDF/X, PDF/E e PDF/UA; edições e versões de IDE suportadas estão na página de produto do PDFium Component