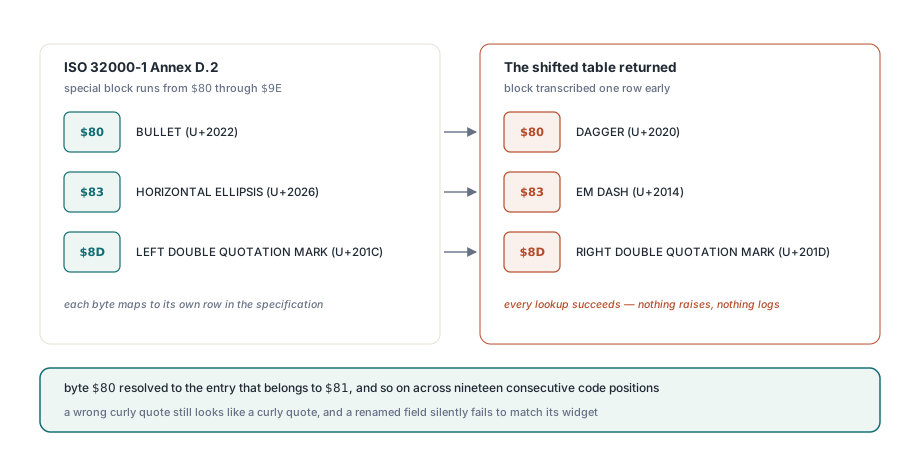
Importe um FDF num formulário e os valores dos campos voltam sutilmente errados: um bullet chega como dagger, uma reticência como em dash. O PDFium Component rastreou essa família inteira de sintomas até uma única linha na sua tabela de PDFDocEncoding — o bloco de caracteres especiais do Anexo D.2 da ISO 32000-1 começa em $80, não em $7F
Por que um import FDF devolve o caractere vizinho?
Porque uma tabela de codificação deslocada em uma posição continua sendo uma tabela de aparência perfeitamente válida, e todo lookup nela tem sucesso. O bloco que o Anexo D.2 atribui de $80 a $9E tinha sido transcrito uma linha antes, então o byte $80 resolvia para a entrada que pertence ao $81, o byte $81 para a entrada do $82, e assim por diante por dezenove posições de código consecutivas. Nada levantou, nada logou, e nenhum campo foi jamais rejeitado — o TPdf.ImportFDF reportava a mesma contagem de campos de sempre
O dano era uniforme e silencioso. Um byte carregando $80, que o Anexo D.2 define como BULLET (U+2022), voltava como DAGGER (U+2020). O byte $83, HORIZONTAL ELLIPSIS (U+2026), voltava como EM DASH (U+2014). O byte $8D, LEFT DOUBLE QUOTATION MARK (U+201C), voltava como RIGHT DOUBLE QUOTATION MARK (U+201D) — o caso que ninguém nota, porque uma aspa curva errada ainda parece uma aspa curva num campo de formulário. Nomes de campo sofriam o mesmo destino que valores de campo, o que é pior: um nome que não bate mais com o widget do documento silenciosamente deixa de aplicar
Strings de texto de PDF carregam duas codificações diferentes
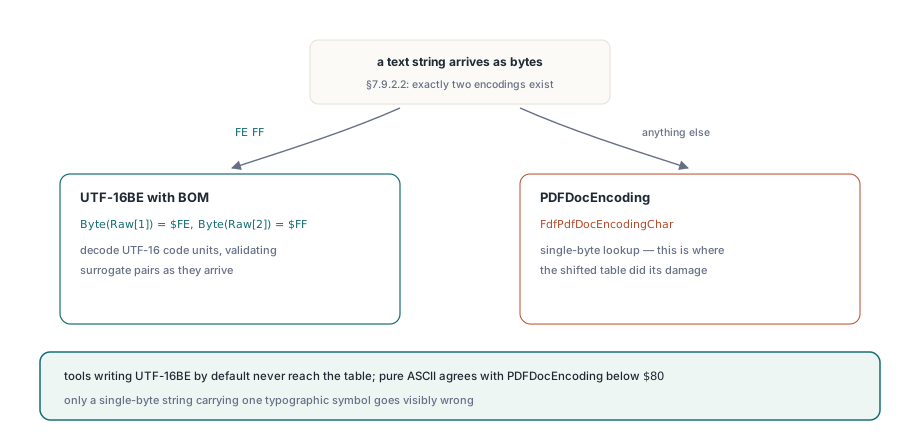
A ISO 32000-1 §7.9.2.2 define o tipo text string como uma de exatamente duas codificações, escolhida inspecionando os dois primeiros bytes em vez de qualquer entrada de dicionário. Uma string que abre com o byte order mark FE FF é UTF-16BE; qualquer outra coisa é PDFDocEncoding. Esse único branch decide qual de dois decoders completamente diferentes roda, e o PDFium Component o aplica dentro do parser de FDF antes de tocar um único caractere
// String de texto FDF: UTF-16 quando o BOM está presente, PDFDocEncoding caso contrário
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... decodificar unidades de código UTF-16, validando pares substitutos
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
É por isso que o bug se escondeu tanto tempo em testes comuns. Qualquer FDF produzido por uma ferramenta que escreve UTF-16BE por padrão nunca chega ao FdfPdfDocEncodingChar de jeito nenhum, então a tabela deslocada fica dormente. Só strings single-byte — que é o que muitos geradores de FDF emitem para nomes de campo latinos puros, porque são mais curtas — descem pelo branch onde a tabela importa. Nomes de campo ASCII puros então decodificam certo mesmo assim, já que abaixo de $80 a PDFDocEncoding e o ASCII concordam. Você precisa de uma string single-byte contendo um símbolo tipográfico antes de qualquer coisa sair visivelmente errada
A tabela corrigida, e as duas âncoras que a fixam
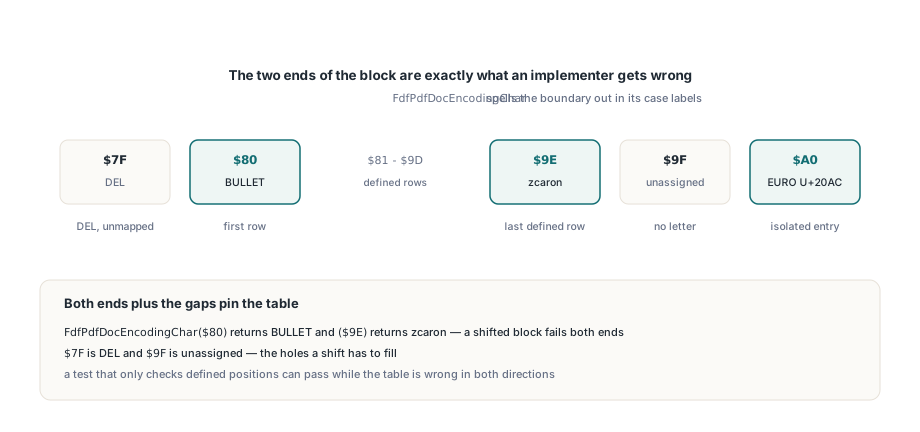
O PDFium Component agora explicita a fronteira no próprio FdfPdfDocEncodingChar, porque as duas pontas do bloco são exatamente o que um implementador erra. $7F é DEL e não tem significado nenhum na PDFDocEncoding; o bloco abre em $80 com BULLET e vai até $9E com zcaron; $9F não é atribuído; e o sinal de Euro fica sozinho em $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Anexo D.2. O bloco vai de $80, não de $7F: $7F é DEL e
    // não tem significado em PDFDocEncoding, e o Euro fica em $A0, que o
    // o ramo padrão devolveria como espaço sem quebra
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, primeira linha do bloco
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 through $9D
    $9E: Result := WideChar($017E);   // zcaron, última linha definida
    $9F: Result := WideChar($FFFD);   // não atribuído no Anexo D.2
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Olhe o que o deslocamento fez com essas duas pontas, porque é aí que um off-by-one deixa de ser cosmético. O zcaron ficava em $9E na especificação, mas em $9D na tabela deslocada, então um byte de documento $9E caía depois da última linha que alguém tinha transcrito e despencava direto no fallback de identidade, devolvendo um caractere de controle C1 em vez de uma letra. E o $A0, o Euro, nunca tinha sido escrito na tabela em primeiro lugar — o branch de identidade devolvia U+00A0 NO-BREAK SPACE, um caractere que sobrevive a toda validação seguinte, imprime como nada, e nunca bate com o nome de campo que você procura
Como você testa uma tabela de codificação transcrita?
Teste a primeira linha, a última linha e as lacunas — não uma amostra do meio. Essa é a parte do fix que vale levar para qualquer outra tabela que você copie de uma especificação, porque um spot check no meio do bloco é precisamente o teste que um deslocamento de bloco inteiro sobrevive. Verificar que $8D dá uma aspa dupla esquerda não prova nada quando $8C também dá algo plausível; verificar que $80 dá BULLET e $9E dá zcaron fixa as duas pontas, e um bloco deslocado não satisfaz as duas ao mesmo tempo
procedure CheckPdfDocEncodingAnchors;
begin
  // Ambas as extremidades do bloco especial do Anexo D.2: deslocar o bloco inteiro quebra estas
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Posições de código que a especificação deixa indefinidas não devem decodificar como letra
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // A entrada isolada acima do bloco, fácil de omitir por completo
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
As posições indefinidas merecem asserts próprios em vez de serem puladas como desinteressantes. Um off-by-one tem que pôr algo em algum lugar, e onde ele põe é quase sempre uma posição de código que a especificação deixou vazia — $7F na frente, $9F atrás. Um teste que só verifica posições definidas pode passar com a tabela errada nas duas direções; um teste que fixa os buracos pega o deslocamento na primeira execução
O que isso custa num fluxo de formulário com round-trip
Um import FDF que reescreve silenciosamente um caractere por símbolo é pior do que um que falha, porque a falha aparece a jusante e parece outra coisa. Nomes de campo são a aresta afiada aqui. O TPdf.ImportFDF compara nomes de entrada contra os widgets do documento aberto, e um nome que decodificou um caractere errado simplesmente não bate — o campo fica vazio, o valor de retorno ainda conta o campo como parseado, e o relatório que sai do pipeline fica faltando um valor sem nada no log explicando por quê. Quem constrói um loop de export-and-reimport do tipo descrito em exportando e importando dados de formulário XFDF e anotações com PDFium Component deveria fazer round-trip de um nome de campo contendo um símbolo tipográfico, não só ASCII puro, antes de confiar no loop
Também vale ser honesto sobre os limites do fix. A tabela agora bate com o Anexo D.2 para todos os 256 valores de byte, o que faz strings single-byte de FDF decodificarem certo, mas a própria PDFDocEncoding cobre um repertório latino e nada mais — qualquer coisa fora dele tem que chegar como UTF-16BE com BOM, que é exatamente o que a §7.9.2.2 pretende. E uma string UTF-16 ainda tem os próprios perigos separados no lado Delphi, já que um code point além de U+FFFF precisa de um par de surrogates em vez de um WideChar, o problema coberto em por que emoji e caracteres CJK quebram o WideChar em Delphi. O ponto maior generaliza para além de tabelas de codificação: um parser de PDF pode rejeitar algo que deveria aceitar, o que você descobre na hora, ou aceitar algo e silenciosamente errar, o que você descobre em produção. As armadilhas de name token descritas em parseando dicionários de PDF com segurança ficam na segunda categoria, e uma tabela deslocada em uma linha também — o caminho de código tem sucesso, o valor de retorno parece razoável, e só um teste escrito contra a especificação em vez de contra a implementação diz o contrário
O ImportFDF, o ExportFDF e o ImportXFDF do TPdf, junto com os parsers de FDF e XFDF por trás deles, fazem parte do PDFium Component padrão para Delphi e C++Builder