Um arquivo de faturas pode renderizar limpo, imprimir, incorporar todas as fontes e carregar um output intent válido, e um validador PDF/A ainda vai rejeitá-lo porque um dicionário de recursos tem 4.096 entradas. O teto é 4.095. O PDF/A herda uma pequena tabela de limites de implementação da PDF Reference, e um arquivo uma unidade acima de qualquer deles falha na conformidade mesmo sem que nenhum visualizador reclame
A outra falha que cai no mesmo balde de "mas está parecendo tudo bem" é uma fonte TrueType simbólica que carrega uma entrada /Encoding. Checkboxes, códigos de barras e dingbats saem certos na tela, e o validador mesmo assim marca o dicionário da fonte. Os dois problemas vivem no grafo de objetos, não em algo que uma pessoa veja na página, então valem checagem mecânica antes de o arquivo entrar em um acervo
Os números que o PDF/A herda, e onde a fronteira fica
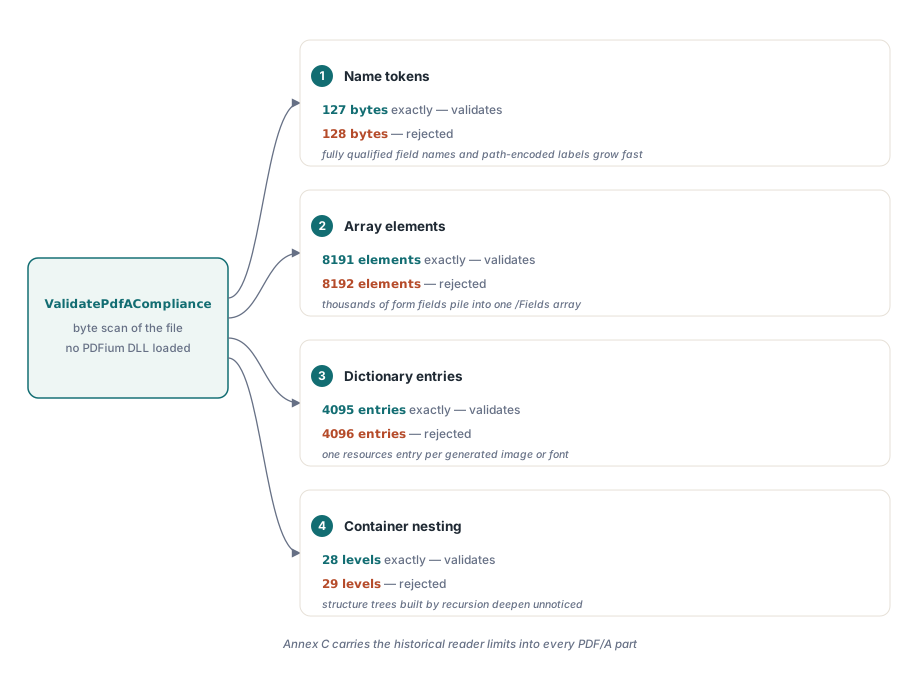
O PDFium Component confere quatro limites de contêiner em toda validação PDF/A: um token de nome pode ter no máximo 127 bytes, um array pode conter no máximo 8.191 elementos, um dicionário pode conter no máximo 4.095 entradas, e arrays e dicionários podem se aninhar no máximo 28 níveis. As quatro fronteiras são inclusivas. Um nome de 127 bytes passa e um de 128 falha; um array de exatamente 8.191 elementos passa e um elemento a mais o derruba
Os limites de nome, array e dicionário vêm da época em que um leitor em conformidade só precisava lidar com estruturas até aqueles tamanhos. Um visualizador de mesa atual pode abrir um array muito maior sem reclamar, mas um arquivo de arquivamento deve abrir em leitores que ninguém testou ainda, incluindo antigos que um sistema de registros ainda pode estar rodando. É por isso que o PDF/A mantém os tetos históricos em vez de relaxá-los
Inclusivo versus exclusivo é onde checagens artesanais costumam errar. Um teste escrito como Count >= 8191 em vez de Count > 8191 rejeita arquivos que estão em conformidade, e um validador que rejeita arquivos em conformidade tende a ser acreditado de qualquer forma, então o gerador é "consertado" por um problema que nunca teve. A função ValidatePdfACompliance na unit FPdfPdfa conta estritamente acima do limite, e lê os bytes do arquivo direto, então a checagem roda sem carregar a DLL do PDFium
uses
  System.Classes, FPdfPdfa;

procedure CheckContainerLimits(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Res: TPdfAValidationResult;
begin
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfACompliance(Src);   // varredura de bytes, sem precisar da DLL do PDFium
    if pvaiNameOverLimit in Res.Issues then
      Log.Add('A name token is longer than 127 bytes');
    if pvaiArrayOverLimit in Res.Issues then
      Log.Add('An array holds more than 8191 elements');
    if pvaiDictOverLimit in Res.Issues then
      Log.Add('A dictionary holds more than 4095 entries');
    if pvaiNestingOverLimit in Res.Issues then
      Log.Add('Arrays and dictionaries nest deeper than 28 levels');
    if Res.IsCompliant then
      Log.Add('No PDF/A findings');
  finally
    Src.Free;
  end;
end;
As quatro flags são membros do conjunto Issues no TPdfAValidationResult, ao lado de todo outro achado de PDF/A, e o IsCompliant retorna True apenas quando uma identificação PDF/A foi encontrada e o conjunto está vazio. Um arquivo que não carrega identificação PDF/A nenhuma é conferido contra o conjunto estrito de regras PDF/A-1, então os limites de contêiner ainda se aplicam a ele
Quais geradores esbarram nesses limites?
Quase sempre os que constroem estrutura em um loop. Um formulário com vários milhares de campos produz um array /Fields do AcroForm, ou um array /Annots de página, que ultrapassa 8.191 entradas. Um engine de relatórios que registra um recurso de fonte ou imagem por objeto gerado, e nunca reutiliza uma entrada existente, cresce um sub-dicionário /Resources além de 4.095 chaves. Um documento marcado cuja árvore de estrutura é produzida recursando sobre um modelo de dados aninhado pode passar de 28 níveis sem ninguém olhar
Nomes longos têm uma origem diferente: dados empacotados dentro de tokens de nome. Um colorante separation nomeado por uma referência de cliente, um grupo de conteúdo opcional nomeado por um caminho de arquivo, um rótulo de campo montado de seis níveis de hierarquia. Nomes não custam nada para gerar, e 127 bytes acabam rápido quando entra um rótulo UTF-8 com caracteres acentuados, porque cada um desses caracteres leva dois ou três bytes. Os 127 bytes são contados depois do introdutor /, até o próximo delimitador ou espaço em branco
O remédio é estrutural toda vez. Parta o array, parta o dicionário, achate a recursão, encurte o nome. Injetar marcadores PDF/A no arquivo não ajuda em nenhum desses achados, já que o problema é a forma do grafo de objetos e o metadado XMP não diz nada sobre isso
Como a varredura conta elementos e entradas
A regra de contagem importa quando você tenta reproduzir um achado em um editor hex. Um array ou dicionário aninhado conta como um elemento do seu pai, que é como o limite é enunciado: um array de 10 elementos de arrays de 1.000 elementos está bem, porque nenhum array único excede 8.191. Dentro de um dicionário apenas as chaves são contadas, então um valor que por acaso seja um nome não infla o total de entradas. Hex strings como <FEFF0041> são puladas como tokens únicos, então os seus colchetes angulares nunca são confundidos com aninhamento de dicionário
A varredura cobre a estrutura de objetos do arquivo inteiro, incluindo objetos guardados dentro de compressed object streams, que são expandidos antes da contagem. Os corpos dos streams em si, como conteúdo de página e dados de imagem, são apagados primeiro, então uma sequência de bytes binários que por acaso contenha um / ou um [ não pode disparar um achado falso de nome ou array
Há um limite numérico adjacente que a mesma validação reporta sob a sua própria flag. Quando o arquivo declara PDF/A-2 ou uma parte posterior, o pvaiIntegerImplementationLimit é levantado para qualquer token inteiro fora da faixa de 32 bits com sinal, ou seja, fora de -2.147.483.648 a 2.147.483.647. Geradores que escrevem offsets de bytes ou contadores grandes como inteiros puros são a fonte usual
Por que uma fonte TrueType simbólica precisa largar a /Encoding?
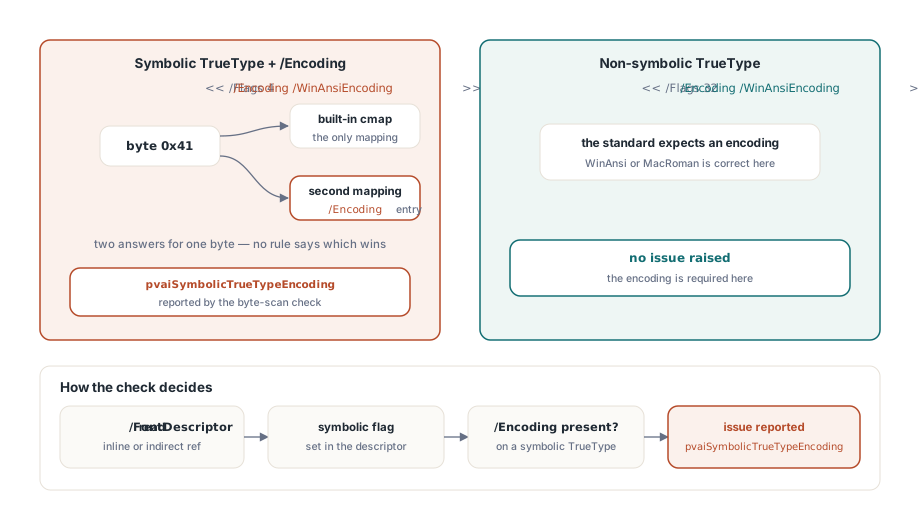
A ISO 19005-1 §6.3.7 admite apenas o cmap embutido do programa de fonte como mapeamento de caracteres para uma fonte TrueType simbólica. Uma fonte simbólica mapeia códigos para glifos nos termos dela; é isso que a flag Symbolic declara. Adicione uma entrada /Encoding e o arquivo agora dá duas respostas à pergunta "qual glifo o byte 0x41 seleciona", sem nada no arquivo dizendo qual vence. Os leitores resolvem o conflito de forma diferente, e o mesmo checkbox pode sair como um visto em um visualizador e como a letra A em outro
O ValidatePdfACompliance encontra todo dicionário de fonte com /Subtype /TrueType, confere se ele tem uma chave /Encoding e então lê o bit 3 (valor 4) da entrada /Flags no descritor da fonte. O descritor é seguido tanto se escrito inline quanto referenciado como objeto indireto. Uma fonte TrueType não simbólica que mantém /WinAnsiEncoding ou /MacRomanEncoding não é marcada por essa checagem, porque para fontes não simbólicas o PDF/A espera exatamente essa codificação
// Res vem de ValidatePdfACompliance como no primeiro exemplo
if pvaiSymbolicTrueTypeEncoding in Res.Issues then
  Log.Add('A symbolic TrueType font carries /Encoding; PDF/A admits only ' +
    'the font''s built-in cmap (ISO 19005-1 6.3.7)');

// Uma regra vizinha de fonte com gatilho diferente: uma fonte TrueType
// NÃO simbólica cujo dicionário Encoding carrega /Differences
if pvaiTrueTypeDifferencesForbidden in Res.Issues then
  Log.Add('A non-symbolic TrueType Encoding dictionary carries /Differences');
As fontes que tropeçam nessa regra são previsíveis: Symbol, Wingdings, fontes de código de barras, fontes de ícones. Elas aparecem em documentos de negócio como checkboxes, estrelas de avaliação e códigos de barras, e um passo de subsetting que trata toda fonte TrueType da mesma forma escreve uma codificação para elas também. São também as fontes que ninguém olha quando um validador diz "problema de fonte", porque as fontes do corpo de texto são conferidas primeiro
O erro oposto também aparece na natureza: um produtor define a flag Symbolic em uma fonte de texto comum que na verdade é WinAnsi. A checagem PDF/A segue a cláusula como escrita e reporta essa fonte, e aqui o reparo pertence ao descritor: corrija a flag no descritor em vez de apagar a codificação. Remover a /Encoding de uma fonte de texto mal rotulada deixaria o texto dependente do cmap que o subset por acaso contém, o que é um arquivo pior do que o de início. Olhe o conjunto de glifos da fonte antes de escolher qual metade da contradição remover
Lendo os achados em um relatório de preflight
A unit de relatório de preflight vem com a edição Enterprise, enquanto o ValidatePdfACompliance está em todas as edições. O relatório na unit FPdfPreflightReport classifica os quatro limites de contêiner na categoria Structure e o problema de codificação TrueType simbólica na categoria Content. Essa divisão é deliberada. Achados de Structure normalmente voltam para quem mantém o gerador, enquanto achados de Content normalmente vão para quem forneceu as fontes e os modelos, e um relatório que mistura os dois manda as duas pessoas atrás de problemas que não são delas
Cada problema carrega o nome do seu enum como Code e uma recomendação que nomeia o remédio em termos concretos, por exemplo "Parta os dicionários para que nenhum carregue mais de 4095 entradas". Note que a categoria Structure também guarda dois outros achados, estrutura marcada ausente em uma reivindicação Level A e cross-reference ou object streams do PDF 1.5 em um arquivo PDF/A-1, então filtre por código quando só quiser os quatro limites
uses
  System.SysUtils, System.Classes, PDFium, FPdfPreflightReport;

procedure ReportStructureFindings(const FileName: string; Log: TStrings);
var
  Pdf: TPdf;
  Report: TPdfPreflightReport;
  Issues: TPdfPreflightIssues;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;          // este caminho carrega a DLL do PDFium
    if not Pdf.Active then
      Exit;
    Report := BuildPdfPreflightReport(Pdf, [ppsPdfA]);
    Issues := Report.FilterByCategory('Structure').FlattenIssues;
    for I := 0 to High(Issues) do
      Log.Add(Issues[I].Code + ': ' + Issues[I].Recommendation);
    Report.SaveJsonToFile(ChangeFileExt(FileName, '.preflight.json'));
  finally
    Pdf.Free;
  end;
end;
Os dois caminhos respondem a perguntas ligeiramente diferentes. O BuildPdfPreflightReport passa pelo TPdf.ValidatePdfA, que salva o documento aberto em uma cópia temporária, roda a mesma varredura de bytes nessa cópia e então adiciona checagens que precisam do engine PDFium, como fontes usadas em uma página mas não incorporadas. O ValidatePdfACompliance julga os bytes exatos no disco. Para limites de implementação, o caminho de bytes sobre o arquivo original é o que vale confiança: ele reporta sobre o arquivo que você está prestes a arquivar, e roda em um passo de build ou um serviço restrito onde uma DLL nativa não pode ser implantada. Use o caminho do relatório quando você também quiser as checagens no nível do engine e a saída JSON, SARIF ou JUnit para um pipeline
Por onde seguir daqui
Rodar essas checagens por uma pasta, decidir quais achados bloqueiam uma release e transformar o resultado em um relatório que as pessoas vão ler está coberto no passo a passo de validação preflight de PDF/A no Delphi e no CLI de relatório preflight em lote. Qual parte do PDF/A e nível de conformidade mirar desde o começo é o assunto das notas sobre conformidade de arquivamento PDF/A; essa escolha decide, entre outras coisas, se o limite de inteiro se aplica
Os validadores mostrados aqui acompanham o PDFium Component para Delphi, C++Builder e Lazarus, ao lado de renderização, preenchimento de formulários e edição sobre o engine PDFium. A página do produto PDFium Component lista os padrões de conformidade, edições e versões de compilador suportados