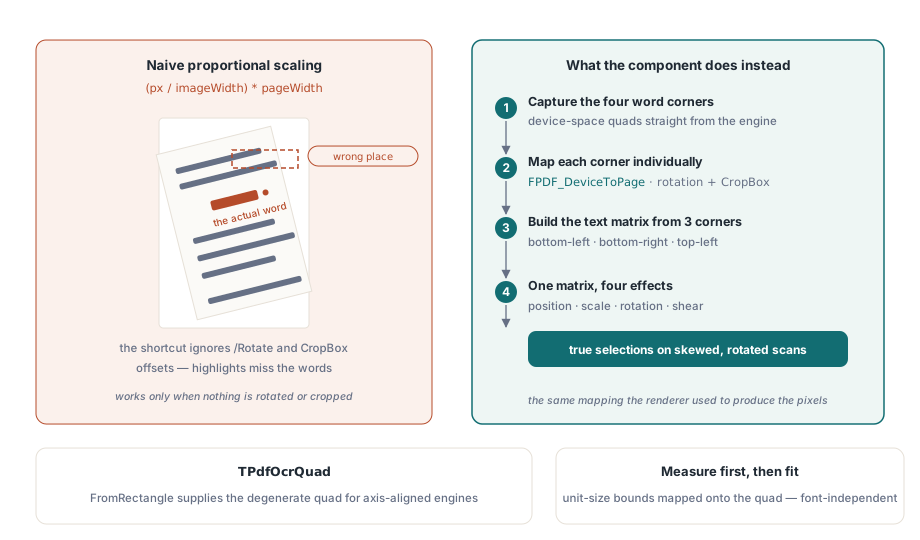
Uma busca por um número de fatura em um PDF digitalizado encontra o resultado, mas o destaque fica meia polegada à esquerda dos dígitos impressos e meia polegada abaixo deles. Meia polegada são 36 pontos, e a página em questão tem uma CropBox de [36 36 576 756]. Quem construiu aquela camada de texto converteu posições de pixel em posições de página dividindo pela largura do bitmap e multiplicando pela largura da página, o que assume que a área visível começa na origem. Em uma página com /Rotate 90 a mesma fórmula fica pior: o eixo x do bitmap agora corre ao longo do eixo y da página, e as palavras caem totalmente na parte errada da página
O que uma camada de texto invisível realmente é
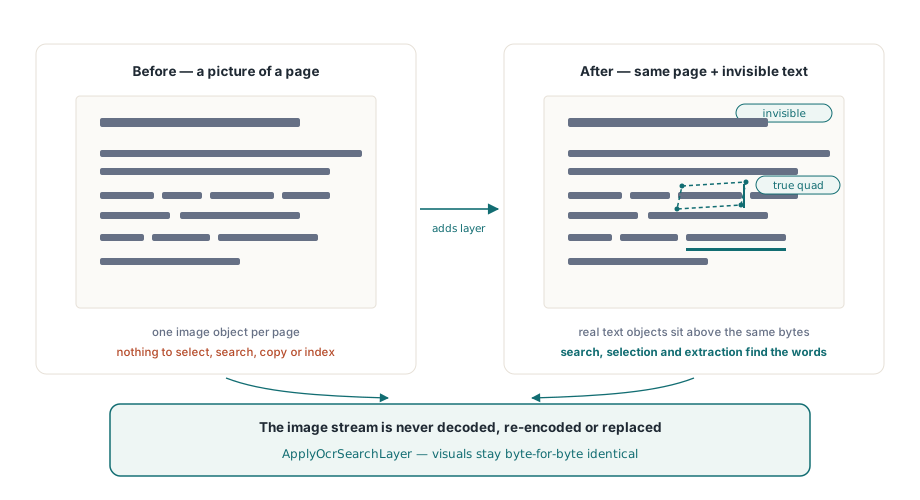
Uma página digitalizada é uma única imagem grande pintada pelo content stream. Não há nada para selecionar, buscar, copiar ou indexar. Uma camada de texto pesquisável adiciona objetos de texto comuns sobre essa imagem e define o modo de renderização de texto deles como 3, que a ISO 32000-1 §9.3.6 (Tabela 106) define como nem preenchimento nem traço: os glifos existem para seleção, busca e extração, e um visualizador não pinta nada para eles. Bem feita, a camada deixa o leitor vendo a digitalização original e o Ctrl+F encontra as palavras exatamente onde elas estão impressas
No PDFium Component o trabalho todo é uma chamada, TPdf.ApplyOcrSearchLayer. Ela renderiza cada página selecionada, entrega os pixels a um provedor de OCR, filtra as palavras reconhecidas por confiança e grava as sobreviventes de volta como objetos de texto invisíveis. A imagem da página fica como está: a digitalização não é decodificada, recodificada nem substituída, então uma imagem JBIG2 ou CCITT G4 mantém exatamente os bytes comprimidos com que chegou. O método vem nas edições Small Business e Enterprise, então o projeto precisa de Lib\SmallBusiness no search path e FPdfSmallBusiness em uma cláusula uses; sem essa unit a chamada dispara EPdfSmallBusinessRequired
Escrevendo um IPdfOcrProvider
O reconhecimento em si fica atrás de uma interface. IPdfOcrProvider.RecognizePage recebe um TPdfOcrImage (número da página, largura, altura, stride, DPI, formato de pixel e um buffer TBytes com linhas BGRA de cima para baixo), mais um token de cancelamento, e retorna um array de registros TPdfOcrWord: texto Unicode, uma confiança entre 0 e 1 e um quadrilátero de quatro cantos em pixels da imagem. A edição traz um provedor pronto, o CreatePdfTesseractOcrProvider em FPdfOcrTesseract, que se liga a uma biblioteca Tesseract e a um diretório traineddata que você fornece. Qualquer outro mecanismo, uma API de nuvem ou um SDK comercial se encaixa por meio de uma classe como esta:
uses
  System.SysUtils, PDFium, FPdfAsync, FPdfSmallBusiness;

type
  TMyOcrProvider = class(TInterfacedObject, IPdfOcrProvider)
  public
    function RecognizePage(const Image: TPdfOcrImage;
      const CancellationToken: IPdfCancellationToken;
      out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
  end;

function TMyOcrProvider.RecognizePage(const Image: TPdfOcrImage;
  const CancellationToken: IPdfCancellationToken;
  out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
var
  I, Count: Integer;
begin
  // As rotinas Engine* abaixo representam a sua própria ligação ao mecanismo de OCR
  Count := EngineRecognize(Image.Pixels, Image.Width, Image.Height,
    Image.Stride, Image.Dpi);
  CancellationToken.ThrowIfCancelled;   // reporte um cancelamento como cancelamento

  SetLength(Words, Count);
  for I := 0 to Count - 1 do
  begin
    Words[I].Text := EngineWordText(I);
    // Muitos mecanismos relatam 0..100; a camada espera 0..1
    Words[I].Confidence := EngineWordConfidence(I) / 100;
    Words[I].Quad := TPdfOcrQuad.FromRectangle(
      EngineLeft(I), EngineTop(I), EngineRight(I), EngineBottom(I));
  end;
  ErrorMessage := '';
  Result := True;
end;
Um provedor que entrega o 87.5 do Tesseract direto tem toda palavra rejeitada. O Tesseract, por exemplo, relata a confiança da palavra como porcentagem, e o adaptador que acompanha a biblioteca a divide antes de retornar; um provedor customizado precisa fazer o mesmo, porque ApplyOcrSearchLayer trata confiança acima de 1 como entrada inválida. O sintoma é inconfundível quando você sabe onde olhar: Report.RejectedWordCount igual a Report.DetectedWordCount e o arquivo salvo sem texto algum
A chamada ao token importa por outro motivo. Se o provedor percebe o cancelamento e simplesmente retorna False, a página é registrada como popsFailed com a mensagem que você definiu. Chamar ThrowIfCancelled dispara EPdfOperationCancelled em vez disso, e a camada captura a exceção e registra como popsCancelled, com Report.Cancelled definido e o loop interrompido. O token nunca é nil dentro de um provedor; quando o chamador não passa nenhum, um token que nunca cancela é fornecido
Quads e as palavras que a camada recusa
Digitalizações raramente ficam alinhadas com a página, então uma palavra em uma folha levemente inclinada ocupa um paralelogramo. O TPdfOcrQuad carrega os pontos TopLeft, TopRight, BottomRight e BottomLeft exatamente para esse caso, e o FromRectangle constrói a versão alinhada aos eixos para mecanismos que só relatam caixas. Uma palavra é descartada e contada em RejectedWordCount quando seu texto está vazio ou é mais longo que MaxWordCharacters, quando sua confiança é NaN, está abaixo de MinConfidence ou acima de 1, quando qualquer canto cai fora do bitmap, ou quando o quad colapsa em uma lasca mais estreita que 0.01 pt depois do mapeamento
Por que o escalonamento proporcional desloca as palavras de OCR
O escalonamento proporcional só está correto quando a página não tem entrada /Rotate e a CropBox dela começa em (0, 0). Muitas digitalizações falham em uma dessas condições: uma folha em paisagem costuma ser armazenada como página em retrato com /Rotate definido, e caixas de corte ganham offset quando alguém apara as margens em um editor. O exemplo de abertura é a falha leve; com rotação, o erro deixa de ser um deslocamento e vira um eixo trocado
O ApplyOcrSearchLayer envia cada um dos quatro cantos por FPDF_DeviceToPage, usando o mesmo tamanho de bitmap e a mesma rotação que produziram os pixels que o provedor viu. Rotação e offsets de CropBox são tratados, portanto, pela mesma transformação que o renderizador usou. Os cantos são arredondados para pixels inteiros na entrada, o que a 300 DPI padrão dá um passo de quantização de 0.24 pt, bem abaixo de qualquer coisa que um destaque de seleção consiga mostrar
A partir dos pontos mapeados, os cantos inferior esquerdo, inferior direito e superior esquerdo definem uma matriz afim. Três pontos bastam para expressar posição, escala, rotação e cisalhamento, e é por isso que o quarto canto é apenas validado, nunca usado no ajuste. O objeto de texto é criado com tamanho de fonte 1, seus limites reais são medidos, e a matriz mapeia esses limites medidos sobre o quad alvo. Chutar um tamanho de ponto a partir da altura do quad oscilaria com o ascent e o descent de cada fonte; medir primeiro torna o ajuste independente da fonte que Options.FontName indicar
A fonte ainda importa para a extração, mesmo que nada seja desenhado. TPdfOcrOptions.Default a define como Arial. Se essa fonte não puder ser carregada, a camada volta para a Helvetica padrão, uma das 14 fontes padrão, cuja codificação embutida cobre apenas texto latino. Para saída em cirílico, grego ou CJK, defina FontName como uma fonte instalada que cubra o sistema de escrita
Executando a camada e lendo o relatório
O ApplyOcrSearchLayer retorna True apenas quando nenhuma página falha e nada é cancelado. Esse valor de retorno é a coisa errada para decidir o salvamento. Com ContinueOnError no padrão True, um job de 300 páginas com uma página ilegível retorna False enquanto 299 páginas carregam uma camada correta, e a página que falhou já foi devolvida ao estado anterior. Decida o salvamento pelo relatório:
var
  Pdf: TPdf;
  Options: TPdfOcrOptions;
  Report: TPdfOcrReport;
  Cancel: IPdfCancellationTokenSource;
  I: Integer;
begin
  Cancel := TPdfCancellationTokenSource.New;  // deixe-o onde um botão Cancelar possa alcançá-lo
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'scanned-contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfOcrOptions.Default;      // 300 DPI, MinConfidence 0.5, Arial
    Options.MinConfidence := 0.6;
    Options.MaxTotalPixels := Int64(4000) * 1000 * 1000;

    Pdf.ApplyOcrSearchLayer(TMyOcrProvider.Create, Options, Report,
      Cancel.Token);

    for I := 0 to High(Report.Pages) do
      if Report.Pages[I].Status = popsFailed then
        Writeln(Format('page %d failed: %s',
          [Report.Pages[I].PageNumber, Report.Pages[I].ErrorMessage]));
    Writeln(Format('%d inserted, %d rejected, %d skipped, %d failed',
      [Report.InsertedWordCount, Report.RejectedWordCount,
       Report.SkippedPageCount, Report.FailedPageCount]));

    if not Report.Cancelled and (Report.InsertedWordCount > 0) then
      Pdf.SaveAs('scanned-contract-searchable.pdf');
  finally
    Pdf.Free;
  end;
end;
Não salvar após um cancelamento é uma decisão de julgamento, e é a que foi tomada aqui. Um job cancelado deixa um arquivo pesquisável na primeira parte e em branco no restante, e nada no PDF diz ao próximo leitor onde a camada para. Rodar o documento inteiro de novo depois sai mais barato do que explicar um arquivo meio indexado
SkipPagesWithText tem padrão True e verifica se a página já produz algum caractere extraível. Isso mantém páginas nativamente digitais fora do OCR, evita uma segunda camada em arquivos processados antes e torna uma execução repetida sobre a mesma saída um no-op. O lado ruim é que um único caractere real já conta: uma digitalização com um número Bates carimbado como texto real é reportada como popsSkippedExistingText e não ganha camada. Arquivos construídos desse jeito precisam de SkipPagesWithText := False e de um intervalo de páginas cuidadoso via FirstPage e LastPage, senão páginas já processadas adquirem uma camada duplicada e a extração retorna cada palavra duas vezes
Orçamentos de pixels, cancelamento e rollback por página
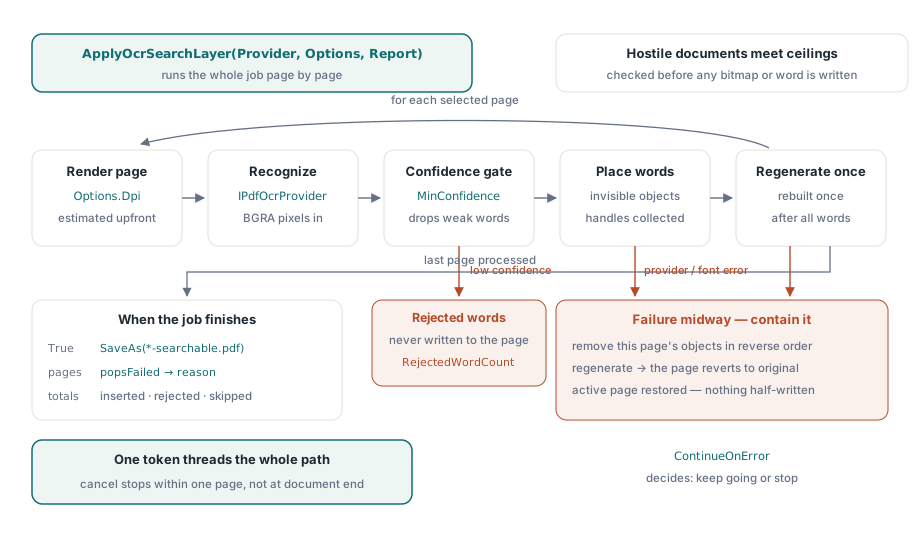
Toda quantidade que um documento hostil ou simplesmente enorme pode inflar tem um teto em TPdfOcrOptions, e as verificações de pixel rodam antes de qualquer bitmap ser alocado. O tamanho de renderização é Ceil(PageWidth * Dpi / 72) por Ceil(PageHeight * Dpi / 72), então os números podem ser calculados com antecedência:
| Página a 300 DPI | Bitmap | Pixels |
|---|---|---|
| US Letter, 612 × 792 pt | 2550 × 3300 | 8,415,000 |
| A4, 595 × 842 pt | 2480 × 3509 | 8,702,320 |
| A3, 842 × 1191 pt | 3509 × 4963 | 17,415,167 |
| A0, 2384 × 3370 pt | 9934 × 14042 | 139,493,228 |
Os padrões são 100 milhões de pixels por página e 1 bilhão no job inteiro. Um desenho A0 a 300 DPI portanto excede MaxPixelsPerPage sozinho. O orçamento do job inteiro se esgota antes do por página: a 8,415,000 pixels por página Letter, 118 páginas cabem abaixo de 1 bilhão e a página 119 falha com uma mensagem citando MaxTotalPixels, e o mesmo vale para todas as páginas seguintes. Para arquivos digitalizados longos, aumente MaxTotalPixels como no exemplo acima, ou divida o trabalho em intervalos com FirstPage e LastPage. Páginas ignoradas nunca são renderizadas e não contam. O adaptador Tesseract que acompanha a biblioteca adiciona o próprio limite, TPdfTesseractOptions.MaxPixels, cujo padrão é 16,777,216; uma folha A3 a 300 DPI passa disso por pouco, então lotes A3 precisam do limite do adaptador aumentado ou do DPI reduzido
O DPI deve ficar entre 36 e 1200. Dobrá-lo de 300 para 600 quadruplica o bitmap, e cada pixel custa 4 bytes, então uma página Letter vai de cerca de 34 MB de BGRA para cerca de 135 MB. Para digitalizações comuns de escritório, 300 DPI equilibra a qualidade de reconhecimento com a memória; 600 vale a pena para letras pequenas e notas de rodapé, não para arquivos inteiros. Contagens de palavras têm teto em MaxWordsPerPage e MaxTotalWords, e um provedor que retorna mais palavras do que a página permite faz a página falhar em vez de ser truncado
O token de cancelamento alcança a renderização progressiva, a chamada ao provedor e o loop que insere palavras. Cancelar durante o reconhecimento da página 212 de um arquivo de 400 páginas para na página 212, desde que o provedor honre o token que recebeu. O adaptador Tesseract vai além e registra um callback de cancelamento no mecanismo, ao lado de um timeout por página de 60,000 ms por padrão
A contenção é por página. A camada guarda o handle de cada objeto de texto que insere e chama FPDFPage_GenerateContent uma vez, depois que a última palavra da página é posicionada. Se algo falhar no meio do caminho, uma fonte que recusa um caractere ou um cancelamento chegando durante o loop, os objetos já inseridos na página são removidos em ordem inversa e o conteúdo da página é regenerado, de modo que a página volta a carregar apenas o que tinha antes. O loop então continua ou para conforme ContinueOnError, e a página que estava ativa antes da chamada volta a estar ativa depois
Verificando o resultado
Duas verificações cobrem a maior parte do que pode dar errado. A primeira é visual: renderize uma página do arquivo original e a mesma página do arquivo processado no mesmo tamanho com TPdf.RenderPage, e compare os bitmaps. O esperado é que sejam idênticos, porque o modo 3 não pinta nada e o stream de imagem não foi tocado; qualquer diferença de pixel significa que algo além da camada de texto mudou a página. A segunda confirma que as palavras existem e ficam onde a digitalização mostra:
procedure CheckOcrPage(Pdf: TPdf; PageNo: Integer; const Probe: WString);
const
  TEXT_MODE_INVISIBLE = 3;   // FPDF_TEXTRENDERMODE_INVISIBLE
var
  TextObjects: TPdfIntegerArray;
  I, Invisible, Hit: Integer;
  Box: TPdfRectangle;
begin
  Pdf.PageNumber := PageNo;
  TextObjects := Pdf.GetObjectsByType(otText);
  Invisible := 0;
  for I := 0 to High(TextObjects) do
    if Pdf.GetTextRenderMode(TextObjects[I]) = TEXT_MODE_INVISIBLE then
      Inc(Invisible);
  Writeln(Format('page %d: %d invisible text objects', [PageNo, Invisible]));

  Hit := Pdf.FindFirst(Probe);
  if Hit >= 0 then
  begin
    Box := Pdf.CharacterRectangle[Hit];
    Writeln(Format('"%s" starts at x=%.1f, y=%.1f pt',
      [Probe, Box.Left, Box.Bottom]));
  end;
end;
Escolha uma palavra de teste que você consiga localizar a olho na digitalização, um título ou um total, e compare as coordenadas reportadas com a posição dela em uma imagem renderizada. Na página com CropBox do exemplo de abertura, o valor de x deve começar em 36 ou mais, nunca perto de zero. O lado da extração é coberto em mais profundidade em extração de texto de documentos PDF, a renderização de páginas para uma sobreposição de alinhamento em conversão de páginas PDF para JPEG, e o padrão de token usado em todo o componente em renderização progressiva cancelável
A camada de OCR fica ao lado da renderização, da extração de texto e da edição de páginas no mesmo objeto TPdf, no Delphi, no C++Builder e no Lazarus. Edições e a lista completa da API estão na página do produto PDFium Component para Delphi