O PDFium Delphi Component monta o pacote XMP da saída PDF/A concatenando fragmentos UTF-8 em uma AnsiString, e no Free Pascal 3.2.2 esse pacote silenciosamente deixou de ser UTF-8 válido no instante em que o título de um documento carregou um caractere não ASCII. A ISO 19005-1 6.7.2 exige que o stream de metadados seja UTF-8 válido, portanto o arquivo falhava na validação. A versão 3.103.1 corrige o próprio encoder, em StringToUtf8. A parte interessante não é o patch. É que uma única linha de origem inalterada produzia bytes corretos no Delphi, bytes corretos em uma aplicação Lazarus LCL e bytes corrompidos em um programa de console Free Pascal compilado a partir da mesma unit. Três comportamentos separados de strings do Free Pascal precisam se alinhar antes que isso faça sentido, e cada um deles é defensável isoladamente
Por que o mesmo código de metadados emite bytes diferentes no Delphi e no FPC?
Porque string não é o mesmo tipo nos dois compiladores. O FPC 3.2.2 em {$MODE Delphi} compila string como uma AnsiString marcada com DefaultSystemCodePage, enquanto o Delphi a compila como UnicodeString. Cada campo de metadados em TPdfASaveOptions é declarado como string, então Title, Author, Subject, Keywords, Creator e Producer carregam code units UTF-16 em um compilador e caracteres de um byte mais uma etiqueta de codepage no outro. Mesmo record, mesmo campo, payload diferente. Os próprios valores chegam do documento como UTF-16. TPdf.GetTitle e seus irmãos retornam WString, que é WideString no FPC e string no Delphi, e SaveAsPdfAToStream preenche qualquer campo de opção vazio a partir do dicionário Info antes de injetar os marcadores. Essa atribuição é uma conversão de narrowing no Free Pascal, e a RTL a executa pela codepage da string de destino. Em um programa LCL, LazUTF8 já definiu DefaultSystemCodePage como CP_UTF8, então o narrowing produz UTF-8 e tudo depois acaba correto. Em um programa de console simples, o mesmo narrowing chega à codepage ANSI, e StringToUtf8 então copia esses octetos sem alteração porque presume que já são UTF-8. Seis bridges de save compartilham esse formato: SaveAsPdfAToStream, SaveAsPdfUaToStream, SaveAsPdfEToStream, SaveAsPdfXToStream, SaveAsPdfRToStream e SaveAsPdfVTToStream, cada um com seu próprio option record
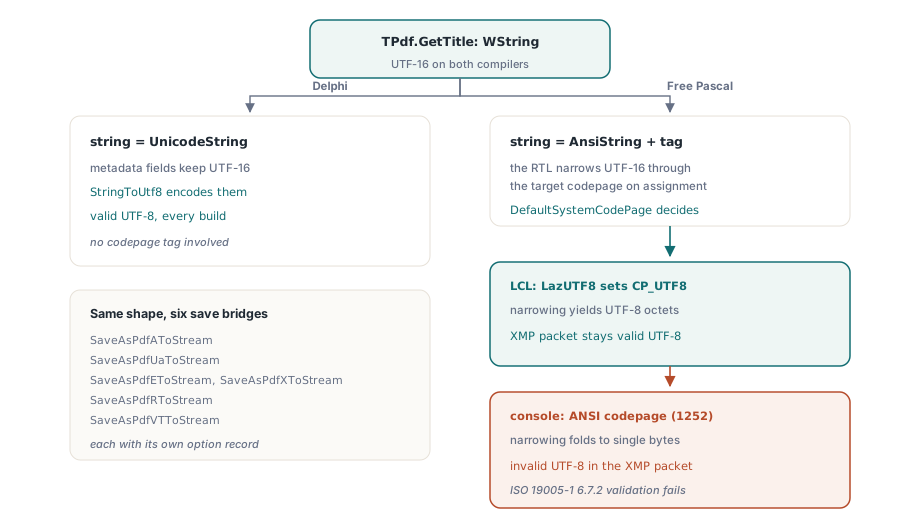
// PDFium.pas: os accessors do documento sao sempre UTF-16
//   WString = WideString no FPC, = string (UnicodeString) no Delphi
function TPdf.GetTitle: WString;

// FPdfPdfa.pas: o record de opcoes de save carrega metadados como `string`
TPdfASaveOptions = record
  Conformance: TPdfAConformance;
  IccProfileData: TBytes;
  Title: string;      // UnicodeString no Delphi
                      // AnsiString + DefaultSystemCodePage no FPC
  Author: string;
  Subject: string;
  Keywords: string;
  Creator: string;
  Producer: string;
  CreationDate: string;
  ModDate: string;
  DocumentId: TBytes;
  InstanceId: TBytes;
  class function Default: TPdfASaveOptions; static;
end;

// SaveAsPdfAToStream preenche campos vazios a partir do dicionario Info
// O narrowing agora esta escrito em vez de ficar implicito:
if Eff.Title = '' then
  Eff.Title := WStringToStr(GetTitle);
Encaminhar as seis bridges por um único helper WStringToStr não muda o que a RTL faz, mas coloca a conversão onde um leitor pode vê-la e eliminou 92 warnings de conversão implícita que estavam mascarando exatamente essa classe de problema. É o espelho da corrupção do lado Delphi descrita em nossas notas sobre armadilhas de cross-compiler Delphi e FPC em builds PDFium, em que uma concatenação no Delphi destrói um high byte que o Free Pascal preserva
Três comportamentos do Free Pascal que derrotam a correção óbvia
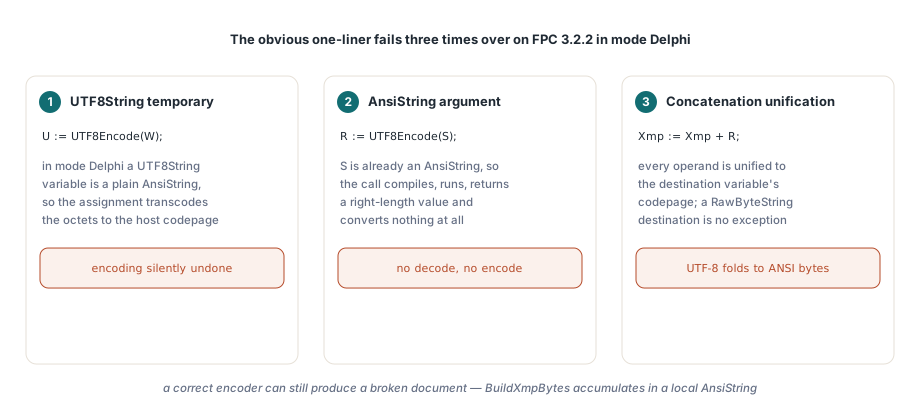
A correção óbvia é chamar UTF8Encode e terminar. Isso falha três vezes no FPC 3.2.2 em modo Delphi, e cada falha é silenciosa
var
  W: UnicodeString;
  S: string;
  U: UTF8String;
  R: RawByteString;
  Xmp: AnsiString;
begin
  // Armadilha 1: em modo Delphi uma *variavel* UTF8String e uma AnsiString simples,
  // entao a atribuicao transcodifica os octetos de volta para a codepage do host
  U := UTF8Encode(W);

  // Armadilha 2: S ja e uma AnsiString, entao UTF8Encode nao faz nada
  R := UTF8Encode(S);                 // sem decode, sem encode, sem erro
  R := UTF8Encode(UnicodeString(S));  // este realmente codifica

  // Armadilha 3: a concatenacao unifica todo operando para a codepage de destino,
  // e um destino RawByteString nao e excecao
  Xmp := Xmp + R;
end;
A armadilha um significa que o resultado codificado precisa continuar na AnsiString ou RawByteString em que foi produzido. Passe-o por um temporary UTF8String na saída e você terá desfeito o trabalho. A armadilha dois é a que se esconde por mais tempo, porque UTF8Encode(S) compila, executa, retorna um valor do tamanho correto e não faz conversão alguma quando seu argumento já é uma AnsiString; somente ampliar para UnicodeString antes faz a chamada decodificar algo. A armadilha três explica como um encoder correto ainda pode produzir um documento quebrado: BuildXmpBytes acumula o pacote em um Xmp: AnsiString local, e o Free Pascal converte todo operando de uma concatenação para a codepage da variável de destino, reduzindo as sequências multibyte novamente a bytes ANSI simples no caminho de entrada
O que SetCodePage com False realmente garante?
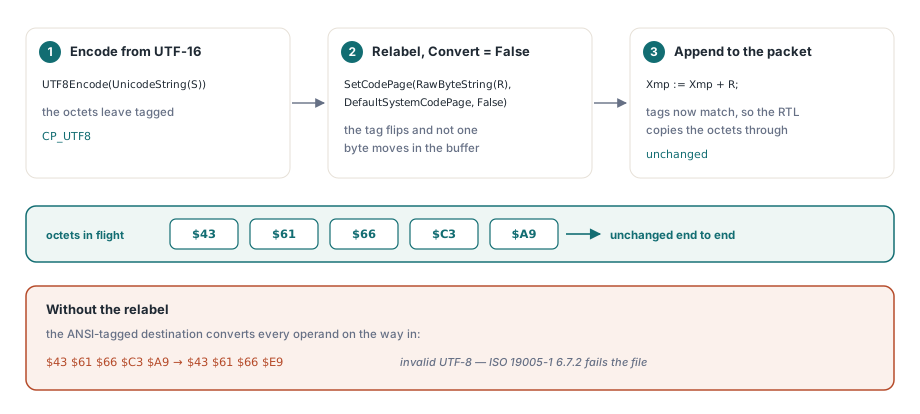
SetCodePage(RawByteString(Result), DefaultSystemCodePage, False) apenas rotula a string, sem tocar em nenhum byte. O terceiro parâmetro é Convert; passar False significa "presuma que o payload já está na codepage de destino e apenas altere a etiqueta". Isso é uma mentira sobre o conteúdo, contada deliberadamente: os octetos são realmente UTF-8, mas marcá-los como a codepage do host é o que impede que a concatenação da armadilha três os converta. Eles entram no buffer XMP como bytes brutos e saem do outro lado sem alteração
function StringToUtf8(const S: string): AnsiString;
begin
{$IFDEF UNICODE}
  // Delphi: UTF8Encode ja produz octetos marcados CP_UTF8, e a
  // concatenacao em uma AnsiString os preserva
  Result := AnsiString(UTF8Encode(S));
{$ELSE}
  // FPC: amplie primeiro, ou UTF8Encode nao-opera em um argumento AnsiString
  Result := UTF8Encode(UnicodeString(S));
  // Rotule sem transcodificar, para que os octetos sobrevivam a concatenacao
  // nos buffers marcados ANSI que montam pacotes XMP e objetos de string PDF
  if Length(Result) > 0 then
    SetCodePage(RawByteString(Result), DefaultSystemCodePage, False);
{$ENDIF}
end;
Seja claro sobre o limite. O retag é exclusivo do FPC e não é uma licença geral para misturar strings marcadas e não marcadas. Ele funciona aqui porque existe exatamente um padrão de consumo depois: anexar a uma AnsiString e escrever o buffer como bytes. Qualquer coisa que tentasse interpretar o valor retagged como texto na codepage do host leria mojibake, corretamente. A direção inversa é tratada do outro modo e é idêntica nos dois compiladores: marque o buffer recebido como CP_UTF8 com SetCodePage(..., False) e então chame UTF8ToString
Por que os testes de regressão carregavam a mesma armadilha?
Porque um teste que constrói seus bytes esperados a partir de um literal de origem está testando o compilador, não a biblioteca. Uma constante como #$C3#$A9 escrita em um arquivo-fonte Pascal carrega a codepage de compilação desse arquivo, e quando é passada a um parâmetro AnsiString a RTL a recodifica, que é justamente a conversão sob teste. A expectativa precisa ser montada em runtime, byte a byte, e comparada byte a byte, porque = em dois valores AnsiString com etiquetas diferentes reconcilia as codepages antes de comparar e retorna um alegre falso negativo
function BytesPattern(const Values: array of Byte): AnsiString;
var
  I: Integer;
begin
  SetLength(Result, Length(Values));
  for I := 0 to High(Values) do
    Result[I + 1] := AnsiChar(Values[I]);
end;

procedure TPdfATests.StringToUtf8_AnsiCodePageString_EncodesUtf8;
var
  Saved: Word;
  Wide: WideString;
  Narrowed: string;
  Encoded, ExpectedUtf8: AnsiString;
begin
  Saved := DefaultSystemCodePage;
  try
    SetMultiByteConversionCodePage(1252);
    Wide := WideChar($0043) + WideChar($0061) + WideChar($0066) + WideChar($00E9);
    Narrowed := Wide;                    // o narrowing sob teste
    Encoded := StringToUtf8(Narrowed);
  finally
    SetMultiByteConversionCodePage(Saved);
  end;
  // 'Caf' + U+00E9 como UTF-8, construido em runtime para nenhum literal ser recodificado
  ExpectedUtf8 := BytesPattern([$43, $61, $66, $C3, $A9]);
  AssertTrue('StringToUtf8 must emit UTF-8 for a string carrying a non-UTF-8 codepage',
    SameOctets(Encoded, ExpectedUtf8));
end;
O harness em si é um programa LCL, então DefaultSystemCodePage é CP_UTF8 e o bug fica invisível até o teste alterá-lo. SetMultiByteConversionCodePage(1252) dentro de um try..finally reproduz o ambiente de console simples durante um teste. A checagem end-to-end vai além e afirma as duas direções: o pacote XMP produzido pela injeção de marcadores precisa conter $43 $61 $66 $C3 $A9 e não conter $43 $61 $66 $E9, para que uma regressão futura que volte à saída bruta de um byte falhe de forma ruidosa, em vez de produzir um arquivo que apenas pareça plausível em um hex dump. Se você trabalha com metadados não latinos, a mesma disciplina de widening rege os casos em texto emoji e CJK que quebra o tratamento WideChar no Delphi
Onde mais o narrowing aparece
XMP é a vítima visível, mas qualquer bridge de TBytes para string na mesma codebase tinha a mesma exposição. Mais dois foram corrigidos na v3.103.1: Utf8BytesToString e StringToUtf8Bytes em FPdfProduction, que fazem round-trip do pacote de datasets XFA por uma string para que MergePdfXfaDatasets possa substituir valores vinculados, e BytesToUtf8 em FPdfTrustedList, que decodifica XML de trusted list europeu depois de remover a marca de ordem de bytes. Ambos agora armazenam o buffer em uma RawByteString, marcam-no como CP_UTF8 sem converter e decodificam com UTF8ToString. Um módulo já era imune, e vale copiar o motivo. O writer XFDF declara seu próprio tipo de texto como XFDFString, resolvido como WideString no FPC e UnicodeString no Delphi, então seu encoder nunca vê uma AnsiString marcada por codepage. Essa é a correção estrutural: mantenha o texto em um tipo UTF-16 até o ponto exato de serialização e deixe uma única função estreita ser dona da conversão para bytes. Todo bug desta família veio de um campo string no meio de um pipeline que era UTF-16 em uma ponta e octetos na outra
O que verificar no seu próprio código PDF para dois compiladores
Se você distribui Object Pascal que roda nos dois compiladores e grava metadados em um PDF conforme os padrões, quatro verificações encontram a maioria dos casos desta classe antes do validator
- Procure
UTF8Encodecom argumentostring. No FPC essa chamada é no-op, e é a linha de maior retorno para auditar - Trate toda variável
UTF8Stringem modo Delphi como suspeita. Ali ela é umaAnsiStringsimples, e atribuir bytes codificados a ela os transcodifica de volta - Execute pelo menos uma regressão sob
SetMultiByteConversionCodePagecom uma codepage de um byte. Um harness LCL roda emCP_UTF8e nunca reproduzirá um programa de console simples - Monte vetores de bytes esperados em runtime e compare-os octeto por octeto. Literais de origem e
=passam pela reconciliação de codepage e esconderão o defeito que você está procurando
Nada disso é uma curiosidade exótica do Free Pascal. É o custo comum de uma linguagem que manteve um tipo de string orientado a bytes ao lado de outro UTF-16, e os dois compiladores fizeram escolhas razoáveis, mas diferentes, sobre o significado de string. A consequência prática para PDF é estreita e aguda: metadados que parecem corretos na sua IDE podem chegar ao pacote XMP como UTF-8 inválido, e a ISO 19005-1 6.7.2 não se importa com qual compilador os colocou lá. Se você está construindo um pipeline de arquivamento, a camada de codificação merece tanta atenção quanto o restante do fluxo de conformidade de arquivamento PDF/A que a envolve. O PDFium Delphi Component distribui essas conversões como parte da biblioteca, então SaveAsPdfA e suas cinco variantes de padrões emitem metadados UTF-8 conformes no Delphi, no Lazarus e em builds Free Pascal simples, sem configuração de codepage por parte do chamador. A documentação completa da API e a release atual estão na página do produto PDFium Delphi Component