Uma passada de scanner com alimentação de folhas deixa para trás uma pasta de JPEGs, um por página, com nomes como 0001.jpg, 0002.jpg e assim por diante. Ninguém quer revisar um arquivo de caso clicando por cem miniaturas de imagens; o que o acervo precisa é de um PDF por caso, com as páginas em ordem. Essa última etapa, transformar uma pilha numerada de digitalizações em um único PDF ordenado, é o trabalho deste artigo
O Componente PDFium lida com isso diretamente. Além da renderização e da extração de texto, o componente pode criar um PDF do zero: criar um documento vazio, adicionar uma página em branco com o tamanho que você desejar, soltar uma imagem nessa página nas coordenadas do espaço do usuário e depois salvar. Todo o pipeline reside no componente TPdf, portanto, um conversor em lote é um loop sobre nomes de arquivo além de um punhado de chamadas
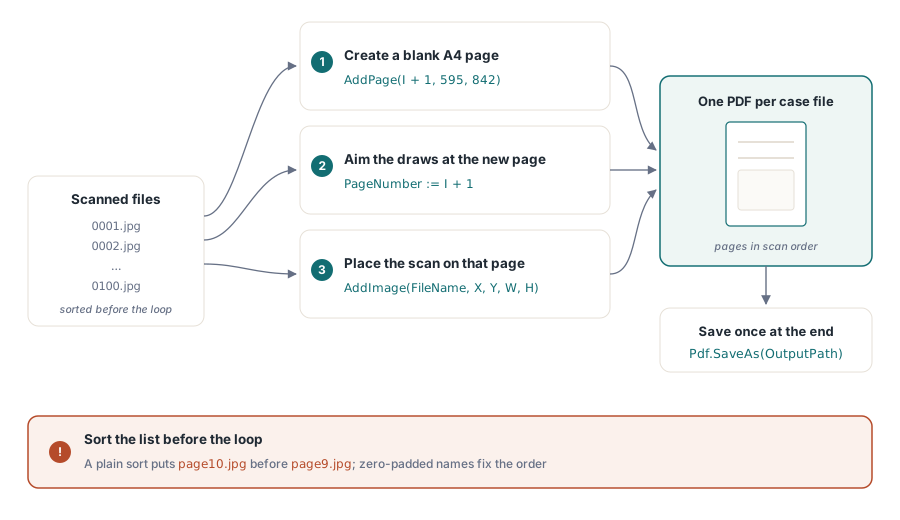
O formato da conversão
Três coisas precisam acontecer para cada digitalização. Você decide o tamanho da página, você coloca a imagem dentro da página deixando uma margem, e você avança para a próxima página. O Componente PDFium lhe dá um método para cada: AddPage cria uma página em branco com um determinado tamanho, AddImage (ou AddPicture se você já tiver um TPicture) desenha o bitmap na página atual, e PageNumber diz ao componente qual página as chamadas de desenho subsequentes têm como alvo
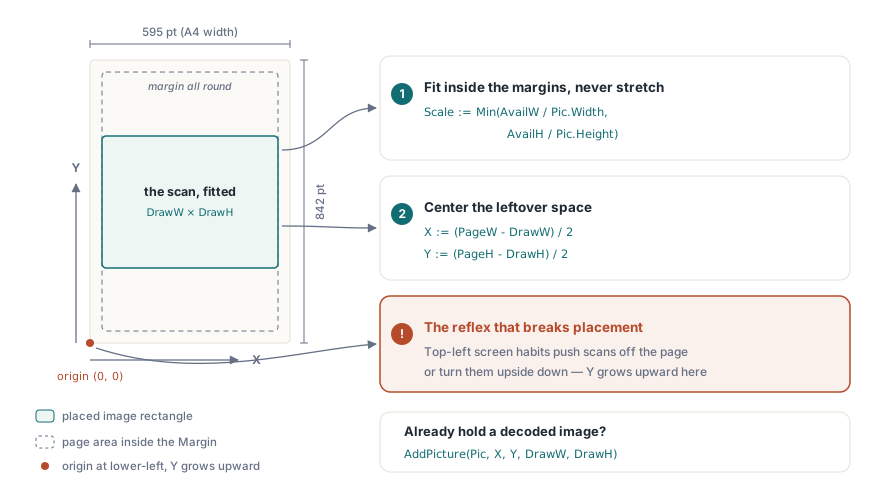
A única coisa que confunde as pessoas é o sistema de coordenadas. O espaço do usuário do PDF coloca a origem no canto inferior esquerdo da página, com o Y aumentando para cima, o oposto das coordenadas de tela que os desenvolvedores Delphi buscam por reflexo. O X, Y que você passa para AddImage é o canto inferior esquerdo do retângulo da imagem, e Width, Height são o tamanho da colocação em pontos, não o tamanho em pixels do arquivo de origem. Faça o inverso e suas digitalizações cairão fora da página ou de cabeça para baixo em relação a onde você esperava que elas estivessem
Criando o documento e uma página por digitalização
Comece com um documento vazio. CreateDocument aloca um PDF novo e deixa o componente ativo, portanto, não há uma etapa de abertura separada. A partir daí você percorre a lista de arquivos digitalizados e, para cada um, você adiciona uma página, a torna atual e coloca a imagem. As dimensões da página aqui são A4 em pontos (595 × 842 retrato), o tamanho de folha padrão para correspondência arquivada
procedure TArchiveForm.ScansToPdf(const Files: TStrings; const OutputPath: string);
const
  PageW = 595.0;   // largura A4 em pontos
  PageH = 842.0;   // altura A4 em pontos
  Margin = 36.0;   // borda de meia polegada ao redor de cada digitalização
var
  I: Integer;
  Pdf: TPdf;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;                       // novo, vazio, já ativo
    for I := 0 to Files.Count - 1 do
    begin
      Pdf.AddPage(I + 1, PageW, PageH);       // índice de página baseado em 1
      Pdf.PageNumber := I + 1;                // torna a nova página atual
      PlaceScan(Pdf, Files[I], PageW, PageH, Margin);
    end;
    Pdf.SaveAs(OutputPath);
  finally
    Pdf.Free;
  end;
end;
Cada iteração cria uma página e imediatamente define o PageNumber para ela. Essa segunda linha importa: AddPage insere a página, mas os métodos de desenho atuam na página que estiver atual, então definir o PageNumber é o que direciona AddImage para a página que você acabou de criar. Pule isso e suas imagens vão se empilhar em qualquer página que por acaso estivesse carregada antes
Uma suposição se esconde naquele loop: a ordem de Files. Um scanner nomeia páginas de 0001.jpg a 0100.jpg, mas uma enumeração de diretório nem sempre as retorna classificadas e, no momento em que você encontra a page9.jpg perto da page10.jpg, uma classificação de string simples coloca a página 10 antes da página 9. Classifique a lista explicitamente antes do loop e prefira nomes preenchidos com zeros na hora da digitalização, para que a ordem lexical corresponda à ordem das páginas. A sequência das páginas é a primeira coisa que um revisor percebe e é o erro mais barato de se evitar
Colocando uma digitalização e mantendo a sua proporção
Raramente uma digitalização tem o mesmo formato da página. Se você a esticar para preencher a folha, você distorce o texto; se você a colocar no tamanho total em pixels, ela transborda. A solução é escalar pela menor das duas proporções, adequar à largura ou adequar à altura e centralizar o que sobrar. Como a origem fica no canto inferior esquerdo, a centralização significa dividir o espaço restante uniformemente e adicioná-lo tanto ao X quanto ao Y
procedure TArchiveForm.PlaceScan(Pdf: TPdf; const FileName: string;
  PageW, PageH, Margin: Double);
var
  Pic: TPicture;
  AvailW, AvailH, Scale, DrawW, DrawH, X, Y: Double;
begin
  Pic := TPicture.Create;
  try
    Pic.LoadFromFile(FileName);              // BMP, JPG, PNG etc. pelas unidades gráficas da VCL

    AvailW := PageW - 2 * Margin;
    AvailH := PageH - 2 * Margin;

    // Ajusta dentro das margens sem distorcer a digitalização.
    Scale := Min(AvailW / Pic.Width, AvailH / Pic.Height);
    DrawW := Pic.Width * Scale;
    DrawH := Pic.Height * Scale;

    // Centraliza: espaço restante dividido igualmente. Y medido a partir do fundo da página.
    X := (PageW - DrawW) / 2;
    Y := (PageH - DrawH) / 2;

    Pdf.AddImage(FileName, X, Y, DrawW, DrawH);
  finally
    Pic.Free;
  end;
end;
Isso carrega o arquivo uma vez para ler as suas dimensões em pixels, calcula uma escala uniforme única e passa o retângulo de posicionamento para AddImage. O AddImage aceita um caminho de arquivo diretamente e o encaminha por meio do mesmo pipeline de imagem do AddPicture, portanto, qualquer formato que as unidades gráficas VCL reconheçam funciona sem casos especiais. Se você já tem a imagem decodificada em um TPicture vinda do painel de visualização, chame o AddPicture(Pic, X, Y, DrawW, DrawH) contendo o idêntico arranjo sem efetuar a leiturada e carregar de novo
Pulando a decodificação para digitalizações em JPEG
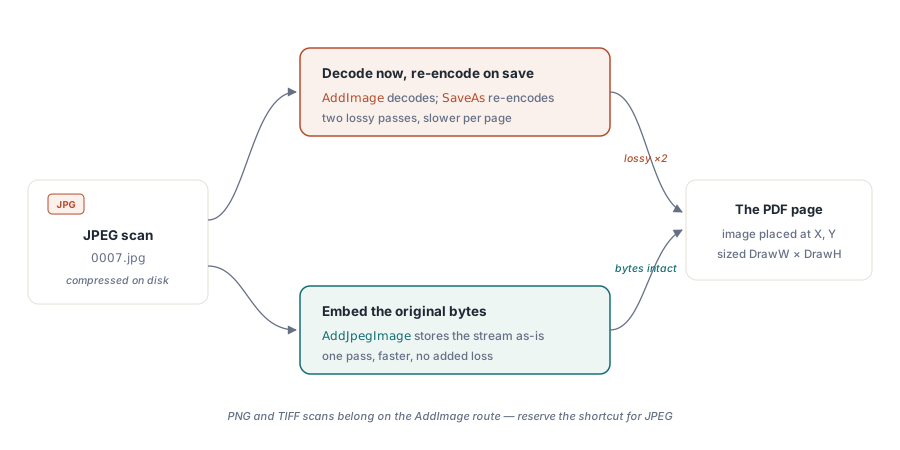
Scanners quase sempre emitem JPEG. Carregar um JPEG em um TPicture o decodifica para um bitmap completo, e esse bitmap é o que vai para o PDF. A decodificação não perde qualidade e o PDFium armazena os pixels sem perdas, então a página fica igual; o que você paga é tamanho e tempo, porque uma digitalização que chegou como um JPEG compacto é gravada como pixels brutos comprimidos sem perdas, geralmente bem maiores que o arquivo de origem. O AddJpegImage incorpora os bytes comprimidos originais direto na página a partir de um stream, então o resultado fica próximo do tamanho das digitalizações e o lote pula totalmente o trabalho de decodificação
var
  Stream: TFileStream;
begin
  // ... depois de AddPage + PageNumber para a página atual ...
  Stream := TFileStream.Create(FileName, fmOpenRead);
  try
    // Incorpora os bytes do JPEG como estão; sem ciclo de decodificação/recodificação.
    Pdf.AddJpegImage(Stream, X, Y, DrawW, DrawH);
  finally
    Stream.Free;
  end;
end;
Você continua calculando X, Y, DrawW e DrawH da mesma forma, já que ainda precisa das dimensões em pixels para definir a escala. Leia esses valores do arquivo ou faça uma leitura rápida do cabeçalho e, em seguida, passe o stream bruto para o AddJpegImage. Para digitalizações em PNG ou TIFF, o caminho correto é o AddImage; reserve o atalho do JPEG apenas para o formato ao qual ele realmente se aplica
Rotulando cada página
Arquivos digitalizados ficam mais fáceis de auditar quando cada página traz o nome do arquivo de origem. O AddText desenha uma string em uma coordenada do espaço do usuário, de modo que a legenda fique logo abaixo da imagem. Lembre-se do eixo Y invertido: para colocar um rótulo abaixo da digitalização, você subtrai a partir da borda inferior da imagem, em vez de somar a ela:
// Legenda abaixo da digitalização: Y diminui em direção ao fundo da página.
Pdf.AddText('File: ' + ExtractFileName(FileName), 'Helvetica', 9,
  X, Y - 14, clGray);
Um último ponto sobre salvar. O SaveAs retorna um Boolean, e False significa que o documento não pôde ser serializado, então verifique o resultado em vez de presumir que a gravação deu certo. Problemas do sistema de arquivos seguem o outro caminho: uma pasta de saída ausente ou um arquivo de destino bloqueado gera uma exceção na camada de arquivos, então um job em lote quer tanto a verificação do resultado quanto um handler que registre qual caso falhou. Quando o loop termina e o arquivo é gravado, você tem exatamente o que o acervo precisava: um PDF ordenado por caso, com as páginas escaladas para caber, pronto para ser lido em qualquer visualizador
Os mesmos blocos de construção cobrem tarefas relacionadas. Troque a regra de dimensionamento por página e você tem um álbum de fotos com uma imagem por folha; mantenha o loop, mas leia a partir de uma origem TIFF multipágina, e você tem um conversor de arquivo de fax. Se quiser uma visão mais ampla sobre a criação de PDFs de forma programática, veja criando documentos PDF do zero com o Componente PDFium; para renderizar o resultado de volta na tela mais tarde, veja convertendo páginas de PDF para imagens JPEG com o Componente PDFium
O Componente PDFium da loslab.com reúne as APIs de criação de documentos, renderização e texto usadas ao longo desta série