Abra a mesma fatura PDF no Windows e num celular, e as quebras de linha, as fontes e o logo caem em pontos idênticos. Um arquivo PDF é um conjunto de objetos numerados mais um índice de offsets de bytes, e um leitor como o engine PDFium dentro do PDFium Component o abre pelo fim: startxref, tabela xref, catálogo, árvore de páginas, content streams, e então pixels
Então o que é um arquivo PDF, e por que ele parece igual em todo lugar? Documentos Word e RTF guardam texto e estilos e deixam o layout para a máquina que os abre, então uma fonte ausente ou um driver de impressora diferente reflui as páginas. O PDF guarda o resultado pronto em vez disso. Todo glifo e linha tem uma posição absoluta num espaço de coordenadas medido em pontos, os programas de fonte viajam dentro do arquivo, e as imagens carregam os próprios dados de cor e filtros de compressão delas. Nada é disposto na hora da visualização, e é por isso que qualquer renderer conforme em qualquer sistema operacional pinta a mesma página. O formato começou como PDF 1.0 com o Acrobat em 1993, construído sobre o modelo de imagem do PostScript, e cada revisão adicionou parte da maquinaria descrita abaixo:
- PDF 1.1 a 1.4 trouxeram criptografia, formulários interativos, assinaturas digitais com estrutura lógica e transparência
- PDF 1.5 adicionou object streams e cross-reference streams; PDF 1.6 adicionou criptografia AES
- PDF 1.7 virou ISO 32000-1:2008, e PDF 2.0 virou ISO 32000-2:2017, revisada em 2020
- PDF/A (ISO 19005), PDF/X (ISO 15930) e PDF/UA (ISO 14289) restringem essa base para arquivamento, produção de impressão e acessibilidade
O que acontece quando um leitor abre um arquivo PDF?
Abrir um PDF é uma cadeia de consultas que começa nos últimos bytes do arquivo e termina num bitmap. Quase todo elo dessa cadeia é um dicionário, um dos tipos básicos de objeto na ISO 32000-1 §7.3, e os dicionários apontam uns para os outros com referências indiretas como 7 0 R (objeto 7, geração 0). O arquivo se comporta portanto como um grafo de objetos em vez de uma sequência de páginas. O cabeçalho, o corpo, a tabela de referência cruzada e o trailer estão dispostos no panorama da estrutura de arquivo PDF, e um PDF mínimo anotado linha por linha mostra como obj, endobj e stream ficam num editor de texto. Aqui está a ordem que todo leitor segue
- Vá até o fim do arquivo e leia o offset de bytes escrito depois da palavra-chave
startxref - Carregue os dados de referência cruzada nesse offset, que mapeia todo número de objeto a uma posição no arquivo
- Leia o trailer e siga o
/Rootaté o catálogo do documento - Siga a entrada
/Pagesdo catálogo pela árvore de páginas até o objeto de página pedido - Decodifique o content stream da página e interprete os operadores dele em ordem
- Resolva as fontes, imagens e form XObjects que esses operadores nomeiam através do
/Resources - Rasterize paths, contornos de glifos e imagens em pixels na resolução do dispositivo
Passo um: startxref e a tabela de referência cruzada
Um leitor nunca varre um PDF do topo. Um arquivo bem-formado termina com a palavra-chave startxref, um número decimal como 48211, e %%EOF, e esse número é o offset de bytes dos dados de referência cruzada. Uma busca para trás ingênua por xref para dentro de startxref, então busque a palavra-chave completa. A tabela clássica usa entradas de largura fixa (§7.5.4), o que deixa um leitor saltar para a entrada de qualquer número de objeto sem parsear as outras; o layout em bytes de cada entrada está coberto no panorama da estrutura. O trailer depois da tabela nomeia /Size, /Root e, opcionalmente, /Encrypt, /ID e /Prev
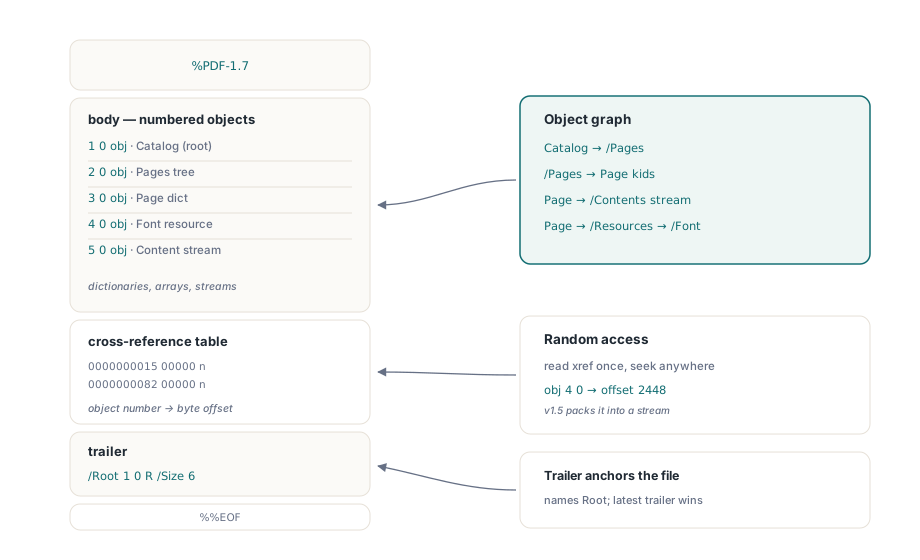
Toda entrada é uma posição absoluta de bytes, então qualquer coisa que desloque bytes, como um editor reescrevendo fins de linha, deixa o índice apontando para os lugares errados. Leitores com uma passada de reparo reconstroem o índice varrendo as palavras-chave obj; leitores sem ela recusam o arquivo, e é por isso que um PDF danificado pode abrir num visualizador e falhar em outro. O que está no offset do startxref diz em qual caso você está: a palavra-chave xref para uma tabela clássica, um header N 0 obj para um cross-reference stream do PDF 1.5, e qualquer outra coisa para um offset velho. O helper abaixo é código seu, construído sobre streams RTL simples
uses
  System.SysUtils, System.Classes;

// Seu próprio helper: Offset é o número escrito depois do startxref.
// Classifica o que o leitor vai encontrar nessa posição
function DescribeXrefAt(const FileName: string; Offset: Int64): string;
var
  FS: TFileStream;
  Buf: TBytes;
  Head: string;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if Offset >= FS.Size then
      Exit('offset beyond end of file: the file needs a repair pass');
    FS.Position := Offset;
    SetLength(Buf, 32);
    SetLength(Buf, FS.Read(Buf[0], Length(Buf)));
  finally
    FS.Free;
  end;
  Head := TEncoding.ASCII.GetString(Buf);
  if Head.StartsWith('xref') then
    Result := 'classic cross-reference table'
  else if Head.Contains(' obj') then
    Result := 'cross-reference stream (PDF 1.5 or later)'
  else
    Result := 'stale offset: the file needs a repair pass';
end;
Um cross-reference stream (§7.5.8) é um objeto comprimido com /Type /XRef, um array /W que dá a largura em bytes de cada coluna, e linhas binárias que apontam ou para um offset de bytes ou para dentro de um object stream (§7.5.7). As chaves do trailer se movem para dentro do dicionário dele, então o arquivo não tem palavra-chave trailer de forma alguma. O HotPDF escreve essa forma quando o UseXRefStream está definido no THotPDF. Para arquivos que saem do seu controle, como anexos de e-mail ou uploads para gráficas, a tabela clássica continua sendo a escolha mais segura porque leitores anteriores ao PDF 1.5 ainda a parseiam. O PDF/A-1 decide a questão para arquivos: a ISO 19005-1 se apoia no PDF 1.4, e o §6.1.4 dela declara que cross-reference streams não devem ser usados, então o HotPDF escreve uma tabela clássica sempre que um perfil PDF/A-1 está ativo
48 0 obj
<< /Type /XRef /Size 49 /Root 1 0 R
   /W [1 3 1] /Index [0 49]
   /Filter /FlateDecode /Length 162 >>
stream
...binary rows: 1 + 3 + 1 bytes each...
endstream
endobj
startxref
48211
%%EOF
De /Root à página certa: catálogo e árvore de páginas
O /Root do trailer aponta para o catálogo do documento, e o /Pages do catálogo aponta para a raiz da árvore de páginas. Todo nó /Pages intermediário carrega um /Count das páginas folha abaixo dele, então um leitor procurando a página 5.000 subtrai contagens ao descer e pula subárvores inteiras sem abrir. A ISO 32000-1 §7.7.3 não exige uma árvore balanceada; um único array /Kids com 10.000 entradas é legal, só mais lento de buscar. Código que lê apenas a folha cai numa armadilha. /Resources, /MediaBox, /CropBox e /Rotate são herdáveis (§7.7.3.4), então uma página sem /MediaBox próprio continua válida porque o valor mora num ancestral
12 0 obj
<< /Type /Page
   /Parent 3 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 7 0 R >> >>
   /Contents 13 0 R
>>
endobj
O media box define o espaço de coordenadas para tudo o que é desenhado na página: origem no canto inferior esquerdo, Y correndo para cima, uma unidade igual a 1/72 de polegada a menos que um /UserUnit do PDF 1.6 escale isso. O PDFium Component faz a descida inteira quando você pede uma página por número. O TPdf.PageMetrics devolve o tamanho da página em pontos com as caixas herdadas já resolvidas, mais a rotação da página, então a listagem abaixo reporta tamanhos corretos mesmo para arquivos cujas páginas folha não carregam caixa própria
uses
  System.SysUtils, PDFium;

// Imprime a contagem de páginas e o tamanho de cada página em pontos
procedure ListPages(const FileName: string);
const
  Degrees: array[TRotation] of Integer = (0, 90, 180, 270);
var
  Pdf: TPdf;
  I: Integer;
  M: TPdfPageMetrics;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;           // parseia os dados xref, o trailer e o catálogo
    if not Pdf.Active then        // uma carga que falha deixa Active = False
      raise Exception.Create('Cannot open ' + FileName);
    Writeln(Pdf.PageCount, ' pages');
    for I := 1 to Pdf.PageCount do
    begin
      M := Pdf.PageMetrics[I];    // com base 1; carrega a página pela árvore
      Writeln(Format('Page %d: %.1f x %.1f pt, /Rotate %d',
        [I, M.Width, M.Height, Degrees[M.Rotation]]));
    end;
  finally
    Pdf.Free;
  end;
end;
Como um PDF desenha uma página na tela?
O conteúdo visível de uma página é um pequeno programa: operadores postfix em um ou mais content streams, interpretados em ordem depois que o leitor roda o decoder nomeado no /Filter, na maioria das vezes /FlateDecode. BT abre um objeto de texto, Tf seleciona um recurso de fonte e um tamanho, Td move a posição do texto, Tj pinta uma string, e ET fecha o objeto. Paths são construídos com m, l, c e re, então preenchidos com f ou traçados com S. O estado gráfico (§8.4) guarda o que esses operadores leem implicitamente, como a matriz de transformação, cores e clipping path. q empurra uma cópia e Q a desempilha, então uma transformação definida dentro do par não pode vazar para conteúdo posterior
q
1 0 0 1 72 700 cm     % move a origem para (72, 700)
BT
  /F1 12 Tf           % recurso de fonte F1 a 12 pontos
  0 0 Td
  (Invoice 2026-0417) Tj
ET
0.2 0.2 0.8 RG        % cor de traço, com escopo do q/Q
0 -6 m 140 -6 l S
Q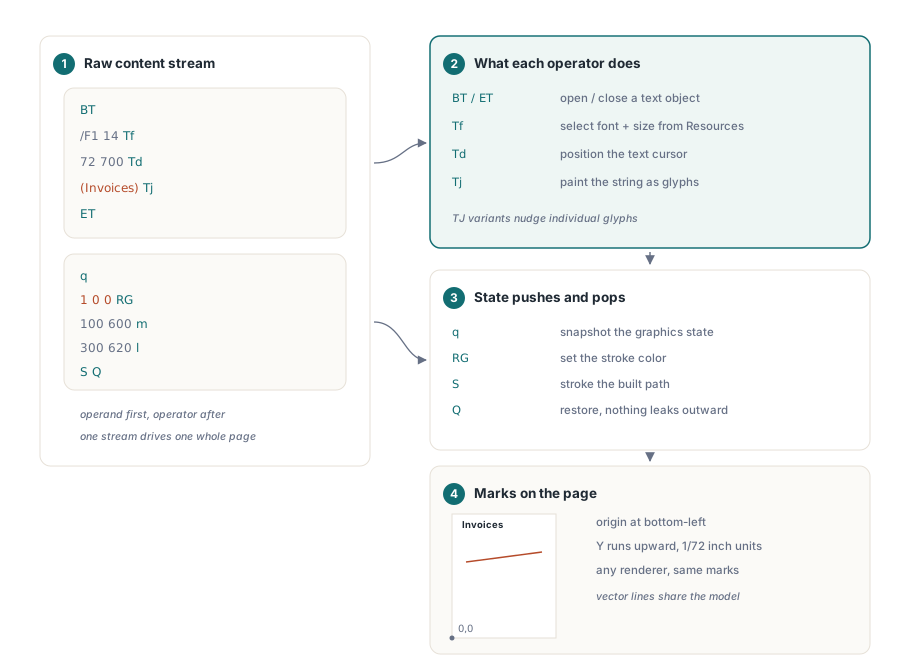
Names como /F1 são chaves para o /Resources da página. Um dicionário de fonte leva através do font descriptor dele (§9.8) até o programa de fonte incorporado, e uma imagem é pintada com um único Do depois que os dados JPEG ou Flate dela são decodificados. A rasterização vem por último. O renderer aplica a matriz de transformação a todo path e contorno de glifo, mapeia pontos para pixels do dispositivo, e preenche o resultado com anti-aliasing. Como a página ainda é dado vetorial nesse ponto, dar zoom a 400 por cento roda o content stream de novo numa escala maior em vez de esticar um bitmap. A resolução alvo é escolhida pelo chamador: 96 ou 150 pixels por polegada para tela, 300 ou mais para impressão. No PDFium Component essa etapa é o TPdf.RenderPage, que recebe o tamanho de saída em pixels
uses
  System.SysUtils, Vcl.Graphics, PDFium;

// Renderiza a página 1 de FileName a Dpi pixels por polegada e salva como BMP
procedure RenderFirstPage(const FileName: string; Dpi: Integer);
var
  Pdf: TPdf;
  Bmp: TBitmap;
  W, H: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.Create('Cannot open ' + FileName);
    Pdf.PageNumber := 1;        // com base 1
    // PageWidth e PageHeight estão em pontos (1/72 de polegada)
    W := Round(Pdf.PageWidth * Dpi / 72);
    H := Round(Pdf.PageHeight * Dpi / 72);
    Bmp := Pdf.RenderPage(0, 0, W, H, ro0, [reAnnotations]);
    try
      Bmp.SaveToFile(ChangeFileExt(FileName, '-p1.bmp'));
    finally
      Bmp.Free;                 // a forma função devolve um bitmap novo
    end;
  finally
    Pdf.Free;
  end;
end;
Por que copiar e colar devolve lixo quando a página parece boa?
Copiar e colar falha quando o arquivo registra qual glifo desenhar mas não qual caractere ele representa. A renderização precisa só das formas de glifo do programa de fonte incorporado. A extração precisa de Unicode, que vem de uma codificação padrão ou de um CMap /ToUnicode no dicionário de fonte (§9.10.3). Uma fonte composta com /Encoding /Identity-H escreve glyph IDs brutos no content stream, e sem um mapa ToUnicode esses IDs não têm relação definida com caractere nenhum. A tela parece perfeita enquanto a área de transferência enche de símbolos. Fontes subset tornam isso mais provável, já que guardam só os glifos que o documento usa e são fáceis de notar pelo prefixo de seis letras em names como /BaseFont /AAAAAA+ArialMT (§9.6.4). O guia de tratamento de fontes do PDF cobre fontes CJK e extração quebrada em profundidade
Atualizações incrementais e o byte range da assinatura
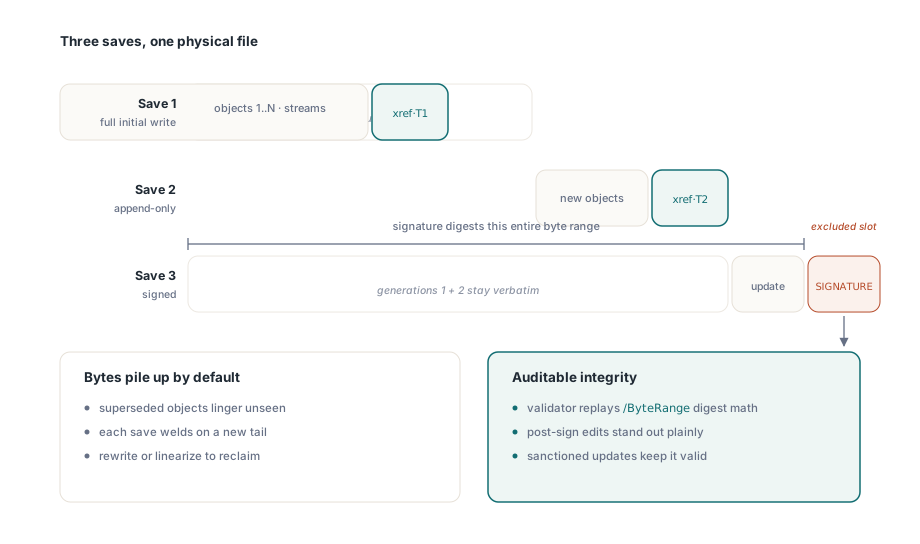
Assinaturas dependem do jeito append-only como PDFs são editados: uma atualização incremental (§7.5.6) adiciona objetos e uma nova seção de referência cruzada depois do último %%EOF, e o panorama da estrutura explica a cadeia /Prev e por que conteúdo deletado sobrevive em revisões anteriores. O /ByteRange de um dicionário de assinatura, escrito como [0 a b c], calcula o hash de tudo exceto a string hex /Contents que guarda a assinatura CMS, então a revisão assinada termina no byte b + c e um validador a reconstrói truncando o arquivo ali. Revisões posteriores aterrissam depois desse ponto, enquanto uma reescrita completa, um linearizador ou uma passada de optimize move bytes que o signatário hasheou e invalida toda assinatura existente de uma vez
Quando uma aplicação Delphi ou Lazarus precisa desse pipeline inteiro, do parse dos dados de referência cruzada e da caminhada pela árvore de páginas à renderização e extração de texto, o PDFium Component para Delphi e Lazarus o embrulha no componente de documento TPdf usado nas listagens acima e no controle viewer TPdfView para exibição na tela