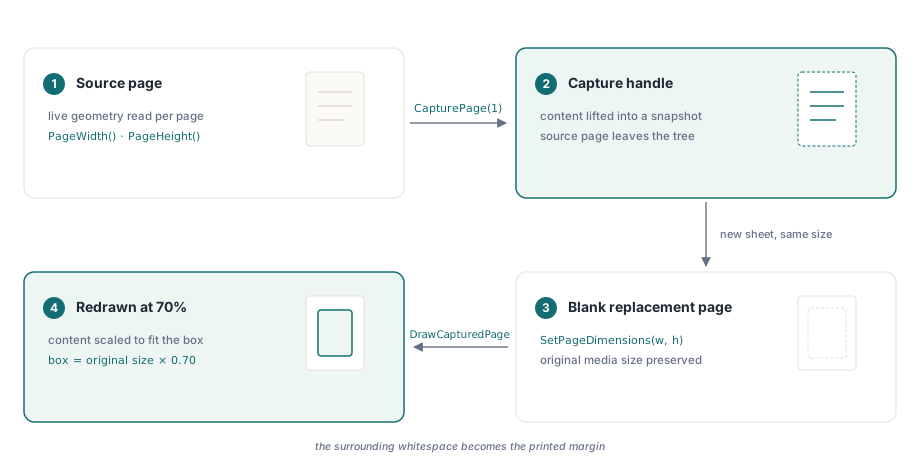
As dimensões da página PDF são fixadas no momento em que uma página é criada, portanto, você não pode simplesmente redimensionar o conteúdo no local como faria com uma imagem. O modelo da biblioteca que torna a redução prática é o de captura e redesenho: retirar o conteúdo de cada página do documento para um handle, criar uma nova página em branco no tamanho original da mídia, em seguida, desenhar o conteúdo capturado de volta em uma caixa delimitadora reduzida. O espaço em branco ao redor se torna a margem. Em uma escala de 70% em uma página A4, por exemplo, 15% da largura recai de cada lado e a mesma fração na parte superior e inferior, o que é exatamente o que a aritmética de borda abaixo produz
Como o CapturePage funciona
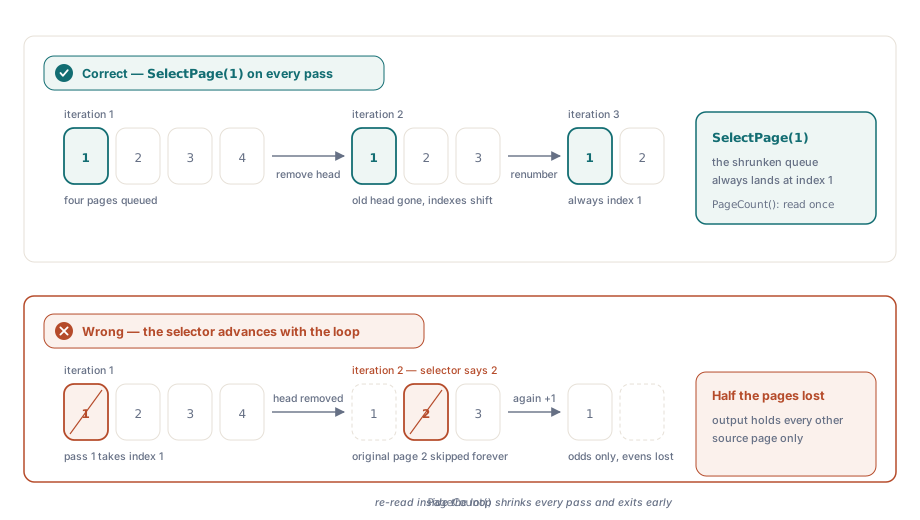
O CapturePage recebe um número de página, promove o conteúdo dessa página para um objeto de captura na memória e remove a página da árvore de páginas do documento. Essa remoção é intencional e é o motivo pelo qual o loop sempre seleciona a página 1 independentemente do índice de iteração: uma vez que a página 1 é capturada e excluída, o que era a página 2 torna-se a nova página 1 e assim por diante. Se você incrementar o seletor de página junto com o contador de loop, pulará páginas intercaladas e acabará com metade da saída esperada
O handle de captura retornado pelo CapturePage não é uma referência de página; é mais parecido com um snapshot de conteúdo. Ele continua válido depois do desenho, de modo que a mesma captura pode ser colocada mais de uma vez, até que você o libere com ReleaseCapturedPage ou o documento acabe. O DrawCapturedPage recebe esse handle mais um retângulo de destino dado como borda esquerda, borda superior, largura e altura, todos em points por padrão. A biblioteca escala o conteúdo capturado para caber exatamente nesse retângulo, preservando a proporção só se o seu retângulo por acaso corresponder às proporções originais. Para escala uniforme você quer que o retângulo seja o tamanho original multiplicado pelo fator de escala, centralizado na página
A matemática de centralização
Com um fator de escala de 70%, os 30% restantes de cada dimensão são divididos igualmente entre os dois lados. Portanto, o recuo horizontal é pageWidth * (1.0 - 0.70) / 2, o que equivale a 15% da largura, e o recuo vertical segue a mesma fórmula usando a altura da página. O retângulo de destino para DrawCapturedPage então começa em (horizBorder, vertBorder) e abrange pageWidth - 2 * horizBorder por pageHeight - 2 * vertBorder. Essa aritmética não é específica da biblioteca; é apenas a geometria de ajustar um retângulo menor simetricamente dentro de um maior
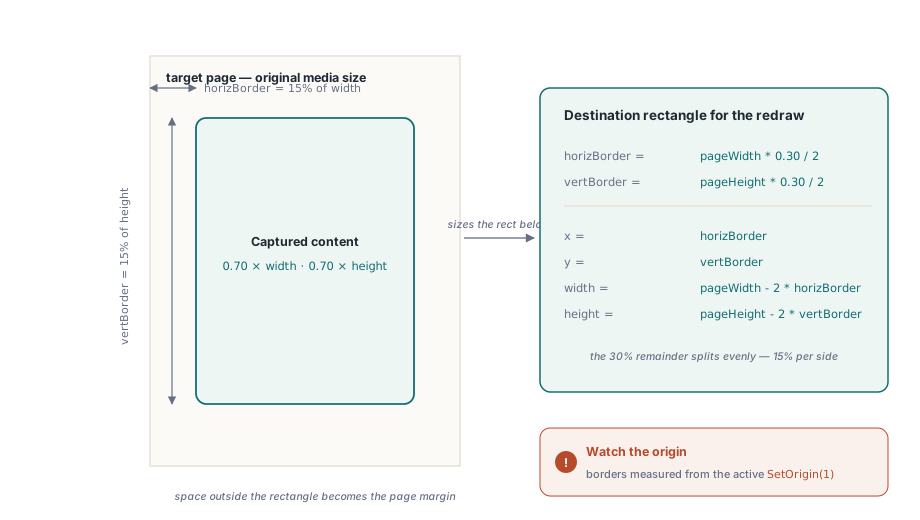
Uma coisa que vale a pena notar: o SetOrigin(1) coloca a origem das coordenadas no canto superior esquerdo em vez do inferior esquerdo. O segundo valor que você passa ao DrawCapturedPage é a borda superior do retângulo, medida a partir da origem que você definir. É por isso que os exemplos chamam SetOrigin(1) primeiro: com a origem padrão no canto inferior esquerdo, a mesma vertBorder colocaria a borda superior perto do fundo da página e empurraria a maior parte do conteúdo para fora dela
Exemplo em C#
O código a seguir processa cada página de Pages.pdf pelo ciclo de captura e redesenho e grava o resultado em newpages.pdf. O PDFL é uma instância da classe de importação PDFlibrary que vem com a edição DLL, criada com new PDFlibrary("PDFlibDLL64.dll"); a edição ActiveX expõe os mesmos métodos através de PDFlibAX.PDFlibrary
private void ScalePages_Click(object sender, EventArgs e)
{
    File.Delete("newpages.pdf");

    double pageWidth, pageHeight, horizBorder, vertBorder;
    double scaleFactor = 0.70;
    int capturedPageId, ret;

    PDFL.LoadFromFile("Pages.pdf", "");
    PDFL.SetOrigin(1);

    int numPages = PDFL.PageCount();

    for (int i = 1; i <= numPages; i++)
    {
        // Sempre selecione a página 1: o CapturePage remove a página, então a página 2
        // vira a página 1 na iteração seguinte.
        PDFL.SelectPage(1);

        pageWidth  = PDFL.PageWidth();
        pageHeight = PDFL.PageHeight();

        horizBorder = pageWidth  * (1.0 - scaleFactor) / 2;
        vertBorder  = pageHeight * (1.0 - scaleFactor) / 2;

        capturedPageId = PDFL.CapturePage(1);
        // 0 = nada capturado, ex. uma fonte de uma página: a única página não pode ser removida
        if (capturedPageId == 0)
            throw new InvalidOperationException("CapturePage failed on source page " + i);

        PDFL.NewPage();
        PDFL.SetPageDimensions(pageWidth, pageHeight);

        ret = PDFL.DrawCapturedPage(
            capturedPageId,
            horizBorder, vertBorder,
            pageWidth  - 2 * horizBorder,
            pageHeight - 2 * vertBorder);
        if (ret != 1)
            throw new InvalidOperationException("DrawCapturedPage failed on source page " + i);
    }

    PDFL.SaveToFile("newpages.pdf");
}
Exemplo em Delphi
A versão em Delphi usa o TPDFlib diretamente em vez da classe de importação da DLL, mas a sequência de chamadas é idêntica. Uma diferença prática é a guarda do arquivo de saída: FileExists mais DeleteFile em vez de File.Delete, porque o SaveToFile falha se o destino estiver bloqueado por uma execução anterior ainda aberta em um visualizador
procedure TForm1.ScalePagesClick(Sender: TObject);
var
  PDFLib: TPDFlib;
  pageWidth, pageHeight, horizBorder, vertBorder: Double;
  scaleFactor: Double;
  capturedPageId, ret, numPages, i: Integer;
begin
  if FileExists('newpages.pdf') then
    DeleteFile('newpages.pdf');

  scaleFactor := 0.70;

  PDFLib := TPDFlib.Create;
  try
    PDFLib.LoadFromFile('Pages.pdf', '');
    PDFLib.SetOrigin(1);

    numPages := PDFLib.PageCount();

    for i := 1 to numPages do
    begin
      PDFLib.SelectPage(1);

      pageWidth  := PDFLib.PageWidth();
      pageHeight := PDFLib.PageHeight();

      horizBorder := pageWidth  * (1.0 - scaleFactor) / 2;
      vertBorder  := pageHeight * (1.0 - scaleFactor) / 2;

      capturedPageId := PDFLib.CapturePage(1);
      // 0 = nada capturado, ex. uma fonte de uma página: a única página não pode ser removida
      if capturedPageId = 0 then
        raise Exception.CreateFmt('CapturePage failed on source page %d', [i]);

      PDFLib.NewPage();
      PDFLib.SetPageDimensions(pageWidth, pageHeight);

      ret := PDFLib.DrawCapturedPage(
        capturedPageId,
        horizBorder, vertBorder,
        pageWidth  - 2 * horizBorder,
        pageHeight - 2 * vertBorder);
      if ret <> 1 then
        raise Exception.CreateFmt('DrawCapturedPage failed on source page %d', [i]);
    end;

    PDFLib.SaveToFile('newpages.pdf');
  finally
    PDFLib.Free;
  end;
end;
O que o fator de escala realmente controla
O valor 0,70 aqui significa que o conteúdo renderizado ocupa 70% de cada dimensão da página, não que o arquivo tem 70% do tamanho em bytes original. O tamanho do arquivo depois dessa operação depende da complexidade do conteúdo original; uma página com imagens grandes não encolhe proporcionalmente porque os dados de pixel são redesenhados na mesma resolução numa área menor. Se um arquivo menor é o objetivo, olhe o CompressContent para streams de conteúdo de página que saíram descomprimidos e a recompresão de imagens (OptimizeImages na edição Delphi), não escalonamento geométrico. O LinearizeFile é uma ferramenta diferente: ele reordena o arquivo para carregamento página a página (Fast Web View), o que ajuda visualizadores a abrir arquivos grandes numa rede, mas não os encolhe
O número de 70% também não é um limite estrito. Qualquer valor entre 0,0 e 1,0 funciona, e valores acima de 1,0 ampliam o conteúdo além do limite original da página, o que causará corte na borda da caixa de mídia (media box) a menos que você também aumente as dimensões da página. Documentos de tamanhos mistos são manipulados naturalmente porque PageWidth e PageHeight são consultados por página antes do cálculo da borda, de modo que um documento onde as páginas ímpares são A4 e as páginas pares são A3 produzirá uma saída corretamente centralizada em cada tamanho de página sem nenhum tratamento especial
Onde as coisas podem dar errado
Dois modos de falha surgem na prática. O primeiro é um arquivo de saída deixado aberto em um visualizador de PDF de uma execução anterior: SaveToFile falhará ou gravará zero bytes dependendo da plataforma, e a nova saída nunca é salva. A proteção de exclusão de arquivo no topo da função lida com isso para desenvolvimento, mas em um pipeline de produção gravar em um caminho temporário e renomear em caso de sucesso é mais seguro
O segundo é incompatibilidade de contagem de páginas. Como o CapturePage remove páginas do documento ao processá-las, a contagem que você lê do PageCount() antes do loop é o limite correto contra o qual iterar. Chamar PageCount() dentro do loop também não ajuda: cada passada remove uma página e acrescenta uma, então a contagem fica plana e não diz nada sobre quantas páginas de origem restam. A variável de loop nos exemplos serve apenas como contador de iterações restantes; ela nunca é usada para selecionar uma página, porque a página a selecionar é sempre a 1, pelo motivo explicado antes
As chamadas de manipulação de página mostradas aqui, incluindo CapturePage, DrawCapturedPage e SetPageDimensions, fazem parte da Biblioteca PDF losLab para Delphi, C#, VB.NET e C++