Dois minutos para copiar três páginas de um PDF de 40 páginas não é um problema de ajuste de desempenho. É um sinal de que o caminho errado da API está sendo usado. Quando eu vi esse tempo de execução pela primeira vez em código de cópia de páginas construído sobre o Componente HotPDF, meu instinto foi examinar a estrutura do documento primeiro e o código depois. E essa ordem se revelou ao contrário
O que realmente estava lento
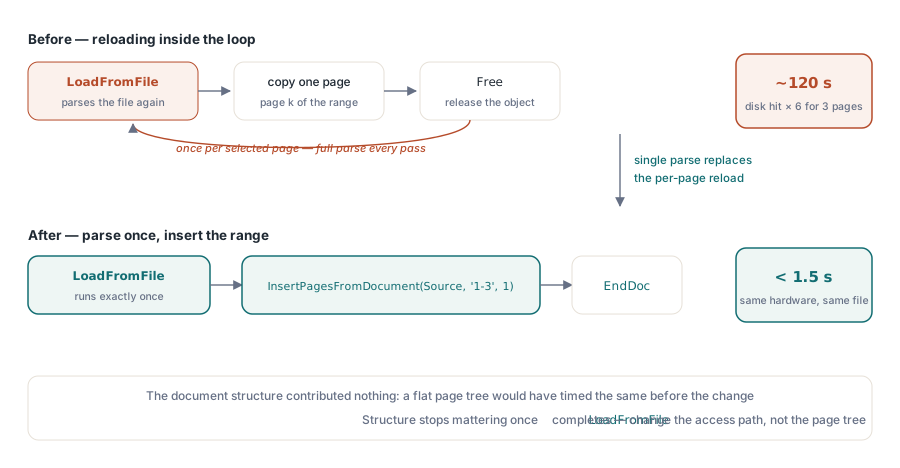
O PDF em questão era um documento de referência de 40 páginas com uma árvore de páginas não trivial: múltiplos nós intermediários /Pages em vez de um único array plano. O código em questão chamava LoadFromFile e então construía um novo documento com BeginDoc, repetia sobre os números de página selecionados e, a cada iteração, carregava novamente o documento de origem do disco para puxar uma página. É o custo total da análise multiplicado por quantas páginas você quiser. Um arquivo de 12 MB atingiu o disco seis vezes para uma extração de três páginas porque ninguém analisou se o arquivo precisava ficar aberto entre as iterações
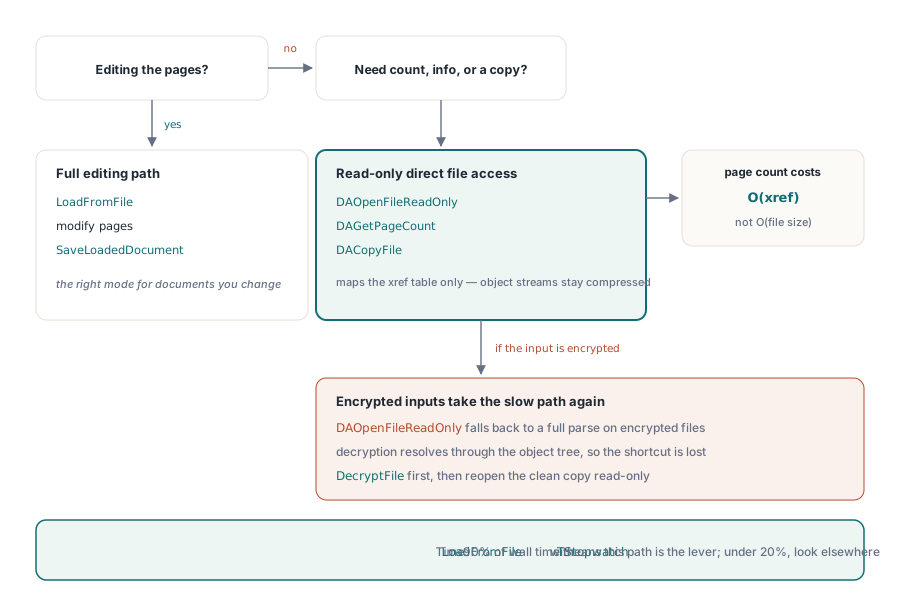
O segundo colaborador era invisível no código: o LoadFromFile do HotPDF constrói o modelo de objetos em memória sobre o qual a API de edição trabalha. É o comportamento correto para um documento que você está prestes a modificar, mas é mais trabalho do que você precisa se tudo o que quer é a contagem de páginas e um subconjunto de páginas. Para o acesso de leitura à estrutura, o DAOpenFileReadOnly evita a desserialização de toda a árvore de objetos, o que faz diferença em arquivos compactados com recursos extensos de imagem
Ambos se resumem a escolher a API feita para um trabalho e usá-la para outro diferente
Usando ExtractPagesToFile para extração de páginas
O caminho certo para copiar um intervalo de páginas de um documento HotPDF carregado para um novo arquivo é o ExtractPagesToFile, chamado após o LoadFromFile na origem. Você carrega a origem uma vez, e a chamada constrói o documento de destino, copia as páginas selecionadas para ele e grava em disco, tudo a partir da cópia que já está em memória:
procedure ExtractPages(const SourceFile, DestFile: string;
  const PageRange: string);
var
  Source: THotPDF;
begin
  Source := THotPDF.Create(nil);
  try
    // Carrega a origem uma vez: o parse completo acontece aqui e somente aqui
    if Source.LoadFromFile(SourceFile) <= 0 then
      raise Exception.Create('Source PDF has no pages');

    // Escreve o intervalo solicitado ('1-3', '1,5,7-9') direto para um novo arquivo
    Source.ExtractPagesToFile(DestFile, PageRange);
  finally
    Source.Free;
  end;
end;
O parâmetro PageRange aceita o mesmo formato que a amostra de linha de comando: uma lista separada por vírgula de números ou intervalos de páginas como '1-3' ou '1,5,7-9'. As páginas são base 1. O ExtractPagesToFile copia cada página selecionada junto com os streams de conteúdo e os recursos que ela referencia, então para uma extração de três páginas de um documento de 40 páginas o working set continua pequeno
Cronometragem no mesmo arquivo de 12 MB que antes demorava dois minutos: cerca de 1,3 segundos com este padrão. A maior parte desse tempo é a única chamada LoadFromFile. A estrutura do documento é irrelevante assim que a tabela de objetos é resolvida na primeira vez
Quando o LoadFromFile é muito pesado: a API Direta de Arquivo
Se você precisar apenas contar páginas, inspecionar as informações do documento ou copiar um arquivo sem tocar no conteúdo, a API Direta de Arquivo evitará que todo o parsing seja efetuado por completo. DAOpenFileReadOnly rastreia a tabela de referências cruzadas sem descompactar as sequências dos objetos para que o cômputo das páginas venha a ser O(tamanho do xref) e não O(tamanho do arquivo):
procedure InspectPDF(const FileName: string);
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly(FileName, '');
    if Handle <= 0 then
      Exit;
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      Writeln('Pages: ', PageCount);

      // DACopyFile é uma cópia que preserva os bytes, sem nova serialização
      Pdf.DACopyFile(FileName, 'archive-copy.pdf');
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;
A ressalva: DAOpenFileReadOnly aceita um parâmetro de senha, mas recorre a uma análise completa para entradas criptografadas, porque a descriptografia requer a árvore de objetos para resolver o dicionário de criptografia. Se os seus arquivos de origem forem criptografados, descriptografe-os primeiro com DecryptFile para obter uma cópia não criptografada, e então abra-a com a API Direta de Arquivo. A função DecryptFile no nível do arquivo utiliza um caminho direto de reescrita AES-256 para criptografia padrão e é mais rápida do que LoadFromFile seguido de SaveLoadedDocument para arquivos grandes, porque não constrói o modelo completo de objeto em memória
Memória durante o processamento em lote grande
Trabalhos em lote que processam dezenas de arquivos em um laço possuem um padrão que parece correto, mas acumula memória: criar THotPDF dentro do laço, chamar LoadFromFile, realizar o trabalho e chamar Free. Estruturalmente, isso está certo. O problema é quando o trabalho interno aloca objetos temporários (scratch objects), captura exceções e deixa esses objetos temporários vivos em caminhos de erro. O gerenciador de memória do Delphi não compacta, de modo que cem vazamentos por caminhos de erro ao longo de uma execução em lote podem elevar a memória a ponto de retardar a alocação de todo o resto
A solução não é exótica. Todo THotPDF e todo TStream ou TBitmap intermediário que participa do trabalho com PDF pertence a um bloco try/finally onde Free é a última instrução. Defina ponteiros locais como nil antes do try para que o bloco finally possa usar if Assigned(x) then x.Free de forma segura quando a inicialização falhar na metade do caminho. Esta é a disciplina de propriedade padrão do Delphi e resolve completamente este tipo de problema
Mais uma coisa para saber em contextos de lote: o AddImage registra cada imagem no documento sendo construído, e o HotPDF libera esses registros quando o EndDoc termina aquele arquivo. O registro segue o ciclo BeginDoc/EndDoc, e não o LoadFromFile, então o padrão limpo para um lote é uma instância de THotPDF por documento: crie, faça o trabalho, salve, libere
Medindo antes de mudar qualquer coisa
Antes de recorrer a qualquer um desses padrões, faça medições. O TStopwatch do Delphi em System.Diagnostics encapsula QueryPerformanceCounter e é preciso o suficiente para a criação de perfis de tempo de relógio de parede (wall-clock profiling) de E/S de arquivos. Envolva apenas LoadFromFile e veja quanto tempo ele consome. Se for 90% do tempo total, a correção será a API Direta de Arquivo ou reduzir o número de vezes em que você analisa o mesmo arquivo. Se for abaixo de 20%, o gargalo estará em algum lugar diverso, significando que o direcionamento não condiz
A extração de dois minutos que deu início a este post acabou sendo inteiramente devido ao padrão de carregamentos repetidos. A estrutura do documento não contribuiu em nada; uma árvore de páginas plana teria rodado da mesma forma. Mudar para um único LoadFromFile seguido de uma chamada ExtractPagesToFile trouxe o tempo para cerca de 1,3 segundos no mesmo hardware sem alterar mais nada
A API de manipulação de páginas mostrada aqui é parte do Componente HotPDF para Delphi e C++Builder