Digite =NORM.DIST(115,100,15,TRUE) numa célula e o Excel devolve 0.8413447 sem cerimônia. A chamada parece uma consulta simples, mas não é. Atrás desse número está a distribuição normal acumulada, uma integral sem forma fechada, e por trás de CHISQ.INV.RT e BETA.DIST há funções especiais que uma biblioteca cuidadosa precisa avaliar, e não aproximar na mão. Um componente de planilhas que declara compatibilidade com o Excel precisa reproduzir esses valores até o último dígito que o Excel exibe, o que significa reproduzir os métodos numéricos, e não apenas os nomes das funções
O HotXLS implementa mais de cinquenta dessas funções estatísticas, e o trabalho que as faz corretas é quase inteiramente invisível na barra de fórmulas. Este é um passeio por como o motor as calcula: o núcleo compartilhado de funções especiais, as decisões de ramificação que mantêm a aritmética estável, e uma armadilha da normal inversa que se esconde na cauda, porque o caso comum nunca passa por essa linha
Uma chamada na planilha, cinquenta distribuições por trás dela
As funções cobrem as famílias que um livro de estatística procura. Há a família normal, NORM.DIST e NORM.S.DIST com suas inversas; a família gama e qui-quadrado, GAMMA.DIST, CHISQ.DIST, CHISQ.DIST.RT, CHISQ.INV.RT; a família beta, BETA.DIST e BETA.INV; as distribuições amostrais T.DIST, T.DIST.2T, F.DIST e F.INV; o par discreto BINOM.DIST e POISSON.DIST; e os auxiliares de inferência como CONFIDENCE.T e CONFIDENCE.NORM. Da perspectiva de quem chama, cada uma é uma fórmula única. Você define as entradas em células, pede ao workbook para avaliar e lê o resultado
var
  wb: IXLSWorkbook;
  sh: IXLSWorksheet;
begin
  wb := TXLSWorkbook.Create;
  sh := wb.Sheets.Add;
  sh.Range['A1', 'A1'].Value := 115;   // observação
  sh.Range['A2', 'A2'].Value := 100;   // média
  sh.Range['A3', 'A3'].Value := 15;    // desvio padrão

  // O parser de fórmulas XLS usa ';' como separador de argumentos.
  Writeln(wb.Calculate('=NORM.DIST(A1;A2;A3;TRUE())'));   // 0.8413447
  Writeln(wb.Calculate('=CHISQ.INV.RT(0.05;10)'));        // 18.3070381
  Writeln(wb.Calculate('=BETA.DIST(0.5;2;3;TRUE())'));    // 0.6875
end;
O método Calculate no workbook compila e avalia uma fórmula ad-hoc contra a planilha viva e devolve um Variant. Um detalhe derruba as pessoas na primeira tentativa: o parser de fórmulas por trás do Calculate usa o ponto e vírgula como separador de argumentos, então é =SUM(A1;B1), e não =SUM(A1,B1). As fórmulas armazenadas nas células mantêm a vírgula padrão do Excel. O mesmo avaliador despacha todas as funções estatísticas abaixo, então uma vez que uma delas funciona no Calculate, as demais seguem o mesmo caminho
As duas funções sobre as quais todo o resto é construído
A maioria das distribuições acumuladas deste conjunto não é calculada somando ou integrando as próprias definições. Elas são calculadas a partir de duas funções especiais: a gama incompleta inferior regularizada, escrita P(a, x), e a beta incompleta regularizada, escrita Ix(a, b). Internamente esses são os auxiliares em que os dispatchers se apoiam, e a cadeia é curta. A CDF qui-quadrado é a CDF gama com parâmetro de forma df/2 e escala 2. A CDF gama é P(a, x) diretamente. As funções acumuladas t, F e binomial são todos valores da beta incompleta regularizada nos argumentos certos. A CDF de Poisson é a gama incompleta superior Q. Implemente bem as funções gama e beta e uma dúzia de distribuições herda a precisão de graça
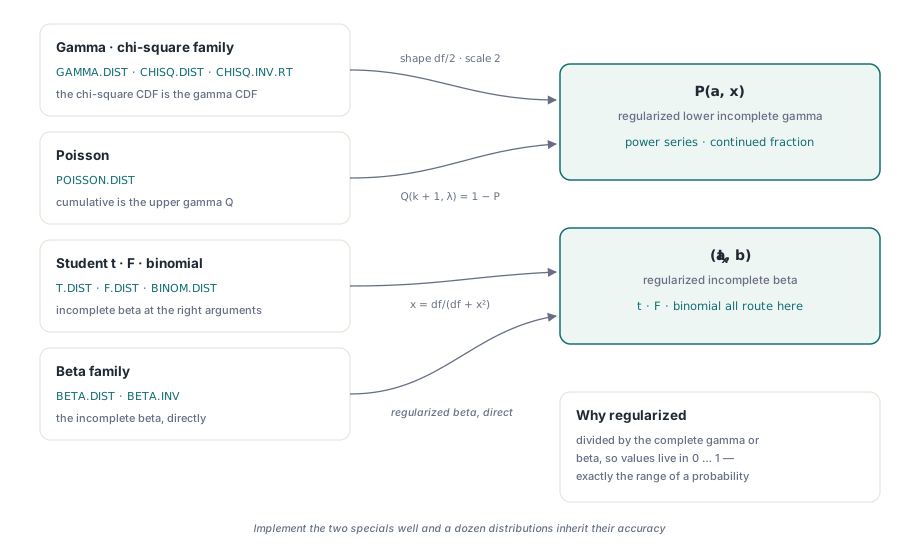
A palavra "regularizada" é o ponto central. A gama incompleta bruta cresce como um fatorial e a integral beta bruta pode sofrer underflow ou overflow bem antes da resposta. As formas regularizadas são divididas pela gama ou beta completa, então vivem inteiramente no intervalo de zero a um, que é exatamente a faixa que uma probabilidade ocupa. Essa normalização é o que permite que a mesma rotina sirva uma qui-quadrado com dois graus de liberdade e outra com duzentos, sem que os termos intermediários transbordem o limite de um double. Também explica por que você não calcula uma CDF somando uma longa cauda de termos de densidade: cada termo carrega seu próprio erro de arredondamento, os erros se acumulam conforme a série corre, e a função especial regularizada contorna a soma por completo, avaliando em vez disso uma série de convergência rápida ou uma fração contínua
Série abaixo da diagonal, fração contínua acima dela
A rotina da gama incompleta toma uma decisão antes de calcular qualquer coisa: compara x com a + 1. Essa fronteira não é arbitrária. A expansão em série de potências de P(a, x) converge rápido quando x é pequeno em relação a a, e devagar, eventualmente de forma inútil, quando x é grande. A fração contínua tem o caráter oposto. Então o motor usa a série de potências para x abaixo de a + 1 e uma fração contínua de Lentz para x em ou acima de a + 1, e cada ramo recebe só o trabalho em que é bom
A fração contínua precisa de uma proteção. O método de Lentz funciona carregando um numerador e um denominador correntes e invertendo o denominador a cada passo, e se qualquer um deles se aproxima de zero a inversão explode. O conserto é um piso minúsculo: sempre que um termo intermediário cai abaixo de aproximadamente 1e-30 em magnitude, ele é limitado a 1e-30, o que mantém a recorrência finita sem perturbar o valor convergido. O mesmo clamp aparece na fração contínua da beta incompleta, pela mesma razão. É uma pequena constante fazendo trabalho de sustentação, a diferença entre uma avaliação estável e uma divisão por algo indistinguível de zero
A cauda superior, Q(a, x), é simplesmente 1 menos P(a, x), e é assim que o ramo acumulado de Poisson é calculado: a probabilidade de no máximo k eventos com média λ é Q(k + 1, λ). Roteá-la pela gama incompleta superior em vez de somar k + 1 termos de Poisson é, de novo, uma escolha de avaliar uma única expressão convergente em vez de acumular muitas pequenas
Massas discretas sem overflow de fatorial
As distribuições discretas trazem um perigo diferente. Uma massa de probabilidade binomial envolve um coeficiente binomial, e o coeficiente de cinquenta e dois, escolhe vinte e seis, é um inteiro enorme. Formá-lo diretamente e o numerador transborda um double antes da divisão que o traria de volta a uma probabilidade sensata. O motor nunca o forma. Ele calcula os fatoriais em espaço logarítmico pela função log-gama, soma e subtrai os logaritmos, incorpora o logaritmo das probabilidades de sucesso e fracasso, e aplica a exponencial uma única vez no final
// Massa de probabilidade binomial, calculada inteiramente em espaço logarítmico.
// LnGammaF(n+1) é ln(n!); os três log-fatoriais formam ln(C(n,k)),
// e o expoente inteiro é construído antes de uma única chamada de Exp.
//   ln P(X=k) = ln(n!) - ln(k!) - ln((n-k)!) + k*ln(p) + (n-k)*ln(1-p)
result := Exp(LnGammaF(nt + 1) - LnGammaF(kk + 1) - LnGammaF(nt - kk + 1)
  + kk * Ln(pp) + (nt - kk) * Ln(1 - pp));
A própria função log-gama é uma aproximação de Lanczos, precisa por todo o eixo positivo e barata de avaliar. Como toda grandeza grande fica armazenada como seu logaritmo até o Exp final, o maior número que a rotina materializa é a própria probabilidade, que é no máximo um. A função de massa de Poisson segue a mesma receita, com o único termo de log-gama no lugar do fatorial no denominador. As formas fechadas têm caso especial nas bordas, onde p é exatamente zero ou um, então o código nunca chama Ln(0). O HotXLS devolve 0.2460938 para BINOM.DIST(5,10,0.5,FALSE) e 0.6766764 para a acumulada POISSON.DIST(2,2,TRUE), batendo com o Excel nos dígitos que ele imprime
Inversas por enquadramento da curva direta
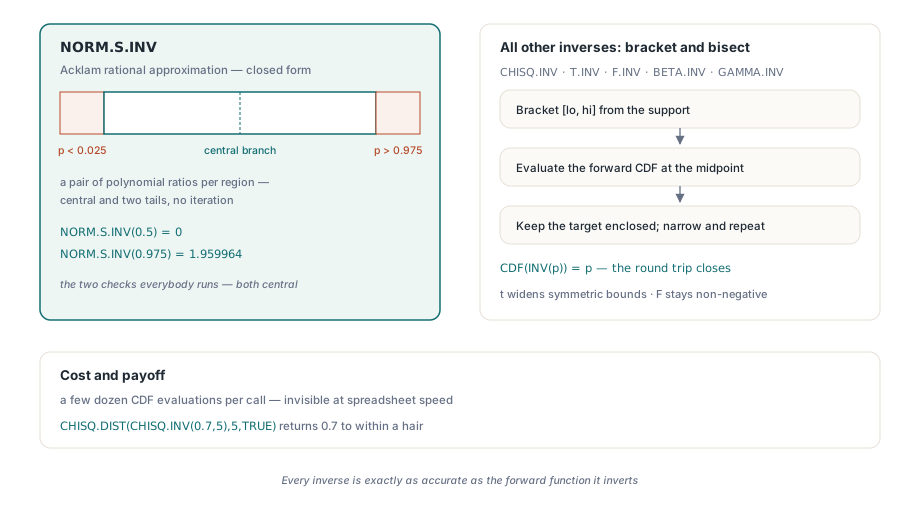
Uma função de distribuição inversa faz a pergunta oposta: dada uma probabilidade, encontrar o valor cuja CDF é igual a ela. Apenas uma inversa deste conjunto tem uma fórmula direta rápida. A NORM.S.INV, a normal padrão inversa, usa uma aproximação racional de Acklam, um par de razões polinomiais preciso a grosso modo na precisão de um double por todo o intervalo, dividido em uma região central e duas caudas. É uma avaliação de forma fechada, sem iteração
As outras inversas não têm essa fórmula, então o motor as inverte numericamente. Ele delimita a resposta com um limite inferior e um superior escolhidos a partir do suporte da distribuição, e então faz bisseção: avalia a CDF direta no ponto médio, move o limite que mantém a probabilidade alvo contida, e repete até o intervalo ficar estreito. Para as inversas gama e qui-quadrado, o intervalo começa em zero e uma estimativa superior generosa construída a partir da forma e da escala, dobrando o limite superior se a probabilidade ainda não estiver contida. A inversa t delimita bordas simétricas que se alargam para fora; a inversa F faz bisseção em um intervalo não negativo. O custo é algumas dezenas de avaliações de CDF por chamada, invisível na velocidade de planilha, e o benefício é que cada inversa é exatamente tão precisa quanto a função direta que inverte. É por isso que um vai e volta como CHISQ.DIST(CHISQ.INV(0.7,5),5,TRUE) devolve 0.7 a um cabelo
A armadilha do logaritmo na cauda
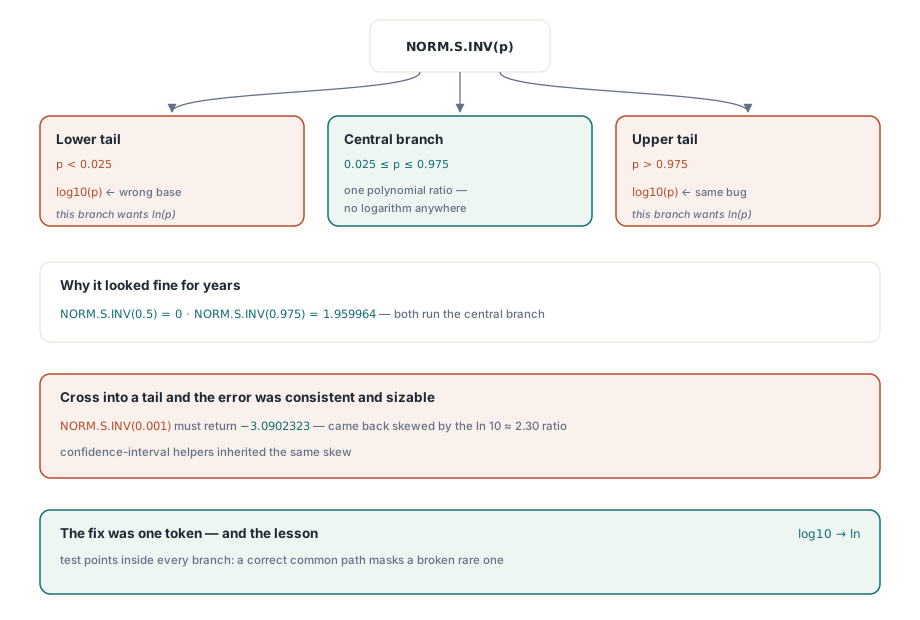
Esta é uma armadilha que vale contar, porque é do tipo que sobrevive muito tempo em qualquer implementação. A rotina de normal inversa de Acklam tem três ramos. O ramo central largo, usado sempre que a probabilidade fica entre cerca de 0.025 e 0.975, passa a entrada por uma razão polinomial sem nenhum logaritmo em lugar nenhum. Os dois ramos de cauda, para probabilidades muito pequenas ou muito grandes, tomam primeiro um logaritmo da entrada, porque a cauda se comporta como a raiz quadrada de menos o logaritmo natural de p
Tome um logaritmo de base 10 num ramo de cauda onde pertence o logaritmo natural, e os resultados da cauda saem errados por uma margem consistente e considerável, porque os dois diferem por um fator constante de cerca de 2.30. E mesmo assim a função parece ótima em toda verificação casual, porque as verificações casuais vivem no meio. NORM.S.INV(0.5) é zero, NORM.S.INV(0.975) é o 1.959964 de livro, e os dois passam pelo polinômio central que nunca chama logaritmo algum. O erro só aparece quando uma probabilidade cruza para uma cauda, digamos NORM.S.INV(0.001), que deve devolver -3.0902323. Qualquer função que dependa da normal inversa na cauda, incluindo os auxiliares de intervalo de confiança, herda a mesma distorção. A lição é banal e custosa: uma função com estrutura de ramos precisa de pontos de teste dentro de cada ramo, porque um caminho comum correto mascara com toda a vontade um ramo raro quebrado. O HotXLS toma o logaritmo natural nos dois ramos de cauda, então os valores de cauda batem com os do Excel
O sinal de x decide a cauda da distribuição t
A função acumulada t de Student carrega uma sutileza fácil de inverter. O valor dela vem da beta incompleta regularizada avaliada em df / (df + x²), mas esse valor da beta é a probabilidade na cauda além da magnitude de x, e não a probabilidade acumulada até x. A forma simétrica da distribuição t significa que a conversão depende do lado de zero em que x cai
// CDF t de Student. ib é a beta incompleta regularizada em df/(df+x*x),
// que mede a cauda simétrica. O valor acumulado depende do
// sinal de x; devolver ib sem conversão dá a cauda errada.
ib := BetaIF(df / 2, 0.5, df / (df + x * x));
if x > 0 then
  result := 1 - 0.5 * ib        // acima da média: um menos metade da cauda
else if x < 0 then
  result := 0.5 * ib            // abaixo da média: metade da cauda
else
  result := 0.5;                // exatamente na média
Para x acima de zero, a probabilidade acumulada é um menos metade da cauda simétrica; para x abaixo de zero, é metade dessa cauda; em zero, é exatamente um meio. Devolver o valor da beta diretamente é reportar o lado errado da distribuição, errando por todo o corpo da curva para qualquer x não nulo. As variantes de cauda direita e bicaudal se constroem no mesmo ramo, e é por isso que T.DIST.2T(1,1) volta como 0.5 e T.DIST(1,1,TRUE) como 0.75, e a inversa T.INV faz bisseção contra esta CDF para o caminho de ida e volta fechar
Nada disso é visível a partir da célula, e esse é o resultado pretendido. Você escreve uma fórmula e lê um número que bate com o Excel. Se você está estendendo o motor com lógica própria, a mecânica de registrar uma função está coberta em nosso passeio pelo motor de fórmulas e funções customizadas, e a forma como as fórmulas atravessam planilhas e intervalos nomeados está coberta em o artigo sobre nomes definidos e fórmulas entre planilhas. Tudo isso vem dentro do componente de planilhas HotXLS para Delphi e C++Builder, junto com as APIs de leitura, escrita, gráficos e formatação cobertas em outros artigos deste blog