Um loader em Delphi que analisa um pacote XLSX de oito planilhas em oito worker threads pode mostrar um gráfico de CPU que mal passa de um núcleo, e varrer a contagem de threads de dois a oito deixa o cronômetro quase onde estava. Com duas threads a carga pode até sair mais lenta do que um loop serial simples. O código de parsing não toma nenhum lock próprio e as planilhas não compartilham dados, então a espera acontece em um lugar que o código-fonte nunca menciona: dentro do memory manager, que cada uma dessas workers aciona para cada nome de elemento, valor de atributo e célula
A contagem de threads é o botão em que todo mundo pensa primeiro. Para código limitado por alocação, ela quase não muda nada. O que move a curva é o número de alocações de heap que cada célula custa
Como o HotXLS divide o Open em três fases
O HotXLS analisa as planilhas de um pacote XLSX com várias planilhas em worker threads por padrão. TXLSXWorkbook.ParallelParse começa em True, e ParallelParseThreads começa em 0, o que significa uma worker por processador lógico que o sistema operacional reportar, nunca mais workers do que planilhas a analisar. Só uma das três fases do Open roda nessas workers. A fase A é serial: ela lê o workbook part, as shared strings e os estilos, cria todas as planilhas com nome e visibilidade, e analisa o arquivo de relationships de cada planilha para que os alvos de hyperlinks e tabelas já estejam resolvidos. Quando uma worker começa, toda tabela de consulta de que ela precisa está completa e é somente leitura
A fase B entrega cada planilha a uma worker. As workers reivindicam índices de planilha de um contador compartilhado com um incremento interlocked, então uma pasta de trabalho com uma planilha grande e sete pequenas se equilibra sem um escalonador: quem termina uma planilha pequena simplesmente pega o próximo índice. O contêiner ZIP é a parte que não pode ser compartilhada de forma ingênua, porque um stream deflate carrega estado de um bloco para o outro e duas threads não podem avançar o mesmo descompressor. Cada worker portanto abre o seu próprio descompressor sobre a sua própria entrada de planilha e despeja o XML direto no seu próprio reader. O handle de arquivo é o único recurso compartilhado, e o lock em volta dele cobre um único seek-and-read de bytes compactados por vez. Descompressão e parsing rodam em paralelo, e o XML de nenhuma planilha fica inteiramente inflado na memória. Quando o parsing termina, a worker lê a sua entrada até o fim para que as checagens de tamanho e CRC do ZIP ainda rodem
A fase C volta a uma única thread para as partes que penduram em cada planilha: comentários e threaded comments, drawings e charts, tabelas e configurações de impressora. Na maioria das pastas de trabalho isso é pequeno perto do XML de células
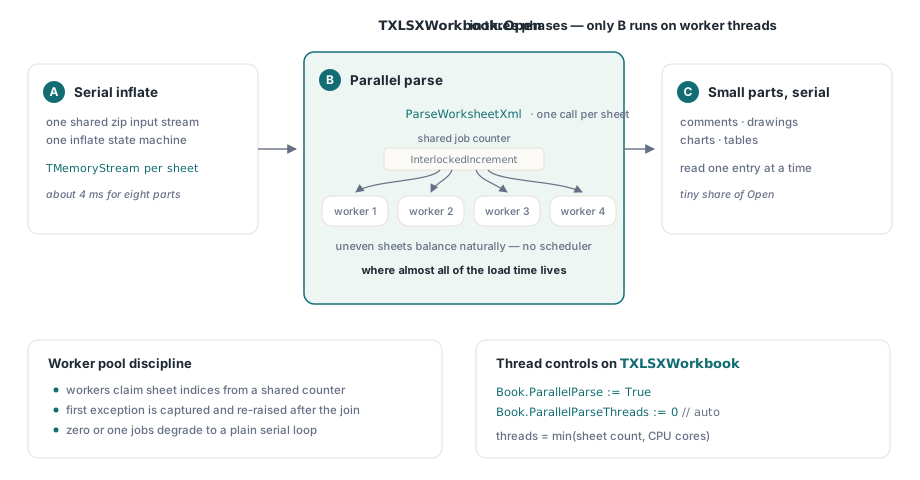
Os erros voltam na thread chamadora. Quando uma planilha levanta exceção durante o parsing, o pool para de distribuir índices novos, espera as workers que ainda estão rodando e então relança a partir do Open a exceção da planilha de menor número que falhou, para que o relato siga a ordem das planilhas e quem chamou nunca precise lidar com uma exceção escapando de uma worker thread. Com RecoveryMode em True, a planilha que falha no parsing é simplesmente pulada, um aviso cai em Diagnostics e as planilhas restantes carregam normalmente. Definir ParallelParse como False roda o mesmo parser sobre as planilhas uma a uma e produz resultados idênticos
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    // Os dois valores são os padrões; escrevê-los explícitos mantém a
    // escolha visível na revisão de código
    Book.ParallelParse := True;
    Book.ParallelParseThreads := 0;  // 0 = uma worker por CPU lógico, limitado ao número de planilhas
    Book.RecoveryMode := False;      // planilha que falha no parsing levanta exceção no Open
    if Book.Open('quarterly-ledger.xlsx') <> 1 then
      raise Exception.Create('open failed');
    // todas as planilhas estão totalmente carregadas aqui; leia células como de costume
  finally
    Book.Free;
  end;
end;
Por que threads extras deixam um parser denso em alocações mais lento?
O parsing de planilhas é feito em grande parte de alocações pequenas, e o memory manager padrão do Delphi faz as threads revezarem nelas. Um leitor de XML ingênuo produz uma string para cada nome de elemento, outra para cada nome e valor de atributo, um Variant para a célula e uma string para o texto dela. O memory manager padrão guarda blocos pequenos em pools agrupados por tamanho e protege cada pool com um lock. Uma thread que encontra o lock ocupado recua e dorme antes de tentar de novo. Quando oito workers pedem ao mesmo tempo o mesmo punhado de tamanhos minúsculos, elas ficam colidindo nos mesmos pools, e threads que pareciam independentes no código acabam rodando uma depois da outra
Isso explica os dois sintomas da abertura. O tempo de CPU fica perto do tempo de relógio porque thread dormindo não queima CPU, e o varredura de threads fica plana porque são os locks dos pools, não os núcleos, que ditam o ritmo. Duas threads podem perder feio para uma: cada alocação agora paga a ida e volta de um lock entre núcleos, enquanto o loop serial nunca contende
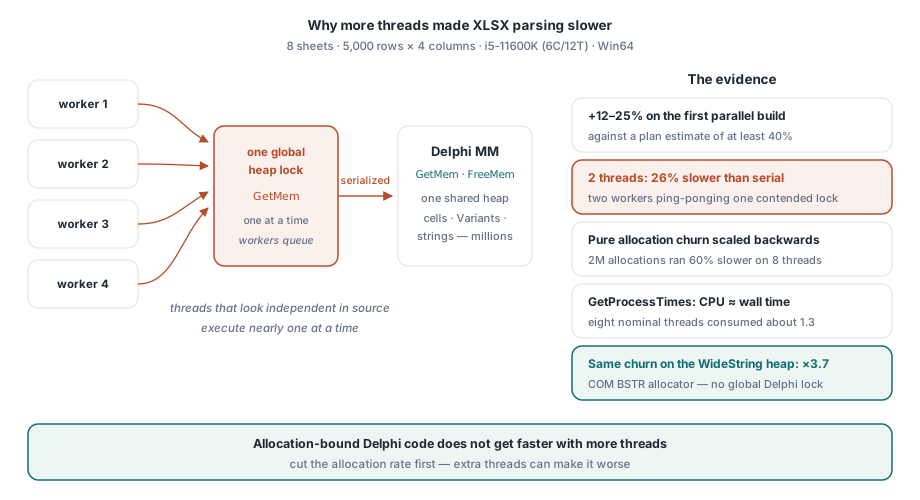
Um tipo de string fica fora disso no Windows. A WideString é uma COM BSTR, alocada pelo alocador de strings OLE do sistema em vez do memory manager do Delphi, então o tráfego de WideString nunca entra na fila dos pools do Delphi. O HotXLS guarda o texto de células como WideString, o que importa mais para o carregamento paralelo do que nunca importou para o caminho serial
Medindo a contenção nas suas próprias pastas de trabalho
Dois números dizem se uma carga é limitada por alocação: como o tempo de relógio muda quando a contagem de workers sobe, e quanto de CPU o processo consumiu no mesmo intervalo. Se o tempo de CPU dividido pelo tempo de relógio fica perto de 1.0 com oito workers nominalmente ocupadas, elas estão na fila em vez de analisar. A varredura abaixo abre o mesmo arquivo com uma a oito workers e imprime os dois números. É um harness de medição para o seu próprio projeto de teste; só os membros de TXLSXWorkbook vêm do HotXLS
uses
  Winapi.Windows, System.SysUtils, System.Math, System.Diagnostics;

// Seu próprio helper: tempo de CPU de usuário + kernel deste processo, em milissegundos
function ProcessCpuMs: Int64;
var
  Created, Exited, Kernel, User: TFileTime;
begin
  GetProcessTimes(GetCurrentProcess, Created, Exited, Kernel, User);
  Result := (Int64(Kernel) + Int64(User)) div 10000;  // ticks de 100 ns para ms
end;

procedure SweepThreads(const FileName: string);
var
  N: Integer;
  Book: TXLSXWorkbook;
  SW: TStopwatch;
  Cpu0, Cpu: Int64;
begin
  for N := 1 to 8 do
  begin
    Book := TXLSXWorkbook.Create;
    try
      Book.ParallelParseThreads := N;  // 1 roda o loop serial simples
      Cpu0 := ProcessCpuMs;
      SW := TStopwatch.StartNew;
      if Book.Open(FileName) <> 1 then
        raise Exception.CreateFmt('open failed: %s', [FileName]);
      SW.Stop;
      Cpu := ProcessCpuMs - Cpu0;
      Writeln(Format('%d workers: %d ms wall, CPU/wall %.2f',
        [N, SW.ElapsedMilliseconds, Cpu / Max(Int64(1), SW.ElapsedMilliseconds)]));
    finally
      Book.Free;
    end;
  end;
end;
Rode a varredura várias vezes e guarde a melhor marca de cada contagem de workers, porque a primeira rodada também paga um cache de disco frio. Uma curva de tempo de relógio plana com CPU/wall perto de 1 significa que o memory manager é o teto. Se o tempo de relógio segue caindo enquanto o CPU/wall sobe em direção à contagem de workers, o arquivo é limitado pelo parsing e as workers extras estão justificadas
Uma curva plana leva à próxima pergunta: quais alocações são as culpadas? Um wrapper de memory manager que conta chamadas por tamanho responde isso em poucos minutos, sem profiler. A versão abaixo só conta o GetMem e deixa FreeMem e ReallocMem apontando para o manager original, o que basta para ver de onde vem o tráfego
// Diagnóstico que você adiciona ao seu próprio harness de teste; não faz parte do HotXLS
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);  // o churn de blocos pequenos que vale vigiar
  Result := OldMM.GetMem(Size);
end;

procedure InstallCounter;
begin
  GetMemoryManager(OldMM);
  NewMM := OldMM;
  NewMM.GetMem := CountingGetMem;
  SetMemoryManager(NewMM);
end;

procedure RemoveCounter;
begin
  SetMemoryManager(OldMM);
end;
Instale o contador logo antes do Open, remova-o logo depois e divida o AllocCount pelo número de células do arquivo. Esse número por célula é o que se acompanha de build para build, e a fatia de blocos de 32 bytes ou menos mostra se strings curtas dominam. Confira antes de escrever um pool de objetos de célula: cada objeto de célula é uma alocação, e as strings de vida curta criadas enquanto a célula é analisada podem ultrapassá-lo várias vezes
Onde as alocações se escondem no XML de planilha
Uma célula como <c r="B7" s="3" t="s"><v>42</v></c> parece minúscula no disco. Um leitor direto ainda a transforma em uma sequência de strings novas: os nomes de elemento c e v, três nomes de atributo, três valores de atributo e o conteúdo de texto. Converter cada token UTF-8 pela RTL adiciona um UnicodeString intermediário antes de a WideString final existir. Nenhuma dessas strings sobrevive à célula, e cada uma delas é uma viagem pelo memory manager
O leitor de XML do HotXLS ataca as duas maiores fontes. Os nomes de elemento no XML de planilha vêm de um vocabulário muito pequeno (row, c, v, f, is), então o leitor mantém um cache curto dos nomes que já viu, compara os bytes brutos de cada nome novo contra esse cache e devolve a string em cache em caso de match. As cópias em cache são deliberadamente AnsiString. AnsiString tem contagem de referências, então entregar uma instância em cache custa um incremento de contador e nenhuma alocação. Um cache de nomes em WideString não compraria nada: WideString não tem contagem de referências, e toda atribuição faz uma nova alocação no sistema
Nomes de atributo, valores de atributo e texto de célula seguem o outro caminho. O leitor decodifica UTF-8 direto do buffer de varredura em duas passadas: a primeira conta unidades de código UTF-16, a segunda preenche uma WideString alocada uma única vez com exatamente aquele comprimento. É uma alocação por token, e ela cai no alocador de strings do sistema em vez dos pools do Delphi. Referências de caractere como A e as entidades predefinidas são resolvidas pelo scanner antes de a decodificação começar, então o decodificador só vê UTF-8 simples. Para sequências de bytes que não são UTF-8 válido, o decodificador copia os bytes problemáticos um a um, onde a conversão da RTL descartaria ou substituiria, então um arquivo danificado ainda produz ASCII legível em volta do ponto ruim. Entrada válida decodifica para o mesmo texto dos dois jeitos
As duas manobras se transferem para o seu próprio código de parsing em Delphi. Cachear strings só economiza alocações quando o tipo de string tem contagem de referências, e decodificar direto para o tipo de destino elimina a temporária que as funções de conversão convenientes da RTL criam a cada chamada
Quais pastas de trabalho ganham, e quais configurações escolher
O parsing paralelo funciona na granularidade de planilha, então o formato da pasta de trabalho decide a maior parte do resultado. Várias planilhas de tamanho comparável são o melhor caso, inclusive os arquivos que você obtém ao duplicar uma planilha modelo por região ou por mês. Uma pasta de trabalho que é uma planilha gigante única analisa em uma worker, diga o que disser a ParallelParseThreads; para esse formato o streaming direct reader encaixa melhor, porque nunca constrói a pasta de trabalho inteira na memória. O tempo gasto com comentários, charts e drawings fica na fase C serial. Um arquivo com zero ou uma planilha a analisar pula o pool e roda o loop serial simples
Quando só algumas planilhas interessam, liste os nomes delas em SelectedSheets antes de chamar o Open. As outras planilhas ainda são criadas com nome e visibilidade, mas sem células, as workers passam por elas, e a LoadSheet preenche uma delas depois, se o usuário abrir
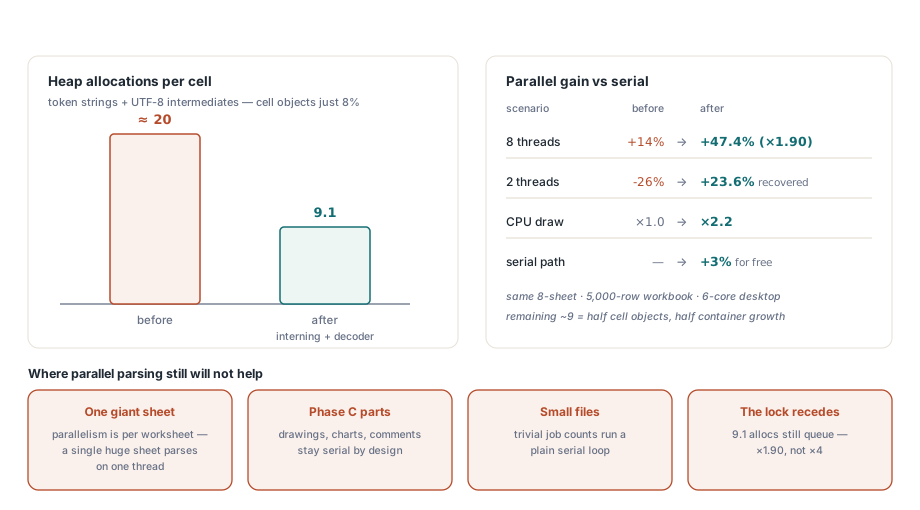
Deixe o ParallelParse ligado em ferramentas de desktop e jobs em lote que abrem uma pasta de trabalho por vez. Esse padrão é o mais seguro: os resultados batem com o caminho serial, e uma propriedade desliga tudo se uma pergunta sobre threading surgir. Um servidor que já abre várias pastas de trabalho concorrentemente é outro caso. Toda thread de requisição também está alocando, então cada worker de parsing extra adiciona mais um contender para os mesmos pools do memory manager; defina ParallelParseThreads como 2 ali, e suba só depois de a varredura acima, rodada naquele servidor sob a carga normal dele, mostrar as workers extras se pagando. Menos alocações por célula sobem o teto sem removê-lo. Objetos de célula e o crescimento dos contêineres ainda passam pelos pools do Delphi, e é por isso que o ganho de oito workers fica bem abaixo de oito vezes. Para o resto do toolkit de load e save, da reutilização de estilos a callbacks de linhas em massa, veja o guia de desempenho com pastas de trabalho grandes no Delphi
O pool de workers, as chaves ParallelParse e ParallelParseThreads e o leitor de XML enxuto em alocações vêm todos no HotXLS Delphi Excel Component, que lê e escreve XLS, XLSX e ODS diretamente de código Delphi e C++Builder sem Excel instalado na máquina