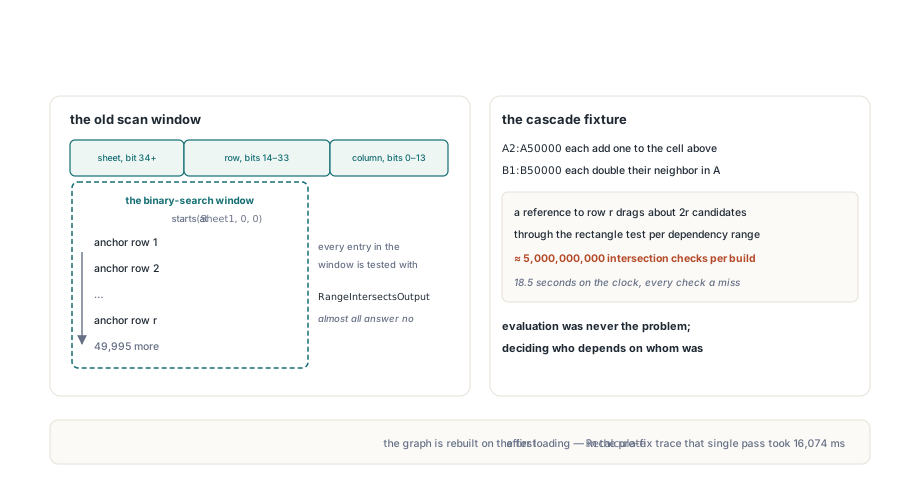
Uma planilha com 50.000 fórmulas na coluna A, cada uma somando um à célula de cima, e outras 50.000 na coluna B dobrando a vizinha é praticamente o modelo de planilha mais simples que existe. Avaliá-lo custa 100.000 somas e multiplicações. Descobrir a ordem de avaliação custa muito mais se o construtor de arestas for escrito do jeito óbvio: buscar toda fórmula do topo da planilha referenciada até a linha referenciada, testar cada uma por sobreposição e guardar os acertos. Para esta única planilha isso dá cerca de cinco bilhões de testes de retângulo, e quase todos respondem não
Os cinco bilhões são aritmética, não leitura de cronômetro. Uma referência à linha r arrasta cerca de 2r candidatos para a janela de busca, um por coluna para cada linha acima dela, e somar isso sobre 100.000 referências chega aos bilhões. A parte interessante é que a janela realmente precisa começar no topo da planilha, por um motivo que não tem nada a ver com preguiça
Onde uma reconstrução de dependências gasta o tempo
O motor de recálculo do HotXLS reconstrói o grafo de dependências de fórmulas sempre que a topologia delas muda: o primeiro Recalculate depois que uma pasta de trabalho é carregada ou gerada, e o primeiro depois de fórmulas reescritas, planilhas adicionadas ou removidas, ou um bloco de células clonado. As duas classes de pasta de trabalho, TXLSWorkbook e TXLSXWorkbook, montam um TXLSDepGraph da unit lxDepGraph para isso. Cada célula de fórmula vira um nó com uma âncora (Row, Col) e um retângulo de saída que vai até (OutRow2, OutCol2). Para uma fórmula comum, o retângulo é a própria célula âncora
Os nós são ordenados por uma chave de 64 bits empacotada de XLSDepMakeKey: a coluna fica nos bits 0–13, a linha nos bits 14–33, e o índice de planilha do bit 34 para cima. Ordenar por essa chave dá ordem planilha-maior, linha-maior, então achar a última fórmula que poderia importar para uma referência é uma única busca binária em (Sheet2, Row2, 16383). A primeira é o problema. O limite inferior precisa ser (Sheet1, 0, 0), o topo da planilha referenciada, e tudo entre os dois limites vira candidato
Por que a busca não pode começar na linha referenciada?
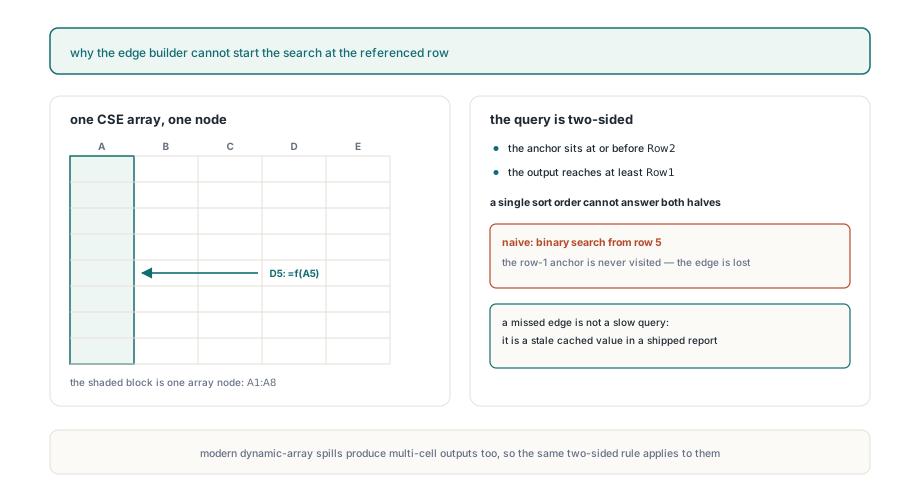
Uma fórmula de matriz ancorada acima de um intervalo pode ser dona de células dentro dele. Em uma TXLSXWorkbook, uma matriz CSE digitada em A1:A8 é um único nó cuja âncora é A1 e cuja saída alcança a linha 8, como descreve o artigo sobre recálculo incremental e o grafo de dependências. Uma fórmula em D5 que lê apenas A5 ainda precisa de uma aresta desse nó. Comece a busca binária na linha 5 e a âncora na linha 1 nunca é visitada, a aresta nunca é registrada, e a D5 pode ser avaliada antes da matriz de que depende. O sintoma é um valor em cache obsoleto na pasta de trabalho salva, o que é muito mais difícil de notar do que um recálculo lento
A consulta real, portanto, tem dois lados. Um nó é candidato quando a sua âncora está em ou antes de Row2 e a sua saída alcança pelo menos Row1, numa planilha dentro da referência e com colunas sobrepostas. Uma ordenação por âncora responde à primeira metade. Nada na ordem de âncora diz algo sobre a segunda metade, porque uma fórmula na linha 3 pode emitir uma célula ou mil linhas. Tabelas de dados what-if têm a mesma forma: a TXLSXWorkbook registra cada tabela de dados como um nó cobrindo toda a sua área de resultado. Fórmulas de matriz dinâmica seguem outro caminho e são marcadas como voláteis, então são recalculadas a cada passada; o artigo sobre fórmulas de matriz dinâmica e spill cobre como os intervalos derramados se comportam
A TXLSDepGraph é uma classe pública, então o caso é fácil de reproduzir sem uma pasta de trabalho. Os índices de planilha têm base 1 e linhas e colunas têm base 0, batendo com as coordenadas da calculadora. A sonda abaixo registra a raiz da matriz e a leitora, constrói as arestas e também roda uma cadeia de referências de ponto invertida pelo mesmo tipo de grafo, para mostrar o contador de que as próximas seções dependem
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // matriz CSE: âncora A1 (linha 0, col 0), saída até A8 (linha 7)
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5 (linha 4, col 3) lê apenas A5
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1, a raiz A1
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2: a raiz A1 e a própria D5
  finally
    G.Free;
  end;

  // cadeia A1..A100000, cada célula lendo a de cima, adicionada de baixo para cima
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
Podando subárvores pela sua maior linha de saída
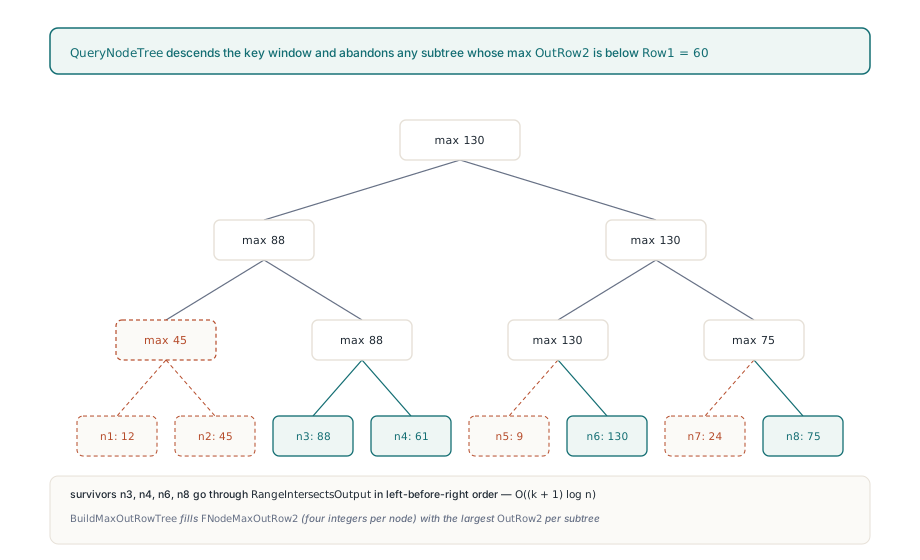
A TXLSDepGraph.BuildEdges mantém a ordenação por âncora para o limite superior e responde ao limite inferior com uma segment tree aumentada com máximo deitada sobre a ordem ordenada. Cada entrada da árvore guarda a maior OutRow2 de todos os nós abaixo dela. A consulta desce apenas dentro da janela de chaves e descarta qualquer subárvore cujo máximo armazenado esteja acima de Row1, porque nenhuma fórmula naquela subárvore alcança as linhas referenciadas. Os nós que sobrevivem ainda passam pelo teste de retângulo completo, então abrangência de planilha e colunas são checadas exatamente como antes
A técnica é pequena o suficiente para mostrar inteira. O esboço abaixo é uma versão mínima escrita para este artigo, com nomes próprios; nenhum deles é API do HotXLS, e os arrays ficam por conta de quem chama preencher a partir de uma lista de linhas de saída já ordenada pela chave de âncora
uses
  System.Math, System.Generics.Collections;

// Apenas esboço: uma segment tree aumentada com máximo sobre nós ordenados pela chave de âncora.
// OutRow2[i] é a última linha de saída do i-ésimo nó na ordem ordenada.
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// Coleta, da esquerda para a direita, todo nó em [Lo, Hi) cuja saída alcança Row1
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // fora da janela, ou nada alcança Row1
  if L = R then
  begin
    Hits.Add(L);                 // quem chama ainda roda o teste de retângulo completo
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // esquerda primeiro
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // mantém a ordem de varredura
end;

// Construa uma vez com BuildMax(Ix, 1, 0, Count - 1),
// depois, por referência, chame Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits)
Por referência, o trabalho cai do tamanho da janela para O((k + 1) log n), onde k é o número de nós cuja saída realmente alcança as linhas referenciadas. De volta ao modelo da abertura, uma referência de Br para Ar agora testa dois retângulos, Ar e a própria Br, e uma referência de Ar para a célula de cima testa os dois nós daquela linha. No dedo isso dá cerca de 200.000 testes para a construção completa, em vez de cinco bilhões
Mesmas arestas, na mesma ordem
A recursão esquerda-antes-de-direita importa mais do que parece. Os nós sobreviventes são visitados exatamente na ordem em que um loop simples sobre a janela os visitaria, então os arrays Dependents e Precedents de cada nó se preenchem na mesma sequência, e a ordem topológica construída a partir deles sai igual a cada execução. Essa ordem não é só contabilidade interna: quando o grafo está atualizado, o escritor XLSX emite o xl/calcChain.xml na ordem em que o FullTopoOrder devolve, então uma ordem de visita não determinística apareceria como diffs ruidosos entre dois saves de uma pasta de trabalho intocada
Os tipos de aresta também mantêm as suas regras. Referências que ficam no argumento de matriz de busca de VLOOKUP, MATCH, XLOOKUP e funções parecidas produzem arestas de lookup-scan, que propagam sujeira mas ficam de fora da detecção de ciclos. Quando um nó tem uma referência dura e uma referência de lookup para o mesmo precedente, uma aresta dura registrada primeiro suprime a aresta de scan posterior, e uma aresta de scan registrada primeiro mantém o seu slot enquanto a aresta dura ainda é adicionada. Essa ordenação é o que impede intervalos de lookup de produzirem referências circulares falsas, e ela só vale se a caminhada podada visita os candidatos em ordem de varredura
A propriedade EdgeCandidateChecks torna a poda observável. Ela conta os retângulos de saída que a chamada mais recente de BuildEdges realmente testou e zera no início de cada construção. Na sonda acima, a cadeia invertida reporta 99.999, um teste por referência, mesmo com os nós adicionados de baixo para cima e a ordenação tendo de reordenar todos. O AddNode marca tanto a ordenação quanto as arestas como obsoletas, então o próximo BuildEdges ou NodeIndexOf reconstrói o índice em vez de remendá-lo
Onde fica o custo restante
A árvore poda apenas por linhas, e essa escolha molda o que um modelo grande ainda paga
- Erros de coluna ainda são pagos nas folhas: as 2.626 fórmulas que preenchem
A100:Z200todas alcançam a linha 100, então uma referência aAA100:AA200testa cada uma antes de rejeitá-la por coluna - Referências de coluna inteira e outras referências largas genuinamente têm muitos precedentes; o índice remove checagens desperdiçadas, e construir as arestas reais continua proporcional a quantas elas sejam
- Uma referência que atravessa várias planilhas abre uma janela cobrindo a primeira planilha inteira, então fórmulas ali com saídas profundas chegam ao teste de folha; as arestas saem iguais e só a poda fica mais fraca
- A árvore leva quatro inteiros por nó, cerca de 1,6 MB para 100.000 fórmulas, e qualquer mudança de topologia paga uma re-ordenação O(n log n) completa mais uma construção de árvore O(n) na próxima construção de arestas
Linhas são a dimensão única certa para indexar. Relatórios gerados, livros contábeis e modelos financeiros crescem para baixo, então a distância em linhas é de onde vem quase todo candidato desperdiçado, enquanto um erro de coluna é rejeitado pelo teste de retângulo em um punhado de comparações de inteiros. Uma segunda dimensão na árvore complicaria toda consulta para economizar testes que já são baratos
Do lado de quem chama, o passo caro é a reconstrução, e edições de valor não a disparam. O Recalculate constrói o grafo na primeira chamada; chamadas seguintes reavaliam apenas as fórmulas a jusante dos valores alterados, mais as voláteis. Escrever todas as fórmulas primeiro e recalcular uma vez é o padrão a buscar. O harness abaixo cronometra os dois tipos de passada no motor clássico, em que o Recalculate devolve o número de células de fórmula que não conseguiu avaliar; rode-o no hardware que vai hospedar o job em lote, porque os tempos absolutos dependem bastante da máquina
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // cadeia de 49.999 elos na coluna A
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // 50.000 dependentes na coluna B
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // constrói o grafo, avalia tudo
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // edição de valor: o grafo é reutilizado
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // só o subgrafo sujo
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
Neste modelo, a passada de valores ainda reavalia as 99.999 fórmulas, já que a coluna A inteira pende de A1; o que ela pula é a construção do grafo. Sobrescrever uma célula de fórmula com um valor simples é outra história, porque isso muda a topologia e o próximo Recalculate reconstrói o grafo do zero
A mesma forma quadrática em nomes definidos clonados
As faixas de relatório escondem o mesmo padrão em outro lugar. A TXLSXWorksheet.CloneRangeTo copia nomes definidos que apontam diretamente para um intervalo dentro do bloco clonado, e cada cópia precisa de um nome único no seu escopo: Total_2, Total_3 e assim por diante. Uma busca que recomeça em _2 a cada cópia investiga um candidato a mais a cada vez, então uma planilha construída a partir de centenas de faixas clonadas gasta um número quadrático de consultas de nome só com a nomeação
A TXLSXDefinedNames evita isso com uma dica de sufixo guardada no índice de nomes, uma por nome base e escopo. A próxima busca parte do sufixo devolvido da última vez e reconfere-o primeiro, porque quem chama pode não adicionar aquele nome. Apagar um nome, renomeá-lo via Name, movê-lo com SheetIndex ou limpar a coleção derruba o índice junto com todas as dicas, então o próximo clone volta ao primeiro sufixo livre e preenche qualquer buraco que a mudança abriu
Para aplicações Delphi e C++Builder que geram ou recalculam planilhas grandes, o componente Excel HotXLS para Delphi e C++Builder usa esse grafo de dependências indexado no motor de recálculo das suas classes de pasta de trabalho clássica e XLSX