Quando um PDF não embute uma fonte, o componente HotPDF renderiza esse texto com uma fonte do Windows instalada escolhida pelo HPDFMapBaseFontToSystem: ele decodifica o nome de /BaseFont, corta a parte de estilo, tenta várias grafias até o GDI confirmar que a família está instalada, mede larguras ausentes do standard 14 em fontes metricamente compatíveis, e converte códigos de um byte para Unicode antes de desenhar. Cada um desses passos existe porque a versão ingênua falhava em arquivos reais. O page renderer RenderLoadedPageToBitmap lida bem com programas embutidos; esta é a história das fontes que não estão no arquivo de forma nenhuma
Por que o GDI desenha silenciosamente o typeface errado para uma fonte não embutida?
O GDI nunca reporta fonte ausente: entregue ao CreateFontIndirect um nome de face que ele não conhece e ele silenciosamente seleciona um substituto, frequentemente uma serifa diferente sem peso bold. O renderer antigo passava o nome do PDF quase verbatim, então TimesNewRoman,Bold, TimesNewRomanPS-BoldMT e SegoeUI-Semibold não casavam com nada e saíam em qualquer coisa que o GDI escolhesse. Nomes podem ser piores que isso. A ISO 32000-1 §7.3.5 deixa um nome gravar qualquer byte como #xx, e produtores CJK rotineiramente soletram nomes de fonte como UTF-8 escapado ou bytes de code page legado; antes da v2.766.69 os escapes em si viravam o nome de face. O HPDFMapBaseFontToSystem agora decodifica os escapes primeiro, retorna uma sequência de bytes UTF-8 válida como os caracteres dele, e lê quaisquer outros bytes altos no code page do sistema
Cortar o estilo é onde as heurísticas mordem. Uma vírgula sempre encerra a família (Arial,Bold dá Arial), mas um hífen só encerra quando a palavra depois dele é um estilo: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra ou Condensed. Essa regra mantém o MS-Mincho inteiro enquanto transforma Calibri-Light em Calibri. O HotPDF então tenta grafias da família, seguidas de grafias da família com um sufixo PSMT, MT ou PS removido. Desde a v2.768.18 essas grafias cobrem toda escolha de espaços nos lugares onde uma palavra pode começar: antes de uma maiúscula que segue uma minúscula (MyriadPro vira Myriad Pro), na última maiúscula de um run que uma minúscula segue (UIGothic), e depois de um MS inicial (MSPGothic), da forma totalmente espaçada até o nome como escrito; passados quatro desses lugares só a forma totalmente espaçada e o nome unido são tentados. Espaçamento não pode ser aplicado às cegas, porque o Windows mantém algumas palavras unidas: SimSun está instalado exatamente com essa grafia, enquanto MicrosoftYaHei, MicrosoftJhengHei e MSPGothic pertencem a Microsoft YaHei, Microsoft JhengHei e MS PGothic. Antes da v2.768.18 o mapper punha um espaço antes de toda maiúscula interna, então MicrosoftYaHei era buscado como Microsoft Ya Hei e nunca encontrado. Um candidato conta como instalado quando CreateFontIndirect seguido de GetTextFace retorna o nome que foi pedido ou, desde a v2.768.18, quando a tabela de name da fonte selecionada o lista como família, nome de família completo ou tipográfico em qualquer língua; a resposta é cacheada por nome, então documentos com muitas fontes não instaladas não mais sondam o Windows por cada nome em toda página
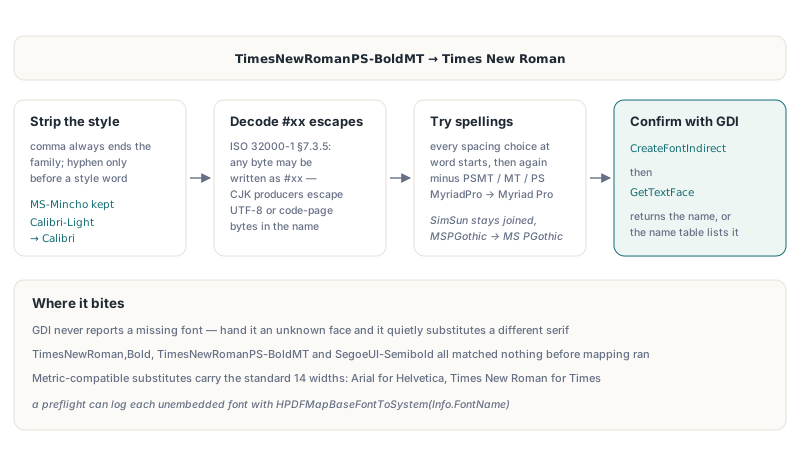
Como a função de mapeamento é pública na unit HPDFRenderFontMetrics, um relatório de preflight pode mostrar com qual família instalada cada fonte não embutida vai renderizar, usando a enumeração de fontes que o THotPDF já expõe para documentos carregados:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
Como o HotPDF mede fontes do standard 14 que não têm /Widths?
O HotPDF mede os advances ausentes na fonte instalada com as mesmas métricas, porque a ISO 32000-1 §9.6.2.2 permite às fontes do standard 14 omitir /Widths e a biblioteca não traz tabelas AFM. Arial carrega métricas de Helvetica, Times New Roman carrega Times e Courier New carrega Courier, então o HPDFMeasureBaseFontWidths cria a face correspondente em lfHeight = -1000 e chama GetCharWidth32W; nessa altura o resultado já está nas unidades de 1/1000 em que as larguras de PDF usam. O renderer primeiro transforma cada código em Unicode por /Encoding, /BaseEncoding e /Differences, com default StandardEncoding. Export SVG e extração de texto topam uma armadilha a mais: uma fonte Type 1 standard sem /Encoding nenhum produzia um decoder sem informação de encoding, o export SVG nunca o registrava, e toda largura medida ficava sem uso. Fornecer a StandardEncoding implícita consertou, desde que marcada como encoding predefinido; roteá-la pelo caminho de nome de CMap decodifica todo código como 0 e toda largura segue o erro
Bold, itálico e um off-by-one nas flags do font descriptor
A entrada /Flags de um font descriptor numera os bits dela a partir de 1, não de 0, então ForceBold é o bit 19 ($40000) e Italic é o bit 7 ($40), pela ISO 32000-1 Tabela 123. O código antigo testava $20000, que é o bit 18, SmallCap. O erro sobreviveu da v2.345.0 à v2.766.53 porque o /FontDescriptor quase sempre é uma referência indireta e o construtor de fontes só lia objetos diretos, então o ramo de flags inteiro nunca rodava, e a mesma cegueira ignorava /Widths 12 0 R e compunha texto num advance de fallback de 500 unidades. Quando a v2.766.53 começou a resolver referências indiretas pelo renderer, o bit precisou ser corrigido na mesma mudança, senão toda face de small caps de repente teria renderizado bold:
const
  // A ISO 32000-1 Tabela 123 conta posições de bit a partir de 1
  FD_ITALIC     = $00040;  // bit 7
  FD_SMALLCAP   = $20000;  // bit 18, não é peso
  FD_FORCEBOLD  = $40000;  // bit 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;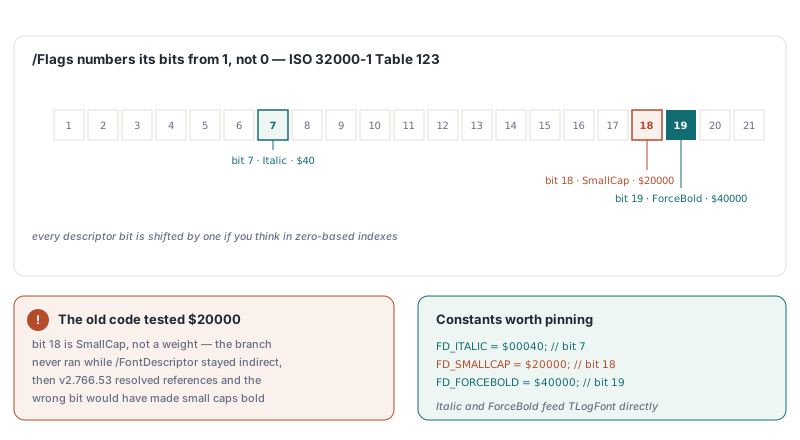
Por que fontes CJK com um CMap UCS2 recebem as larguras erradas?
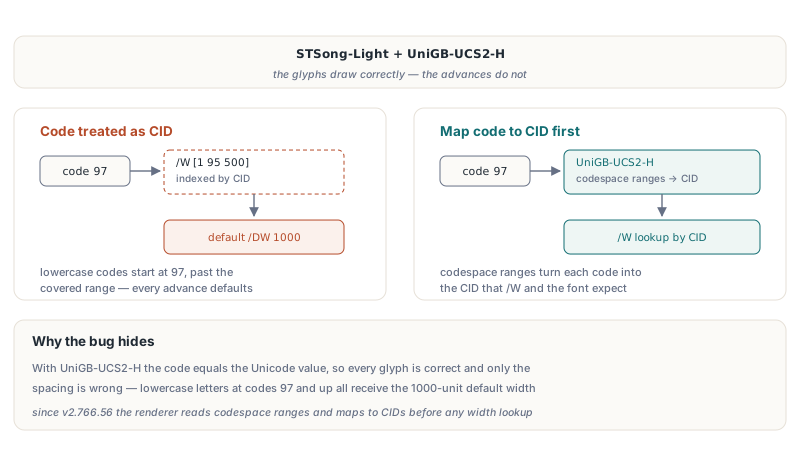
Texto CJK com um CMap UCS2 predefinido desenha os glyphs certos mas o espaçamento errado quando um renderer trata o código como o CID, porque o /W é indexado por CID, não por código de caractere. Com STSong-Light e UniGB-UCS2-H, o código por acaso iguala o valor Unicode, então o GDI desenha os caracteres corretos e o bug se esconde nos advances: letras minúsculas chegam como códigos 97 e acima, caem fora de uma entrada de /W como [1 95 500], e todas recebem a largura default /DW de 1000. Desde a v2.766.56 o renderer do HotPDF lê códigos pelas faixas de codespace do CMap (ISO 32000-1 §9.7.6.2) e os mapeia para CIDs antes de buscar larguras. Só as tabelas UCS2 e UTF16 embutidas e streams de CMap embutidos são usadas; uma aproximação de identidade para algo como GBK-EUC-H apenas pareceria suportada enquanto produzisse saída errada, então o renderer não finge
Por que caracteres acentuados viram pontos de interrogação no Windows chinês?
Códigos de um byte jamais devem chegar às funções ANSI ("A") do GDI, porque GetGlyphOutlineA e GetGlyphIndicesA interpretam bytes no code page do sistema enquanto o TextOutA usa o character set da fonte selecionada. Num sistema chinês, o byte $A9 do Arial (o símbolo de copyright no Windows-1252) virava um lead byte GBK e renderizava como "?", uma armadilha na qual o caminho de outline sem hinting acrescentado na v2.766.83 caiu de cara. A v2.767.3 pergunta à fonte realizada qual o character set dela com GetTextCharset, converte isso para um code page por TranslateCharsetInfo, passa o byte pelo MultiByteToWideChar e chama as funções W; fontes de símbolos usam U+F000 mais o código em vez disso. Encodings que discordam do Windows-1252 — /Differences, StandardEncoding, MacRomanEncoding — são mapeados para Unicode antes de qualquer fonte do sistema vê-los
Quais são os limites de desenhar com fontes do sistema?
Renderização com fontes do sistema é uma aproximação, e o componente HotPDF é honesto sobre onde para. Antes da v2.768.18 a checagem de instalação comparava só o nome que o GetTextFace retorna, e num Windows localizado essa função reporta o nome de família na língua do sistema, então Microsoft YaHei no Windows chinês ou Yu Mincho no Windows japonês era julgado ausente e desenhado num substituto do GDI; desde a v2.768.18 uma face que volta com outro nome também é buscada na tabela de name da fonte, e tais fontes são encontradas. Compatibilidade métrica é garantida só para as famílias Helvetica, Times e Courier; Symbol mapeia para Symbol e ZapfDingbats para Wingdings, que é um paliativo em vez de um match. O preflight acima também vê só fontes no dicionário de /Resources de cada página, não as referenciadas de dentro de form XObjects. Quando um código ainda não pode ser desenhado, o rastreamento de glyphs não resolvidos na hora do desenho o reporta, que é um sinal melhor do que ficar olhando thumbnails
O fix duradouro fica no lado de autoria. O próprio HotPDF grava com FontEmbedding definido como True por default, substituindo um Arial embutido mesmo quando o código chama SetFont com Helvetica, e texto embutido passa pelo renderer de glyphs de fonte embutida em vez de qualquer um dos chutes acima. Uma guarda barata para arquivos que chegam é avisar antes de renderizar quando uma família mapeada não está na lista de fontes de tela:
// VCL: Screen.Fonts lista nomes de família instalados (unit Forms)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
Para o componente completo, incluindo renderização de páginas, extração de texto e font subsetting no lado da escrita, veja a página de produto do HotPDF Delphi PDF component