Um codificador Reed-Solomon que guarda o termo constante do polinômio gerador primeiro e depois divide pelo termo líder primeiro não está calculando correção de erro nenhuma. A HotPDF embarcou exatamente isso em quatro codificadores de código de barras 2D, QR, Data Matrix, PDF417 e Aztec, e todo símbolo que eles produziam carregava um bloco de verificação que nenhum scanner conforme conseguiria usar
A parte interessante não é o deslize aritmético. É a propagação. Um codificador foi escrito primeiro, o loop de divisão dele foi copiado para os outros três, e cada formato novo herdou um defeito que nunca tinha sido validado contra um único vetor de teste publicado. Os símbolos continuavam renderizando, os finder patterns ficavam no lugar certo, os tamanhos estavam corretos. Só os bytes que permitem a um código de barras 2D sobreviver a uma mancha eram lixo
Um polinômio invertido, copiado para quatro codificadores
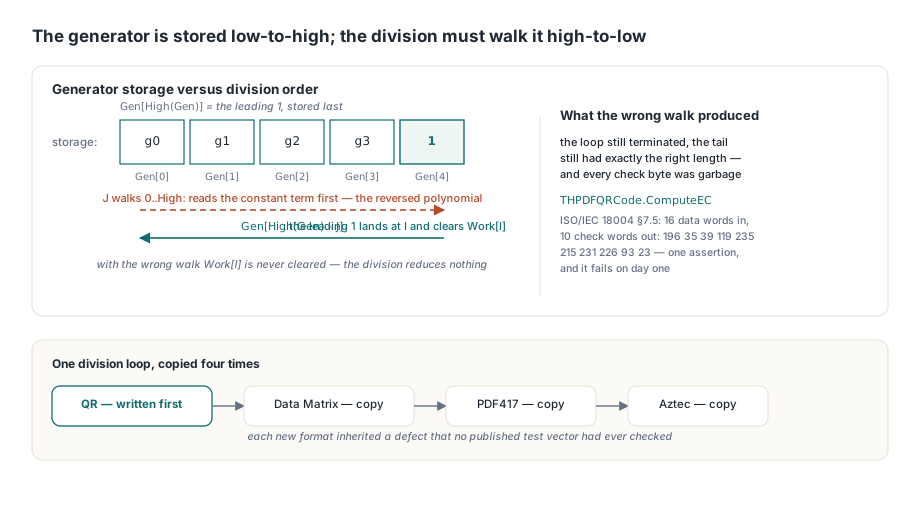
A causa raiz é um descompasso de ordem de armazenamento dentro do loop de divisão sintética. Os quatro codificadores da HotPDF constroem o polinômio gerador com coeficientes do baixo para o alto, então Gen[0] guarda o termo constante e Gen[High(Gen)] guarda o coeficiente líder mônico. O loop de divisão indexava Gen[J] para frente enquanto percorria a mensagem, o que é aritmeticamente idêntico a dividir pelo polinômio invertido. Havia uma segunda consequência que escondia a primeira: como o coeficiente líder nunca caía na posição I, Work[I] nunca era limpo, então a divisão nunca reduzia nada de fato. O loop ainda terminava e ainda preenchia o rabo com um array do tamanho exatamente certo
// THPDFQRCode.ComputeEC em HPDFQRCode.pas
Gen := GeneratorPoly(ECCount);            // Gen[0] é o termo constante
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] é o 1 líder que limpa Work[I]; percorrer Gen
  // para frente divide pelo polinômio invertido no lugar
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
A correção é a única expressão de índice Gen[High(Gen) - J]. Depois dela, THPDFQRCode.ComputeEC reproduz o exemplo resolvido da ISO/IEC 18004 §7.5: o bloco modo byte 1-M 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 produz as dez check words 196 35 39 119 235 215 231 226 93 23. Isso é uma asserção, e ela teria falhado no primeiro dia
Por que o símbolo Aztec também perdia o payload?
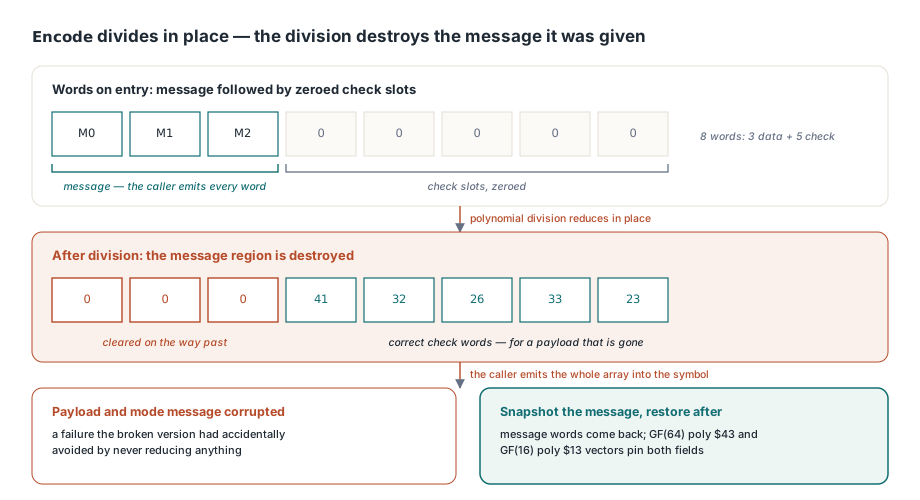
O Aztec carregava uma versão mais pesada do mesmo bug porque TAztecGF.Encode divide in place. A rotina recebe Words com a mensagem seguida de slots de check word zerados, e o chamador emite o array inteiro para o símbolo. A divisão polinomial destrói o dividendo enquanto o reduz, então quando o loop foi corrigido para reduzir de verdade, as palavras da mensagem foram sobrescritas pelo caminho. Payload e mode message saíam os dois corrompidos, uma falha que a versão quebrada tinha evitado por acidente ao nunca reduzir nada
// TAztecGF.Encode em HPDFAztec.pas
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// A divisão limpa a região da mensagem, mas o chamador emite o array
// inteiro para o símbolo, então as words de dados têm que voltar
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
O Aztec usa dois campos diferentes, e o fixture de regressão exercita os dois. Em GF(64), o campo de um símbolo de seis bits construído sobre o polinômio primitivo $43, as words 12 45 3 com cinco check words produzem 41 32 26 33 23 enquanto as três líderes ficam intocadas. Em GF(16), o campo da mode message com polinômio primitivo $13, as words 5 9 produzem 11 15 6 8. As duas passam pelo hook HPDFAztecTestEncode contra a ISO/IEC 24778
O que faz o Data Matrix precisar de duas correções em vez de uma?
THPDFDataMatrix.ComputeEC empilhava um segundo erro independente em cima do compartilhado: ele construía o polinômio gerador com raízes começando em α^0, enquanto o Anexo E da ISO/IEC 16022 especifica raízes a partir de α^1. Corrigir só o índice de divisão dá as check words 146 107 90 179 128 para o exemplo padrão, que parecem tão plausíveis quanto as corretas e continuam ilegíveis. Os dois defeitos tinham que sair antes de os números baterem
// THPDFDataMatrix.ComputeEC em HPDFDataMatrix.pas
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]: as raízes vão de alpha^1..alpha^ECCount, não de alpha^0
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;
O ponto de referência é pequeno o suficiente para caber num comentário. A string '123456' codifica para as code words ASCII 142 164 186, um símbolo 10x10 carrega cinco check words, e o bloco correto é 114 25 5 88 102. HPDFDataMatrixTestComputeEC expõe a função de classe atrás do gate {$IFDEF HPDF_TESTING}, então o fixture faz a asserção desses cinco valores sem instanciar um codificador nem renderizar uma página. O campo de Galois em si, construído por InitDMTables sobre o polinômio primitivo $12D nas tabelas DMExp e DMLog, esteve correto o tempo todo, que é exatamente por que o bug se escondeu tão bem
O PDF417 divide sobre um corpo primo, onde sinais importam
O PDF417 precisou de quatro mudanças em vez de uma, porque GF(929) é um corpo primo e não um corpo de extensão binária: adição não é xor, subtração não é adição, e o sinal de cada fator do gerador é aritmética real, não notação. Cada fator tem que ser (x - 3^i), o que em código significa multiplicar por 929 - GF929Pow(3, I); o passo de redução tem que subtrair; as raízes vão de 3^1 pela ISO/IEC 15438 §5.5; e Factor tem que ser travado numa variável local antes de o loop interno rodar, porque a passagem J = 0 escreve Work[I] e, do contrário, mudaria o multiplicador por baixo dele mesmo. HPDFPDF417TestComputeEC fixa o resultado corrigido: as code words 5 453 178 121 239 com quatro words de correção de erro dão 452 327 657 619
// THPDFPDF417.ComputeEC em HPDFPDF417.pas
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // o fator é (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // latch: J = 0 reescreve Work[I]
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
O finder do Data Matrix foi instalado de cabeça para baixo
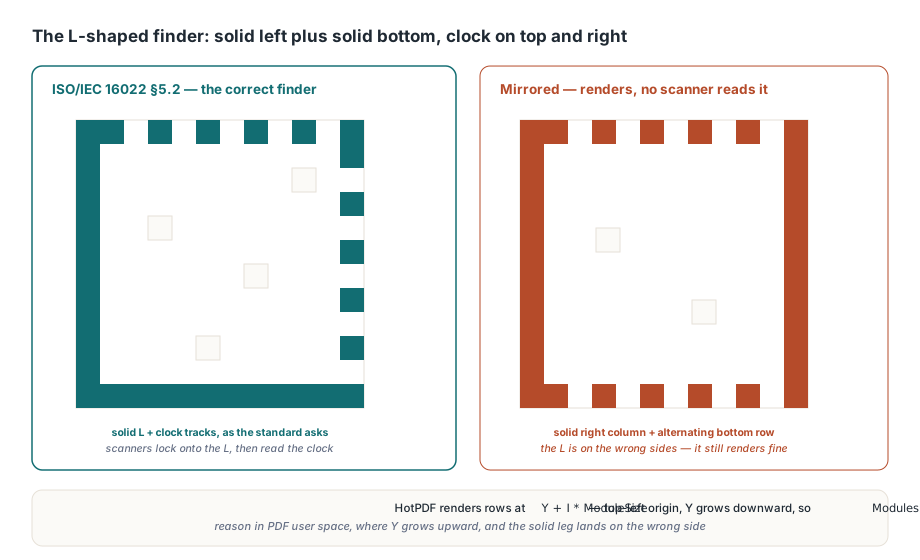
Check words corretas não salvam um símbolo cujo finder pattern está espelhado, e o mesmo release teve que corrigir isso também. O código de posicionamento desenhava uma coluna esquerda sólida, uma coluna direita sólida, e módulos alternados ao longo das linhas de cima e de baixo, enquanto a §5.2 da ISO/IEC 16022 pede uma coluna esquerda sólida mais uma linha de baixo sólida, o finder em forma de L, com a trilha de clock alternada correndo ao longo da linha de cima e da coluna da direita. O que torna fácil errar o lado é a convenção de coordenadas: a HotPDF renderiza linhas de módulos em Y + I * ModuleSize, que é semântica de origem no canto superior esquerdo, então Modules[Size - 1, *] é a linha de baixo do símbolo impresso. Quem raciocina no user space do PDF, onde Y cresce para cima, coloca a perna sólida no lado errado e não vê nada de suspeito na tela
Por que quatro codificadores quebrados passaram nos testes durante anos?
Porque os testes faziam asserção de estrutura e os defeitos estavam na aritmética. Os casos existentes de QR, Data Matrix e Aztec checavam módulos do finder, timing patterns e dimensões do símbolo, tudo genuinamente correto; nenhum teste nunca comparou uma check word contra um vetor publicado. A segunda razão generaliza ainda mais. A HotPDF embarca um decoder QR embutido, e usá-lo para validar o codificador parece um round trip óbvio, exceto que esse decoder lê as code words de dados e não faz correção Reed-Solomon nenhuma, então ele lia exatamente o que o codificador escrevia e reportava sucesso. Quando um codificador e um decoder compartilham uma suposição, um teste de round trip prova que eles concordam, não que algum dos dois está certo. Um código de correção de erro tem que ser validado contra vetores impressos no padrão, nunca contra o seu próprio decoder. O fixture THPDFBarcodeECCTests agora guarda um teste por formato, cada um nomeado pelo que fixa, e cada um chegando à aritmética por um hook compilado apenas sob {$IFDEF HPDF_TESTING}:
QRCheckWordsMatchISO18004Examplefaz a asserção das dez check words do exemplo modo byte 1-MDataMatrixCheckWordsMatchISO16022Examplefaz a asserção de 114 25 5 88 102 para as code words 142 164 186PDF417CheckWordsMatchGF929Referencefaz a asserção de 452 327 657 619 sobre GF(929) com raízes 3^1 a 3^4AztecCheckWordsKeepMessageAndMatchReferencefaz a asserção das check words e de que as words da mensagem sobrevivem à divisão in place
Quatro perguntas pegam a maior parte dessa família em qualquer codificador que você mantenha. A sua ordem de armazenamento do gerador bate com a ordem do índice de divisão, e você consegue apontar a linha que prova isso? As raízes começam onde o padrão diz, α^1 para Data Matrix e 3^1 para PDF417? Uma divisão in place restaura a região da mensagem depois? Pelo menos um teste compara check words, em vez de contagens de módulos, contra um número impresso numa especificação? Escopo também importa quando você decide o que fazer com artefatos existentes. Símbolos gerados antes da v2.748.0 renderizam e frequentemente escaneiam em condições ideais, porque uma imagem limpa não precisa de correção para ser lida; o que perderam é a tolerância a dano que é a razão inteira de escolher esses formatos. Etiquetas de vida longa e documentos arquivados carregando símbolos afetados valem regeneração em vez de verificação pontual com câmera de celular. Os codificadores vivem no suporte a código de barras do HotPDF, junto com o caminho de decodificação de QR e o tratamento de orientação dele e a camada de saída de relatórios que posiciona símbolos numa página; a referência completa da API de código de barras acompanha o HotPDF Delphi Component para Delphi e C++Builder