O HotPDF converte HTML em páginas PDF por meio de THPDFHTMLImporter.RenderHTML5, um perfil de mídia paginada versionado com um DOM real, uma cascata CSS real, tabelas, quebras de página e geração opcional de AcroForm a partir de controles de formulário HTML. Ele roda inteiramente no mesmo processo: sem motor de navegador, sem Chromium, sem conversor externo e, por padrão, sem nenhum acesso a arquivo ou rede
A razão pela qual existe um ponto de entrada separado em vez de um RenderHTML aprimorado é a compatibilidade. O método mais antigo vem renderizando faturas e cartas em aplicativos de produção há anos, e um DOM permissivo com uma cascata completa muda a saída de documentos que foram ajustados contra o comportamento antigo. Assim, o método antigo mantém sua semântica exata e tudo o que é novo vive por trás de RenderHTML5, cuja versão de perfil é relatada por HTML5ProfileVersion e cujos marcos suportados são listados por HTML5ProfileMilestones
O que o perfil HTML5 realmente adiciona?
Quatro capacidades importam na prática. Um DOM estrutural em que html e body são contêineres, e não nós de texto. Uma cascata CSS com precedência correta. Layout de tabela. E controle explícito de quebra de página, que é o que "mídia paginada" significa: o HTML foi projetado para uma janela de visualização com rolagem, e transformá-lo em páginas exige decidir onde o conteúdo pode quebrar
O ponto dos contêineres parece um detalhe de implementação e, na verdade, é a diferença entre funcionar e não funcionar. Se os elementos raiz forem tratados como contêineres de texto, todo o DOM colapsa em um único bloco de texto no momento da análise, e cada regra de folha de estilo, quebra de página, tabela e subárvore de formulário posteriores se aplica a nada. Qualquer renderizador HTML que produza uma única parede de texto indiferenciada a partir de um documento estruturado cometeu exatamente esse erro
A ordem da cascata, explicada em detalhes
A precedência do CSS não é uma única ordenação. O HotPDF aplica declarações normais de regras correspondentes em ordem de especificidade e depois em ordem de origem, aplica declarações normais inline por cima, depois as declarações !important de regras correspondentes e, por fim, o !important inline. Quatro passagens, nessa ordem
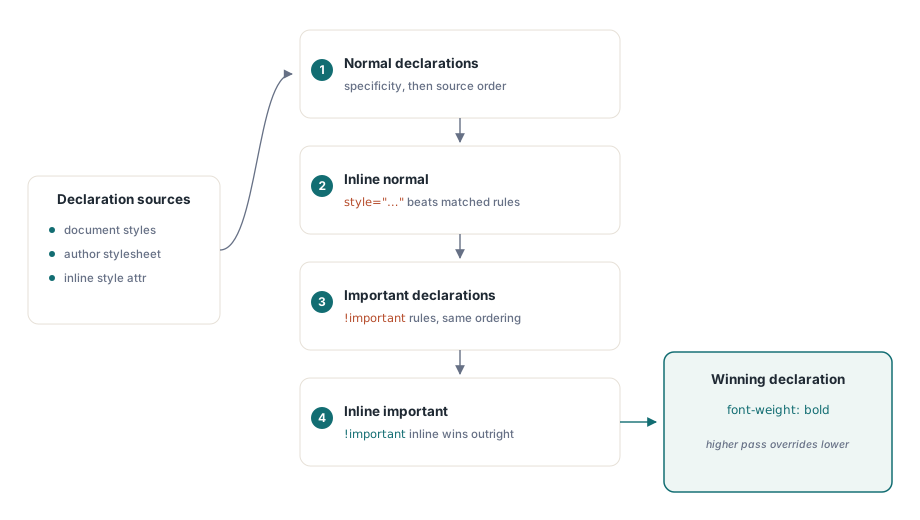
Implementações que reduzem isso a "o último vence" acertam os casos comuns e erram os interessantes, o que é pior do que errar tudo de forma uniforme, porque a falha só aparece em templates que usam !important para sobrepor uma folha de estilo base — exatamente os templates escritos por pessoas que esperam que a cascata funcione:
uses
  HPDFDoc, HPDFHTMLImport;

var
  Pdf: THotPDF;
  Importer: THPDFHTMLImporter;
  Html, Css: WideString;
begin
  Pdf := THotPDF.Create(nil);
  Importer := THPDFHTMLImporter.Create(Pdf);
  try
    Pdf.FileName := 'statement.pdf';
    Pdf.BeginDoc;

    Importer.Margin := 56;              // pontos
    Importer.BaseFontName := 'Arial';
    Importer.BaseFontSize := 10;
    Importer.CreateAcroForms := False;  // renderiza os controles, não cria campos

    Css := '@page { margin: 56pt } ' +
           'table { border-collapse: collapse } ' +
           'tr.total { page-break-inside: avoid; font-weight: bold }';
    Html := LoadTemplate('statement.html');

    if not Importer.RenderHTML5(Html, Css) then
      raise Exception.Create('nothing was emitted - check the markup');

    Pdf.EndDoc;

    Writeln(Format('profile=%d nodes=%d rules=%d layout ops=%d',
      [Importer.Statistics.ProfileVersion,
       Importer.Statistics.ParsedNodeCount,
       Importer.Statistics.CSSRuleCount,
       Importer.Statistics.LayoutOperationCount]));
  finally
    Importer.Free;
    Pdf.Free;
  end;
end;
O segundo argumento é uma folha de estilo do autor aplicada junto com o que o documento já carrega, que é a forma limpa de impor regras da casa, como margens de página e controle de linhas órfãs, sem editar cada template
Por que o importador nunca busca nada?
Um conversor de HTML para PDF que resolve referências externas é, na prática, um motor de falsificação de requisição do lado do servidor disfarçado de gerador de documentos. Aponte-o para uma marcação fornecida pelo usuário e ele buscará alegremente http://169.254.169.254/ ou uma URL de arquivo do seu servidor de aplicação e incorporará o resultado em um PDF que alguém baixa
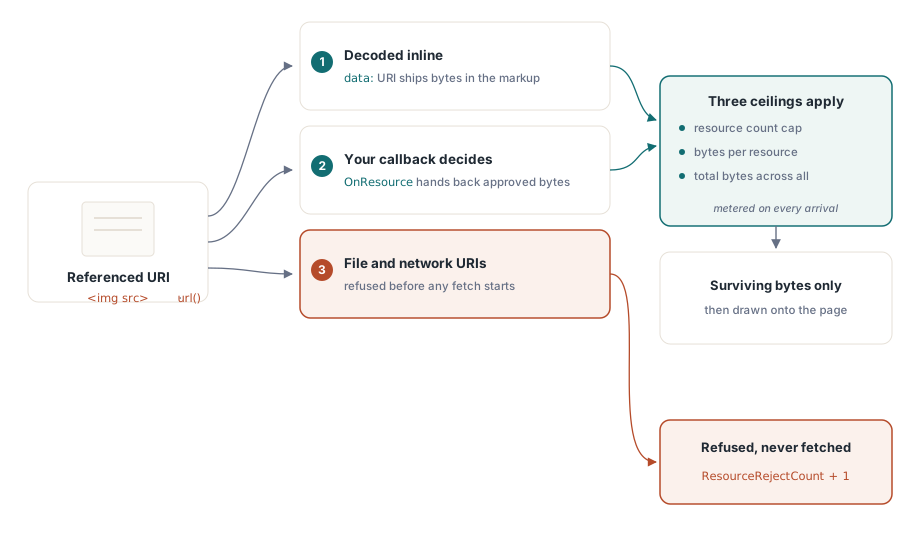
O HotPDF, portanto, não lê arquivos nem rede por padrão. Imagens e outros recursos chegam exatamente de duas formas: como URIs data: dentro da marcação, ou por meio do callback OnResource, no qual seu código decide o que uma URI significa e fornece os bytes:
procedure TReportForm.SupplyResource(Sender: TObject;
  const URI: WideString; ResourceKind: THPDFHTMLResourceKind;
  var Data: TBytes; var ContentType: string; var Handled: boolean);
begin
  Handled := False;
  // Sirva apenas a partir de um diretório local de ativos permitido. Nunca
  // passe a URI para um cliente HTTP, e nunca a combine com um caminho
  // sem validá-la antes
  if StartsText('asset:', URI) then
  begin
    Data := LoadAssetBytes(Copy(URI, 7, MaxInt));
    ContentType := 'image/png';
    Handled := Length(Data) > 0;
  end;
end;
Todo recurso que efetivamente chega ainda é contabilizado em três limites separados: quantos recursos, quantos bytes cada um e quantos bytes no total. Um callback que retorna fielmente o que lhe é pedido não pode ser induzido a esgotar a memória por um documento que referencia a mesma imagem de 50 MB duzentas vezes
Quatro orçamentos, um único modo de falha
Nós do parser, regras CSS, operações de layout e recursos são medidos de forma independente, porque falham de forma independente. Um documento pode ser pequeno e patologicamente caro para diagramar; outro pode ser raso, com uma folha de estilo projetada para explodir a correspondência de seletores. Esgotar qualquer um deles gera EHPDFHTMLImportBudget, uma classe de exceção dedicada, para que o esgotamento de orçamento possa ser capturado separadamente de uma entrada malformada
As estatísticas são reiniciadas no início de cada chamada de RenderHTML5, de modo que os números descrevem uma importação, e não a vida útil do objeto importador. Em um serviço que renderiza templates não confiáveis, registre ParsedNodeCount, LayoutOperationCount e ResourceRejectCount por documento: uma contagem de rejeições crescente geralmente significa que o autor do template está referenciando ativos que seu callback não reconhece, e uma contagem de operações de layout perto do teto significa que o próximo documento um pouco maior falhará
Escolhendo entre a importação de HTML e a API de layout
A importação de HTML vence quando o conteúdo é escrito como HTML por pessoas que não são desenvolvedores Delphi, quando os templates mudam com mais frequência do que o código, ou quando o mesmo conteúdo também precisa ser enviado por e-mail. A árvore de layout declarativa descrita em layout de PDF declarativo com saída marcada vence quando o documento é gerado a partir de dados pelo seu próprio código, quando você precisa que a estrutura PDF/UA seja emitida automaticamente, ou quando o controle preciso sobre a paginação importa mais do que a conveniência de autoria
Eles não são excludentes. Um formato comum é a importação de HTML para o corpo de um relatório, com cabeçalho, rodapé e blocos de assinatura desenhados diretamente, já que esses são geometria fixa que nenhum template deveria controlar. Tabelas são a única área em que vale a pena medir os dois: tabelas financeiras complexas às vezes paginam melhor pelo caminho dedicado de tabelas descrito em gerando tabelas em PDF
Defina CreateAcroForms de forma deliberada. Desativado, os controles de formulário HTML são renderizados como arte estática, que é o que um extrato impresso quer. Ativado, eles se tornam campos AcroForm interativos reais, que é o que um formulário preenchível quer, e o comportamento de campo que se segue é abordado em adicionando campos de formulário a um PDF carregado
A importação de HTML, o layout declarativo e a API de desenho direto atuam sobre o mesmo objeto de documento no Delphi e no C++Builder; a lista completa de recursos está na página do componente PDF Delphi HotPDF