Um relatório tagged com a capa removida pode abrir com a contagem de páginas correta e ainda estar quebrado em três lugares: o bookmark "Contents" não faz nada quando clicado, o verificador de acessibilidade acusa um elemento de estrutura que não pertence a página nenhuma, e um validador rigoroso aponta uma referência a um objeto livre. A page tree está perfeita. A ISO 32000-1 §7.7.3 pede apenas que a página saia de /Kids e que /Count caia em um, e um arquivo pode cumprir essa cláusula com metade do catálogo ainda apontando para a página que sumiu
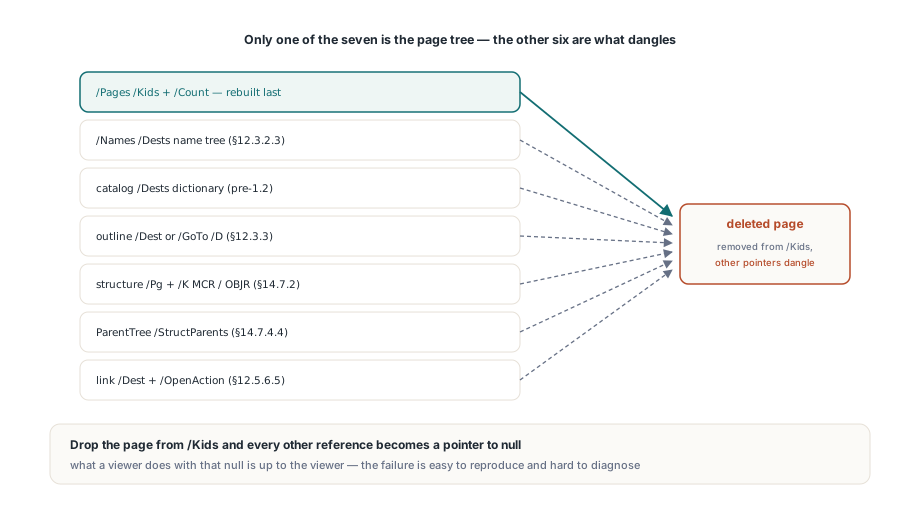
Sete estruturas podem guardar uma referência a uma página
Delas, apenas uma é a page tree. As demais ficam espalhadas pelo catálogo, pelo outline, pela estrutura lógica e pelas anotações de outras páginas, e todas resolvem para null assim que o objeto da página some do arquivo. O que cada visualizador faz com esse null é escolha dele, então o mesmo arquivo aparado pode se comportar mal de formas diferentes em dois leitores
- A name tree sob
/Names/Dests(§7.7.4, §12.3.2.3) mapeia nomes para arrays de destino cujo primeiro elemento é a página - O dicionário
/Destspré-1.2, direto no catálogo, guarda o mesmo tipo de arrays, chaveados por nome - Itens de outline (§12.3.3) alcançam uma página por um
/Destinline ou por uma ação/Acom/S /GoToe um array/D - Elementos de estrutura (§14.7.2) carregam uma chave
/Pgnomeando a página onde seu marked content vive, e seus filhos/Kpodem ser marked-content references e object references (§14.7.4.3) ligados a essa página - O
ParentTree(§14.7.4.4) mapeia números/StructParentsde páginas e anotações de volta para elementos de estrutura, e um elemento pode estar lá sem aparecer em lugar nenhum da cadeia/Ka partir da raiz - Anotações de link em outras páginas (§12.5.6.5) carregam um
/Destou uma ação/GoToapontando para a página, e o/OpenActiondo catálogo pode fazer o mesmo
O que o THotPDF.DeletePage faz antes de tocar em /Kids
O THotPDF.DeletePage(PageIndex) sobre um documento carregado varre todas essas estruturas primeiro e reescreve a page tree por último. O índice é zero-based. Duas guardas rodam antes de qualquer mudança: um índice fora da faixa levanta Invalid page number, e um pedido para remover a única página restante também levanta exceção, porque um nó /Pages com zero filhos não descreve um documento válido
A ordem da varredura é fixa: a name tree /Names /Dests, o dicionário /Dests legado do catálogo, o /OpenAction, o outline, o /StructTreeRoot junto com seu ParentTree e, por fim, os arrays /Annots de cada página que fica. Só depois disso o objeto da página é marcado como excluído, suas anotações widget são desligadas da árvore de campos do AcroForm, e /Kids, /Count e o /Parent de cada página sobrevivente são reescritos. No lado dos formulários, um campo pai que fica sem filhos depois que o widget vai embora também é removido, subindo até /Fields, para que um formulário aparado não guarde entrada de campo nenhuma sem nada na tela atrás dela
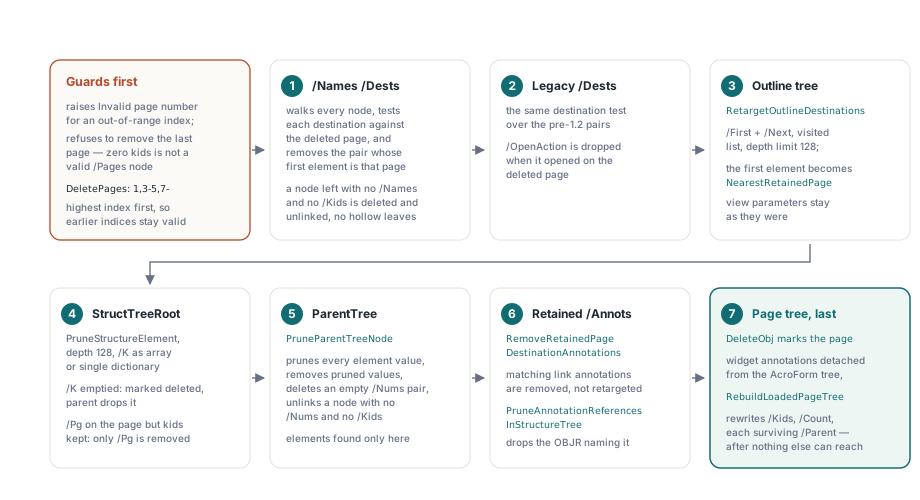
O DeletePages recebe uma string de intervalo 1-based como '1,3-5,7-', a notação que as outras operações de página sobre documento carregado usam, e exclui da página selecionada mais alta para baixo. Ir de cima para baixo mantém os números que você escreveu válidos enquanto as páginas somem por baixo deles. Um intervalo que cobre todas as páginas levanta exceção pelo mesmo motivo pelo qual o DeletePage recusa a última, e a função retorna quantas páginas removeu
var
  Pdf: THotPDF;
  Removed: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    // LoadFromFile retorna o número de páginas que ele carregou
    if Pdf.LoadFromFile('tagged-report.pdf') > 0 then
    begin
      // Zero-based: a página 0 é a capa
      Pdf.DeletePage(0);
      // Intervalo 1-based, numerado contra o documento como ele está agora
      Removed := Pdf.DeletePages('3-4,9');
      Pdf.SaveLoadedDocument('tagged-report-trimmed.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
Nomes desaparecem, bookmarks mudam de alvo
Named destinations que miravam a página excluída são removidas. Bookmarks que miravam nela são redirecionados. Na árvore /Names /Dests, todo nó é visitado e cada destino é testado nas duas formas que a spec permite, o array puro e o dicionário com chave /D; o par nome/valor sai quando o primeiro elemento do array é a página excluída. Um nó intermediário que fica sem /Names e sem /Kids é desligado do pai, para a árvore não guardar folhas ocas. O dicionário /Dests legado do catálogo recebe o mesmo teste, chave por chave, e um /OpenAction de catálogo que abria na página excluída é descartado, o que deixa a visualização inicial para o padrão do visualizador
Um nó que perde entradas também perde seu array /Limits. As novas chaves menor e maior não são recalculadas, e os visualizadores resolvem nomes sem elas. A §7.9.6 até exige /Limits em nós intermediários e folhas, então se algum passo de preflight do seu pipeline aplica essa regra à risca, passe o arquivo aparado por ele no mesmo fluxo
O outline é percorrido por /First e /Next com uma lista de visitados e um limite de profundidade de 128, para que uma cadeia /Next corrompida que faça loop sobre si mesma não deixe a chamada pendurada. Para todo array /Dest ou array /D de /GoTo que mirava a página excluída, o primeiro elemento é trocado pela página que vinha depois, ou pela página anterior quando a excluída era a última. Os parâmetros de visualização depois da referência de página ficam como estavam, então um salto /XYZ mantém seus valores de left, top e zoom e os aplica à nova página
A assimetria é deliberada. Um nome que não resolve para nada é legal e inofensivo; um GoTo que cita um destino inexistente simplesmente não faz nada. Um bookmark com destino null é pior: ele continua na barra lateral, parece clicável e falha. Pousar na página sobrevivente mais próxima é o melhor entre dois desfechos imperfeitos. O redirecionamento cobre apenas arrays de destino explícitos. Um item de outline cujo /Dest é uma string de nome resolve pela name tree, e depois que a varredura removeu esse nome, o bookmark não vai a lugar nenhum, então documentos que usam bookmarks nomeados intensamente merecem uma checagem após a exclusão. A checagem abaixo lê nomes com ResolveLoadedNamedDestination, que olha apenas o array /Names do nó raiz; ela dá uma resposta com significado para uma name tree plana, enquanto uma árvore dividida em /Kids retorna -1 para todo nome. A estrutura do outline em si, incluindo a semântica nada óbvia do /Count, está coberta no guia de como adicionar bookmarks e named destinations num PDF carregado
// Confira o resultado em vez de assumi-lo.
// Memo1 é um TMemo no seu próprio formulário.
Pdf.DeletePage(0);
// ResolveLoadedNamedDestination lê apenas o array /Names da raiz,
// então essa checagem faz sentido numa name tree plana; numa árvore
// que usa /Kids ela retorna -1 para todo nome, excluído ou não
if Pdf.ResolveLoadedNamedDestination('cover') = -1 then
  Memo1.Lines.Add('"cover" is not resolvable from the root /Names array');
// Um bookmark que apontava para a capa agora resolve para a página
// que vinha depois, que é o índice zero-based 0 após a exclusão
Memo1.Lines.Add(Format('Bookmark "Contents" -> page index %d',
  [Pdf.GetLoadedBookmarkPageIndex('Contents')]));
Podando a structure tree e o ParentTree
Elementos de estrutura que existiam só para a página excluída são removidos, e elementos que se estendem por várias páginas perdem a chave /Pg mas mantêm os filhos. A caminhada começa no /StructTreeRoot, desce pelo /K até uma profundidade de 128 e aceita tanto a forma array quanto a forma de dicionário único do /K que a §14.7.2 permite. Os filhos de cada elemento são podados antes de o próprio elemento ser julgado. Se a poda esvaziou o /K dele, o elemento é removido e o pai o descarta. Se o /Pg próprio nomeia a página excluída, mas ele ainda tem filhos e um pai /P, só o /Pg vai embora, porque o /Pg num elemento é apenas a página padrão para filhos marked-content que não nomeiam a deles, e esses filhos podem muito bem viver em outras páginas. Um elemento cujo /Pg é a página excluída e que não tem nada embaixo é removido de vez; dicionários de marked-content reference cujo /Pg nomeia a página caem nessa última regra
O ParentTree recebe o mesmo tratamento, por um motivo fácil de deixar passar: um elemento pode ser alcançável pelo ParentTree e por mais nada. Essa number tree mapeia inteiros /StructParents para um único elemento ou um array de elementos. Todo valor é podado com as regras acima, valores removidos saem dos seus arrays, um par /Nums cujo array acabar vazio é apagado, e um nó sem /Nums nem /Kids é desligado. Pule esta passada e os órfãos continuam apontando para uma página liberada através do /Pg. Para quem extrai texto na ordem das tags, o caminho é direto: a extração de texto na ordem da estrutura percorre exatamente essas árvores, e um elemento com /Pg null é um parágrafo que cai fora da ordem de leitura
Por que links em páginas sobreviventes são removidos em vez de redirecionados?
Uma anotação de link numa página retida cujo array /Dest ou ação /GoTo mira a página excluída é removida do /Annots dessa página, e a tag dela vai junto. O dicionário OBJR cujo /Obj nomeava a anotação sai do elemento de estrutura dele; se esse OBJR era o único filho do elemento, o elemento também é removido, e o ParentTree é podado de novo. Deixar o OBJR para trás quebraria a §14.7.4.3, que espera que o /Obj referencie um objeto real, e um verificador PDF/UA veria um elemento Link cuja object reference não leva a lugar nenhum
Bookmarks mudam de alvo; links não. Uma referência cruzada no corpo do texto que diz "veja a página 3" fica errada assim que a página 3 deixa de existir, e apontá-la silenciosamente para a página 4 transforma um link quebrado num link enganoso. Um bookmark que pousa no próximo capítulo é navegação; um link no corpo do texto é uma afirmação sobre o conteúdo. Remover é o padrão mais seguro. Se o seu fluxo de trabalho precisa que esses links sobrevivam, reescreva os destinos deles antes de chamar DeletePage, porque depois da chamada eles já saíram dos arrays /Annots
Saves incrementais e a armadilha do filho direto
O DeletePage se comporta igual entre BeginIncrementalUpdate e SaveIncrementalUpdate. A seção anexada guarda os objetos que a varredura mudou mais entradas free para os objetos removidos que tinham número de objeto próprio, como a página e as anotações de link excluídas. Tudo acima do %%EOF original permanece byte a byte, como a §7.5.6 exige
Pdf := THotPDF.Create(nil);
try
  Pdf.BeginIncrementalUpdate('tagged-report.pdf');
  Pdf.DeletePage(0);
  // Elementos de estrutura que perderam um filho /MCR direto são
  // anexados em forma reescrita com um array /K mais curto
  Pdf.SaveIncrementalUpdate('tagged-report-trimmed.pdf');
finally
  Pdf.Free;
end;
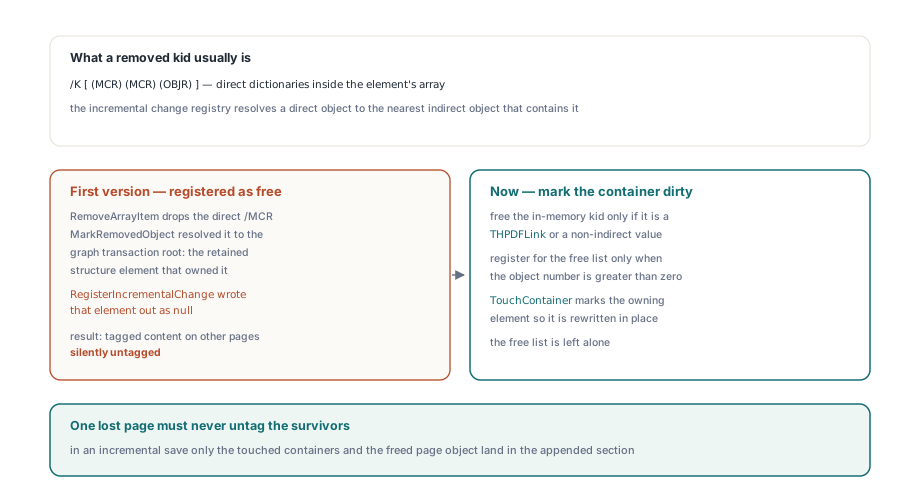
É exatamente aqui que um podador escrito à mão erra. Marked-content references (/Type /MCR) e object references (/Type /OBJR) são tipicamente dicionários diretos dentro do array /K do elemento pai deles. Um objeto direto não tem número de objeto nem entrada de xref, então não pode ser liberado sozinho. O movimento óbvio é "liberar" cada filho removido mesmo assim, e qualquer writer que mapeia um objeto direto para o objeto indireto que o contém acaba liberando o contêiner, que é o elemento de estrutura retido. Esse elemento sai como null, e conteúdo tagged em páginas que nunca foram tocadas perde as tags. O HotPDF manda um objeto removido para a lista de livres apenas quando ele tem número de objeto; para um filho direto, ele marca o elemento que o contém como modificado, de modo que o elemento é reescrito sem o filho e a lista de livres fica limpa
O mesmo cuidado decide o que o DeletePage deixa em paz num documento carregado. Os content streams, XObjects e anotações que não são widget da página excluída permanecem como objetos, porque um arquivo carregado pode compartilhar qualquer um deles com uma página que fica, e não há como provar o contrário de forma barata na hora da exclusão. Soltar a referência da page tree basta para um arquivo correto. Quantos bytes esses resíduos ainda custam é uma medição à parte, e o grafo de dependência de objetos e a análise de bytes retidos é a ferramenta para isso
DeletePage ou DeleteLoadedPage?
Use o DeletePage para qualquer remoção de página que um usuário pediu. O THotPDF.DeleteLoadedPage(PageIndex) é a variante leve: ele aplica as mesmas duas guardas, desloca a lista de páginas carregadas, reescreve /Kids e /Count, invalida o cache de páginas renderizadas e dispara OnLoadedDocumentModified. Ele não toca na name tree, no outline, na structure tree nem nas anotações de outras páginas, e não marca o objeto da página como excluído. O ComposeLoadedPagesNUp é o trabalho em que ele encaixa: ele anexa folhas recém-compostas que desenham as páginas de origem como form XObjects e depois descarta cada original com DeleteLoadedPage(0), já que as folhas se referem ao conteúdo das páginas e não aos objetos de página. Para um "remova a página 7 deste contrato" num arquivo tagged, com bookmarks e referências cruzadas, o DeletePage é a chamada que deixa toda referência consistente, tanto faz salvar com SaveLoadedDocument ou anexar com SaveIncrementalUpdate
Ambos os métodos, o DeletePages baseado em intervalos e o caminho de atualização incremental usado acima fazem parte do HotPDF Delphi Component, que edita PDFs carregados a partir de código Delphi e C++Builder sem um runtime de visualizador na máquina