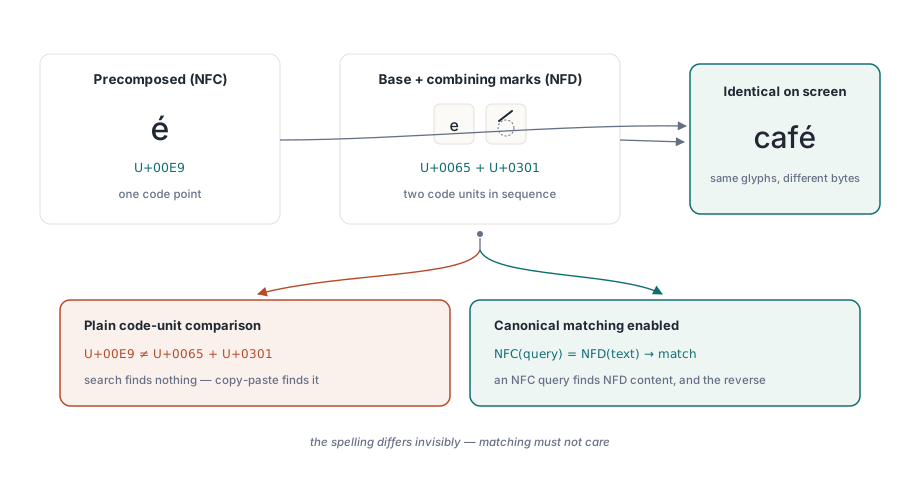
Um usuário digita Müller em uma caixa de busca, não recebe nada, copia o mesmo nome de dentro do PDF, cola de volta na caixa, e de repente recebe resultados. Confira as duas strings no debugger e o Length devolve 6 para a digitada e 7 para a colada. A palavra digitada carrega U+00FC, um ü pré-composto único; o documento guarda um u puro seguido de U+0308 COMBINING DIAERESIS. Ambas renderizam os mesmos glifos, e uma comparação por unidade de código jamais vai chamá-las de iguais
Por que strings de aparência idêntica comparam como diferentes?
O Unicode deliberadamente permite mais de uma codificação para o mesmo caractere abstrato, e chama as codificações de canonicamente equivalentes. O Unicode Standard Annex #15 define duas formas normais que importam para busca: NFC, que prefere pontos de código pré-compostos, e NFD, que separa todo caractere pré-composto em uma letra base mais suas marcas combinantes em uma ordem fixa. Letras latinas com diacríticos existem nas duas formas. Sílabas Hangul também, que podem aparecer como uma sílaba pré-composta ou como uma sequência de dois ou três jamo conjoinantes
Qual forma acaba em um PDF depende do software que o produziu, da plataforma em que rodou e, às vezes, de como o mapa ToUnicode de uma fonte foi construído. Um documento digitado em uma máquina e editado em outra pode misturar as duas formas na mesma página. Nada disso é visível para a pessoa que busca. O teclado e o método de entrada dela costumam produzir NFC, então qualquer conteúdo decomposto no arquivo fica inbuscável do lado dela
O workaround óbvio é jogar o problema no mesmo balde do case folding: minúsculas nos dois lados, tirar acentos, comparar. Isso quebra por um motivo estrutural. Case folding e remoção de acentos são um para um no nível da unidade de código, então o texto transformado tem exatamente o mesmo comprimento que o original, e um match na posição 17 na cópia transformada é um match na posição 17 no texto extraído. A normalização muda comprimentos. Uma letra pré-composta vira duas ou três unidades de código, uma sequência decomposta colapsa de volta para uma, sílabas Hangul expandem em jamo, e depois dessa transformação as posições que você recebe de volta não apontam mais para o texto que você extraiu
Buscando com soCanonicalEquivalent na PDF Library for Delphi
Na PDF Library for Delphi, o membro soCanonicalEquivalent de TPDFlibSearchOptions faz o SearchText comparar as decomposições canônicas da consulta e do texto da página, então uma consulta NFC encontra conteúdo NFD e uma consulta NFD encontra conteúdo NFC. A opção faz parte de um conjunto, o que significa que ela se combina com soWholeWord, soCaseSensitive, soWildcards e soDiacriticInsensitive sem API separada nenhuma:
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // preenche ContextBefore / ContextAfter
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // intervalo de páginas vazio = todas as páginas

    // Found conta todo hit; só os primeiros Length(Hits) foram copiados
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;
Dois detalhes nesse loop derrubam as pessoas. O SearchText devolve o número total de hits mesmo quando o buffer é menor, então iterar até Found - 1 em um documento grande anda para fora do fim de um array de 500 elementos; limite com Min ou troque por SearchTextEach, que entrega cada hit a um callback e não precisa de buffer nenhum. E o MatchText é o bloco de texto inteiro que continha o match, com MatchStart como índice baseado em 1 dentro dele, então a palavra encontrada em si é o Copy mostrado acima
Rode isso contra um arquivo que guarda Bäcker decomposto e o comprimento impresso é 7; contra um arquivo NFC é 6. Mesma consulta, mesmo conjunto de opções. O slice é sempre o texto como ele está no documento
Onde o hit cai no texto original
Essa última propriedade é o que torna a busca normalizada utilizável para qualquer coisa além de uma resposta sim/não. A PDF Library for Delphi registra, para cada unidade de código que o normalizador produz, o início e o fim do intervalo UTF-16 original de onde ela veio. Uma decomposição recursiva herda o intervalo do pai dela, uma composição mescla os intervalos das entradas dela, e quando um match é encontrado a busca varre o intervalo mapeado pelo menor início e o maior fim
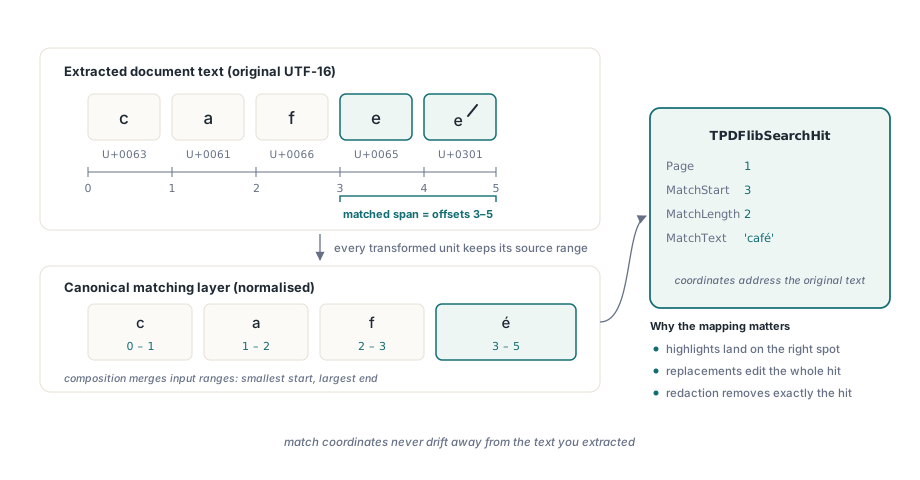
Como resultado, MatchStart, MatchLength, ContextBefore, ContextAfter e ambos os pontos de entrada de substituição endereçam o texto extraído que o chamador já tem. Uma busca que pudesse dizer "há um hit nesse bloco" mas não exatamente onde serviria para uma contagem de resultados e estaria errada para todo o resto: destaques deslariam um ou dois caracteres por letra acentuada, e uma substituição reescreveria o trecho errado de texto
O normalizador viaja dentro da biblioteca. Ele carrega tabelas compactas para decomposição canônica, composição e canonical combining class do Unicode 15.1, aplica as regras algorítmicas para Hangul em vez de entradas de tabela, e reordena marcas combinantes de forma estável durante o NFD. Nenhum arquivo de dados externo é carregado e nenhuma chamada de normalização do sistema operacional é feita, então um serviço Windows, um daemon Linux e um build Free Pascal devolvem hits idênticos para o mesmo arquivo. Nós preferimos assim mesmo que o SO poderia fazer o trabalho no Windows: um índice de busca construído em um servidor e consultado em outro nunca deve discordar porque as duas máquinas rodavam versões de Unicode diferentes
A opção fica desligada por default, e esse default é razoável. Construir o texto NFD e o mapa de posições dele custa tempo, e uma busca sobre faturas só ASCII nunca precisa disso. Quando soCanonicalEquivalent está definido, cada bloco de texto mantém duas cópias transformadas, uma com marcas combinantes e outra sem, então um lote de consultas sobre o mesmo bloco o normaliza uma vez. O case folding simples continua no caminho mais barato, um para um
O que dá errado quando um hit termina dentro de um caractere?
A equivalência canônica responde "isto é o mesmo texto", mas não diz nada sobre onde um hit pode parar. Busque um café decomposto por cafe com soCanonicalEquivalent sozinho e as primeiras quatro unidades de código dão match; o acento agudo combinante que vem depois fica de fora do hit. O soWholeWord não pega isso, porque os caracteres de palavra dele seguem regras de identificador (letras ASCII, dígitos e underscore) e uma marca combinante conta como fronteira. O destaque cobre cafe, e uma substituição deixa um acento perdido flutuando sobre o que vier depois
A mesma coisa acontece bem além dos acentos latinos. Um emoji de bandeira são dois pontos de código de regional indicator. Um emoji de família são várias pessoas unidas por zero-width joiners. Uma conjunta devanágari é uma consoante, um virama e outra consoante, e uma vogal vietnamita pode carregar duas marcas empilhadas. Qualquer coisa fora do Basic Multilingual Plane é um surrogate pair em UTF-16, e cortar um ao meio produz um surrogate não pareado que muitos pipelines de texto substituem por U+FFFD
soGraphemeClusters exige que as duas pontas de todo hit, literal ou curinga, caiam em fronteiras de extended grapheme cluster conforme definido pelo Unicode Standard Annex #29. A segmentação cobre pareamento CR/LF, caracteres de controle, tipos de sílaba Hangul, Extend e SpacingMark, Prepend, sequências de emoji ZWJ, pares de regional indicator e quebras de conjunta índica, e nunca coloca uma fronteira dentro de um surrogate pair. Com a flag definida, cafe deixa de dar match em um café decomposto completamente; adicione soDiacriticInsensitive se casamento cego a acentos é o que você quer de fato
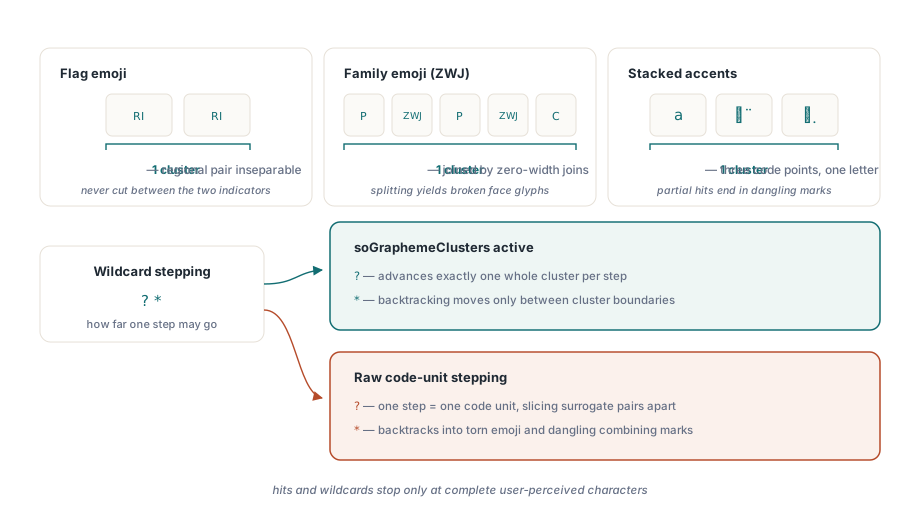
Wildcards são onde a flag muda os resultados de forma mais visível. Sob soCanonicalEquivalent o texto da página é comparado em NFD, então côté vira c o U+0302 t e U+0301 não importa como o arquivo o guardou. Sem soGraphemeClusters, o ? em c?té consome exatamente uma unidade de código, o o, e então espera um t e encontra U+0302. Nenhum hit. Com a flag, ? avança um cluster inteiro, e o backtracking para * também se move só entre fronteiras de cluster:
// "?" avança um caractere percebido pelo usuário, então isso encontra côté
// não importa se o PDF o guardou pré-composto ou decomposto
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// A substituição usa os mesmos intervalos seguros por cluster, então ela nunca
// divide um emoji nem deixa um acento órfão para trás
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
  Lib.SaveToFile('contracts-edited.pdf');
SearchAndReplaceTextInContent reescreve o texto dentro do conteúdo da página e devolve o número de matches que substituiu. Quando devolve zero, GetLastUnicodeReplacementDiagnostics diz por quê, por exemplo que um match não pôde ser mapeado de volta ao conteúdo que o desenhou. O outro ponto de entrada, SearchAndReplaceText, aceita o mesmo conjunto de opções e desenha a substituição sobre o bloco encontrado em vez disso
Escolhendo um conjunto de opções por carga de trabalho
Três combinações cobrem a maior parte das aplicações. Para uma caixa de busca de usuário final dentro de um visualizador de documentos, use soCanonicalEquivalent mais soDiacriticInsensitive: as duas formas de codificação dão match, e grafias acentuadas e sem acento também, que é o que as pessoas esperam depois de anos de busca na web. Para revisão jurídica ou de conformidade, em que um falso positivo custa uma tarde a alguém, use soCanonicalEquivalent com soCaseSensitive e soWholeWord e deixe o case folding de acentos desligado, então a equivalência fica exata enquanto ignora como o arquivo aconteceu de codificar
Para qualquer coisa que mude o documento, acrescente soGraphemeClusters toda vez. Esse é o único ponto que não deixaríamos ao gosto. Uma busca que devolve um intervalo uma unidade de código curto só engana a pessoa que lê os resultados; uma substituição ou remoção que usa o mesmo intervalo grava o erro no arquivo, e ninguém nota até a página ser impressa ou extraída de novo. Remoção que precisa destruir conteúdo em vez de cobri-lo é um tópico próprio, coberto em redação real e remoção de conteúdo
Quando vários termos rodam contra o mesmo documento, prefira SearchTextBatch. Ele avalia toda consulta não vazia enquanto os blocos de texto de uma página estão residentes, então cada página é extraída uma vez e cada bloco é normalizado uma vez, e toda consulta carrega o próprio conjunto de opções:
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // Hangul: NFC ou jamo no arquivo
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;
Os hits voltam ordenados por página, depois bloco, depois consulta, e QueryIndex é a posição baseada em zero no array que você passou. SearchTextBatchEach é a forma de callback para conjuntos de resultados que você não consegue dimensionar de antemão. Como os blocos de texto são extraídos em primeiro lugar está descrito em busca de texto e enumeração de elementos de página
Escritas em que a equivalência canônica não é opcional
Para o coreano, a equivalência canônica decide se um nome é encontrado sequer, porque sílabas pré-compostas e jamo decompostos ambos aparecem em documentos reais. O vietnamita empilha uma marca de tom sobre uma vogal que pode já carregar um breve ou um circunflexo, então a forma de composição dele depende inteiramente do produtor. Para devanágari, bengali e as outras escritas índicas, as regras de conjunta decidem se a fronteira de um hit cai em um lugar que um leitor reconhece. Japonês e chinês são comparativamente fáceis no lado da busca, embora o lado do layout não seja, como cobre escrita vertical para japonês e chinês
Nossa recomendação é direta. Se o corpus contém qualquer idioma além do inglês, ligue soCanonicalEquivalent primeiro e só desligue depois de cronometrá-lo nos seus próprios documentos e achar o custo inaceitável. A falha que ele evita cai exatamente nos nomes que os seus usuários mais buscam
O mesmo motor ciente de Unicode alimenta busca, extração, substituição e redação a partir de Delphi, C++Builder e Free Pascal; conjuntos de opções, a API em lote e o resto do kit de texto estão listados na página do produto PDF Library for Delphi