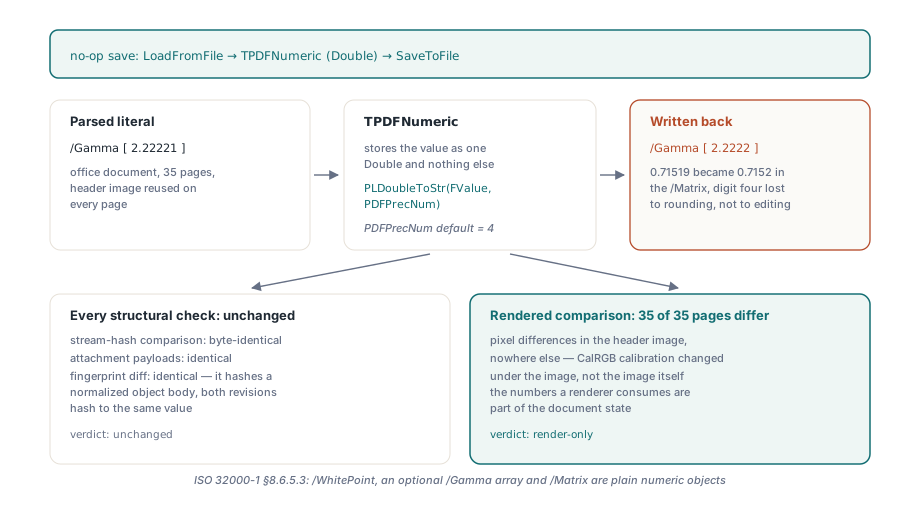
Carregue um PDF calibrado, não mude nada, salve com outro nome e faça o diff do dicionário de espaço de cor: entrou /Gamma [2.22221 2.22221 2.22221], saiu /Gamma [2.2222 2.2222 2.2222]. O escritor reformatou um número que nunca precisou tocar, e a página agora renderiza com cores ligeiramente diferentes. A cura é tratar todo decimal lido como duas coisas ao mesmo tempo, um valor para aritmética e um literal para saída, e continuar emitindo o literal até que alguém realmente atribua um valor novo
Por que um save no-op pode mover as cores CalRGB
Os pixels se movem porque o renderer recebe dados de calibração ligeiramente diferentes enquanto os bytes da imagem permanecem idênticos. A ISO 32000-1 §8.6.5.3 define um espaço de cor CalRGB por um /WhitePoint obrigatório, um array /Gamma opcional de três elementos e um /Matrix opcional de nove elementos, e todos são objetos numéricos simples no dicionário de espaço de cor. Passe esses valores por um Double e um formatador fixado em quatro casas decimais, e 2.22221 vira 2.2222 enquanto uma entrada de matriz 0.71519 vira 0.7152. Um valor de gama é um expoente aplicado a cada componente de cada pixel que passa por aquele espaço, então a mudança aparece onde quer que o espaço seja usado
Para um arquivo que declara um espaço CalRGB para uma imagem de cabeçalho reutilizada em 35 páginas, os 35 cabeçalhos renderizam com cores deslocadas e nada mais nessas páginas muda. As conferências que as pessoas tentam primeiro voltam limpas. Um hash dos bytes decodificados do stream compara dados de imagem, e os dados de imagem realmente são idênticos; o dano fica num dicionário. O diff de revisão descrito em o artigo de modification level pega a impressão digital de um corpo de objeto normalizado, então as duas revisões também dão o mesmo hash ali. Uma comparação de página renderizada é o que pega isso. Para qualquer pipeline que reescreve PDFs produzidos por outro software, nós colocaríamos uma comparação de renderização por página à frente de toda checagem estrutural
Como um número real de PDF pode ser escrito
A ISO 32000-1 §7.3.3 define um número real como uma string decimal: sinal opcional, dígitos, um ponto, mais dígitos. Nada de notação de radix. Nada de forma com expoente. O Anexo C, que lista limites de implementação, espera que cerca de cinco dígitos decimais significativos na parte fracionária sejam honrados. Uma precisão de saída padrão de quatro, portanto, já fica um dígito abaixo do que a especificação manda os leitores guardarem, e o arquivo não fez nada de errado ao usar cinco
Perto de zero, um formatador ingênuo faz pior que perder um dígito. O jeito comum de imprimir um Double com N casas é multiplicar por 10^N, arredondar para inteiro e escrever os dígitos, e quando esse inteiro é zero a saída é 0. Dê a ele o primeiro operando de 0.00001 0 0 1 0 0 cm com quatro casas e o resultado é 0 0 0 1 0 0 cm, uma matriz singular que faz tudo desenhado sob ela desaparecer. Uma entrada /Matrix de -0.000012345 vai pelo mesmo caminho
Quando o PDF Library for Delphi (PDFlibPas) precisa formatar um Double ele mesmo, ele mantém o número de dígitos significativos pedido para um valor não zero menor que o passo de precisão em vez de escrever 0. Com quatro casas, 0.00001 é escrito como 0.00001 e 0.0000123 como 0.0000123; só magnitudes abaixo de cerca de 5E-16 ainda saem como 0. Isso mantém sensatos os números recém-escritos. Um número lido que nunca precisou de reformatação é outro assunto, e a biblioteca o trata não o reformatando de forma alguma
Como o PDFlibPas guarda o literal que leu
TPDFStructure.Decode guarda o texto de origem de todo real padrão que ele tokeniza, ou seja, um token com ponto decimal e sem marcador de expoente, ao lado do Double convertido. TPDFNumeric.Output escreve esse texto de volta sempre que ele está presente e formata o Double no PDFPrecNum da estrutura só quando não está. TPDFNumeric.SetTo descarta o texto, porque um número editado é um número novo e deve seguir a precisão de saída corrente
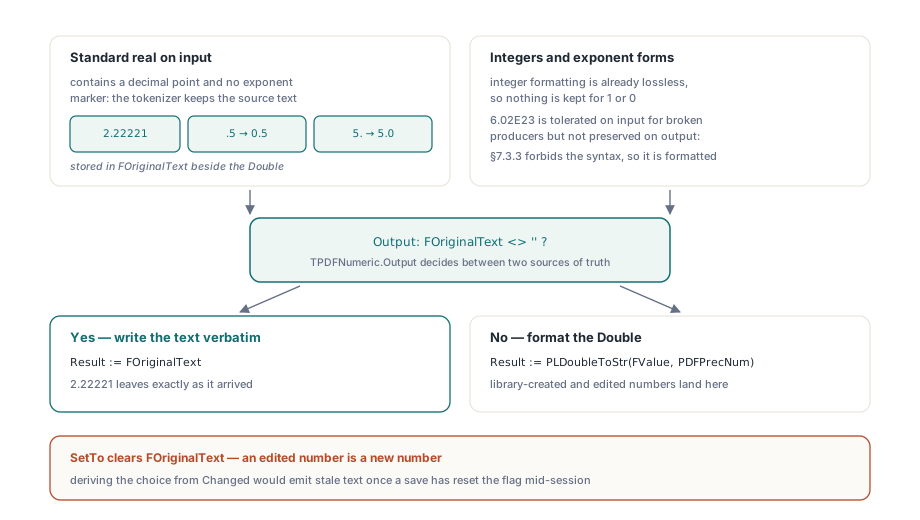
Ligar o reset ao SetTo foi deliberado. O atalho tentador é emitir o texto original a menos que a flag Changed do objeto esteja ligada, já que essa flag já existe em todo objeto. Só que o pipeline de save limpa o Changed depois que um objeto foi escrito, então um valor editado, salvo e editado de novo na mesma sessão voltaria a emitir o literal velho dele no segundo save. Limpar o texto dentro da própria atribuição significa que o literal e o valor nunca podem discordar
Algumas fronteiras são intencionais. Inteiros não são guardados como texto porque a formatação de inteiros já é sem perda. Formas com expoente como 6.02E23 são aceitas na entrada por causa de produtores que as escrevem de qualquer jeito, mas são formatadas como qualquer número gerado pela biblioteca na saída, já que copiá-las de volta perpetuaria uma sintaxe que a §7.3.3 exclui. O tokenizador também aplica seu pequeno reparo de sempre antes de guardar o texto: um literal com ponto inicial como .5 é guardado como 0.5, um literal com ponto final como 5. como 5.0. Todo leitor trata cada par como o mesmo número, e a grafia reparada é aceita de longe mais amplamente
O trecho abaixo passa os valores CalRGB pela camada de objetos diretamente, então cada regra pode ser vista sem abrir um arquivo PDF. As linhas Assert são conferências que sugerimos acrescentar nos seus próprios testes; não são chamadas à biblioteca
uses
  PDFlibStruct;

var
  Structure: TPDFStructure;
  Values: TPDFArray;
  Number: TPDFNumeric;
begin
  Structure := TPDFStructure.Create;
  try
    Structure.PDFPrecNum := 4;
    Values := TPDFArray(Structure.Decode('[2.22221 0.71519 -0.000012345 1 0.12567]'));

    // Conferência sua: entrada não editada sobrevive verbatim, inclusive o
    // valor que um formatador ingênuo de quatro casas colapsaria para 0
    Assert(Values.Output = '[ 2.22221 0.71519 -0.000012345 1 0.12567 ]');

    // Uma edição descarta o texto original e segue o PDFPrecNum
    Number := TPDFNumeric(Values.Item[0]);
    Number.SetTo(0.123456);
    Assert(Number.Output = '0.1235');
    Assert(Structure.NewNumeric(0.123456).Output = '0.1235');

    // Valores novos minúsculos guardam dígitos significativos em vez de virar 0
    Assert(Structure.NewNumeric(0.0000123).Output = '0.0000123');

    // Baixar a precisão depois não alcança a entrada não editada
    Structure.PDFPrecNum := 2;
    Assert(TPDFNumeric(Values.Item[1]).Output = '0.71519');
  finally
    Structure.Free;
  end;
end;
Uma armadilha ao escrever asserções como estas: o Round do Delphi usa banker's rounding, e 0.000012345 * 1e8 avalia como 1234.4999… em binário em vez de 1234.5. Nós batemos direto nesse valor enquanto conferíamos o caminho de formatação perto de zero. Escolha entradas de teste que não sejam pontos médios binários sempre que uma asserção depender de como o último dígito arredonda
O que o SetPrecision controla?
TPDFlib.SetPrecision define as casas decimais dos números que a biblioteca escreve: gráficos desenhados por meio do painter, números criados a partir de um Double, como por NewNumeric, e valores lidos que foram depois alterados com SetTo. Ele aceita de 2 a 8 e devolve 0 para qualquer coisa fora dessa faixa. Um decimal lido que ninguém editou mantém o texto de entrada dele seja qual for a configuração, e mudar a configuração depois do LoadFromFile não alcança retroativamente o que já foi lido. Origem passada ao SetObjectFromString passa pelo mesmo tokenizador e é guardada do mesmo jeito
Nossa recomendação é deixar o SetPrecision em paz, a menos que a geometria que você gere precise de passos mais finos. Aumentá-lo para proteger arquivos de entrada não compra nada, porque entrada intocada já guarda os próprios dígitos, e faz cada número que você desenha ficar mais longo. Cinco casas é uma escolha sensata para desenho abaixo do ponto; oito na maior parte infla content streams
uses
  PDFlibrary;

var
  PDF: TPDFlib;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;

    // Comanda os números escritos daqui em diante; os arrays /Gamma,
    // /Matrix e /WhitePoint lidos guardam o texto original
    PDF.SetPrecision(5);

    PDF.SelectPage(1);
    PDF.SetLineWidth(0.123456);       // números desenhados usam cinco casas
    PDF.DrawLine(72, 72, 300, 72);

    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Content streams: edições guardam operandos, normalização é opt-in
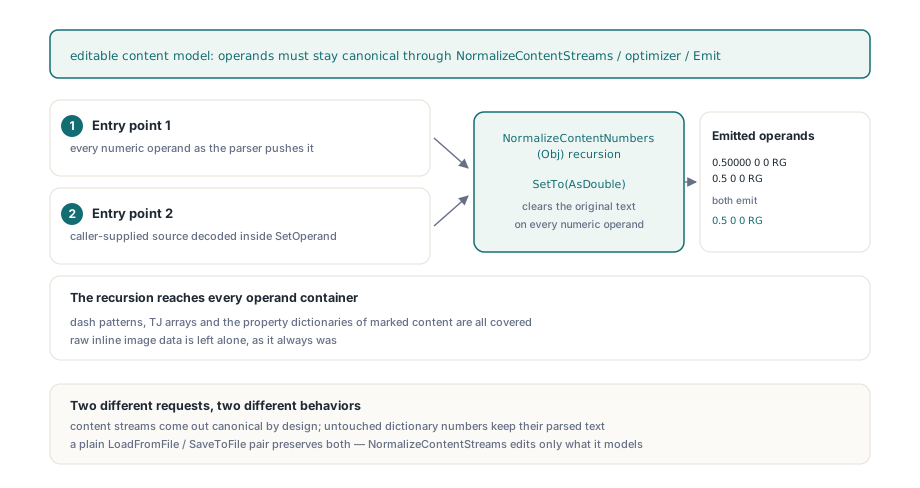
O modelo de conteúdo editável guarda o texto dos operandos por padrão e canoniza números só quando a saída canônica é o propósito da chamada. TPDFContentProgram.CanonicalNumbers tem padrão False, então uma camada devolvida por ParsePageContentLayer, o mesmo modelo em que o rastreador de estado gráfico se apoia, reemite todo operando numérico intocado exatamente como escrito. Edições de página que reescrevem uma camada inteira, incluindo ScalePage, TransformPageElement, DeletePageElement, RedactRegion, ConvertTextToPaths e o seu próprio programa escrito de volta com WritePageContentLayer, mudam apenas os operandos que a edição tocou
O outro padrão parece mais arrumado: canonizar a cada parse, para que o caminho de edição e o NormalizeContentStreams sempre produzam a mesma grafia. Nós achamos que é o padrão errado para edição. Um ScalePage numa camada contendo 0.123456 w escreveria de volta 0.1235 w, e todo outro operando da camada seria reescrito também, embora quem chamou tenha pedido apenas a escala. Forma canônica pertence às operações cujo propósito é saída comparável
Essas operações continuam a tendo. NormalizeContentStreams e o otimizador de conteúdo executado na compressão do save analisam com CanonicalNumbers em True, porque o trabalho deles é saída estável a partir de entrada arbitrária; se 0.50000 0 0 RG e 0.5 0 0 RG fossem emitidos de forma diferente, toda comparação a jusante derivaria com os hábitos de formatação do produtor. A canonização recursa por arrays e dicionários, então padrões de traço, arrays TJ e dicionários de propriedade de marked-content ficam cobertos, enquanto dados brutos de imagem inline ficam de fora. Operandos fornecidos por SetOperand são canonizados seja qual for a flag. Um content program carrega um armazenamento de números próprio, fixado em quatro casas decimais, independente do SetPrecision, então um operando editado sai com quatro. Só o Parse lê a flag, o que significa que ela precisa ser definida antes de analisar; para um programa que o ParsePageContentLayer já analisou, defina a flag e chame Parse(Emit)
uses
  PDFlibrary, PDFlibContentModel, PDFlibContentOps;

var
  PDF: TPDFlib;
  Prog: TPDFContentProgram;
  I: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;
    PDF.SelectPage(1);
    Prog := PDF.ParsePageContentLayer(1);
    if Prog = nil then
      Exit;
    try
      // Muda uma largura de linha; todo outro operando guarda o texto de origem
      I := Prog.FindNextOp(0, coLineWidth);
      if I >= 0 then
        Prog.SetOperand(I, 0, '0.123456');   // emitido como 0.1235
      PDF.WritePageContentLayer(1, Prog);

      // Cópia canônica só para comparação, não escrita de volta:
      // Parse é o único leitor da flag, então re-parseie depois de ligá-la
      Prog.CanonicalNumbers := True;
      Prog.Parse(Prog.Emit);
      // O Prog.Emit agora escreve 0.50000 e 0.5 do mesmo jeito
    finally
      Prog.Free;
    end;
    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Juntas, as regras para quem chama são curtas. Um LoadFromFile simples seguido de SaveToFile deixa content streams intocados e números de dicionário intocados como estavam. Uma página editada pelo modelo de conteúdo mantém o texto de todo operando que a edição não mudou. NormalizeContentStreams, o otimizador que roda quando o conteúdo é comprimido no save, e qualquer programa analisado com CanonicalNumbers em True produzem números canônicos por design, e o resto do documento continua preservado
Quanto custa, e onde a garantia termina
Cada TPDFNumeric carrega uma referência extra de AnsiString, e todo decimal lido mantém o texto de origem dele vivo enquanto o objeto viver. Num documento com milhões de números reais isso é memória mensurável, e merece lugar em qualquer benchmark de documentos grandes que você rodar. A garantia também tem escopo no documento do próprio número. Copiar objetos entre documentos, ou reconstruir valores pela API de objetos, produz números novos, e números novos seguem a precisão de saída
Números preservados e saída byte-idêntica são propriedades separadas. Um load-and-save de um documento intocado mantém os números de calibração que o renderer consome, mas a identidade de bytes também depende da numeração de objetos, da compressão de streams e do identificador de trailer coberto em o artigo do PDF ID determinístico. O diff de impressão digital continua hasheando o corpo normalizado, o que significa que diferenças de arredondamento em arquivos escritos por outras ferramentas ficam fora do que ele compara; uma comparação de renderização segue sendo a checagem para esses
O tratamento numérico e a semântica exata do SetPrecision estão cobertos na referência da losLab PDF Developer Library, junto com as chamadas do modelo de conteúdo usadas acima