A PDF Library for Delphi pode mesclar imagens dentro de um PDF que parecem iguais, mas não são idênticas byte a byte, por meio de DeduplicateSimilarImages. A deduplicação exata só mescla imagens cujos dicionários e cargas úteis codificadas coincidem; esta compara o que as imagens realmente parecem, usando um hash perceptual mais dois limites de erro de pixel, e redireciona toda referência para um único objeto canônico
Os arquivos onde isso compensa são os que cresceram por acidente. Um lote digitalizado em que cada página carrega o mesmo logotipo recodificado por um scanner diferente. Um relatório montado a partir de fontes que cada uma incorporou o mesmo gráfico em uma qualidade JPEG ligeiramente diferente. Um catálogo cujas miniaturas foram regeneradas por duas ferramentas. Em cada caso o arquivo contém muitas cópias de uma imagem, e a deduplicação exata não consegue tocar em nenhuma delas
O que "parecido o suficiente" precisa significar
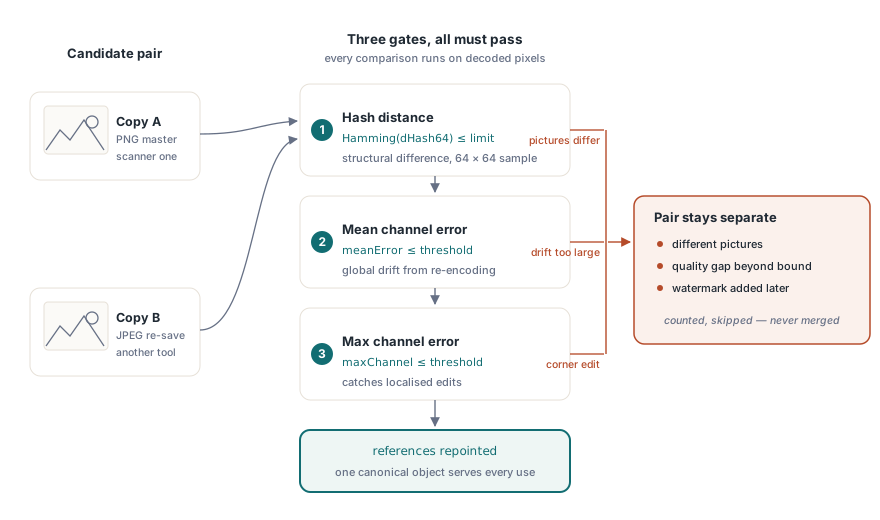
Três limites precisam ser satisfeitos antes que duas imagens sejam mescladas, e cada um captura um tipo diferente de diferença. A distância do hash perceptual delimita a diferença estrutural: um hash de diferença de 64 bits é calculado a partir de uma amostra de 64 por 64 da imagem decodificada, e a distância de Hamming permitida vai de 0 a 7. O erro médio de canal delimita o desvio geral, que é o que a recodificação produz. O erro máximo de canal único delimita a diferença localizada, que é o que uma pequena edição produz
Exigir os três é o que torna a mesclagem defensável. Uma imagem que difere por uma marca d'água em um canto tem um erro médio baixo e um erro máximo alto, então o portão de erro máximo a rejeita. Uma imagem que foi recomprimida tem um pequeno erro em toda parte, então ela passa. Essa é exatamente a distinção que um otimizador de tamanho precisa fazer
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // Distância de hash 2, erro médio 2, erro de canal único 4.
    // As opções podem pedir uma execução de teste sem modificar nada
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
A identidade semântica vem antes da similaridade visual
Antes de qualquer pixel ser comparado, as imagens candidatas precisam concordar semanticamente. A biblioteca constrói uma assinatura estável a partir do dicionário de imagem completo, excluindo /Length, /Filter e /DecodeParms, de modo que dimensões, espaço de cor, profundidade de bits, máscaras, o array /Decode, interpolação, associação a conteúdo opcional e metadados, tudo precisa coincidir
Essa ordenação evita toda uma classe de mesclagens erradas. Duas imagens podem parecer idênticas em uma amostra de 64 por 64 e se comportar de forma diferente na página: uma com /Interpolate verdadeiro e outra sem serão suavizadas de forma diferente ao serem escaladas, e uma pertencente a um grupo de conteúdo opcional desaparecerá quando essa camada for ocultada. Mesclar através dessas fronteiras produz um documento que é menor e errado
Apenas Image XObjects indiretos são escaneados. Imagens inline são uma construção diferente com economia diferente, e imagens que não podem ser decodificadas são ignoradas de forma conservadora e contabilizadas em vez de mescladas por fé — sem evidência de pixel, sem mesclagem
Como a busca permanece barata
Comparar toda imagem contra toda outra imagem é quadrático, o que é inaceitável em um documento contendo milhares de imagens. O hash é, portanto, dividido em oito bandas de 8 bits, com um índice ordenado sobre cada uma
O princípio da casa dos pombos faz o resto: se dois hashes diferem em no máximo 7 bits, eles precisam concordar exatamente em pelo menos uma das oito bandas. Buscar candidatos banda por banda, portanto, encontra toda correspondência permissível sem uma varredura exaustiva de pares, e o limite publicado de 7 existe precisamente porque a garantia só vale até essa distância
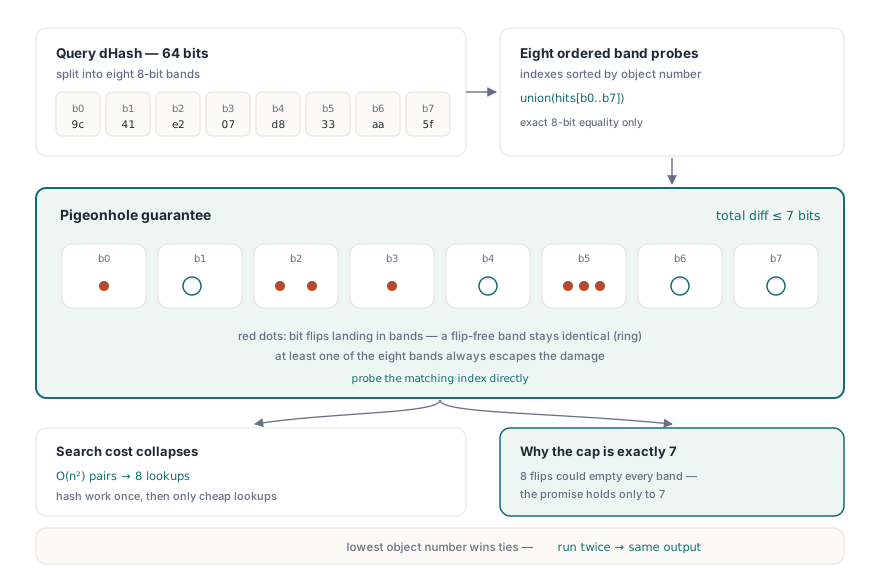
Candidatos e acertos de banda são ordenados deterministicamente por número de objeto e geração, e o menor número de objeto se torna canônico. Isso torna a saída reproduzível: rodar o otimizador duas vezes na mesma entrada produz as mesmas escolhas canônicas, o que importa quando o resultado é comparado ou assinado
Execuções de teste e relatórios honestos
Como isso é uma otimização com perdas no sentido de que as imagens mescladas não eram idênticas, o fluxo de trabalho sensato é olhar antes de saltar. A opção de execução de teste relata o que seria mesclado e quanto de carga útil seria recuperada sem modificar o grafo de objetos, de modo que um trabalho em lote pode registrar o efeito e um humano pode aprovar os limites uma vez, em vez de por arquivo
Duas notas de honestidade no relatório merecem menção. O número recuperável estima apenas a carga útil codificada de streams duplicados; ele não conta o overhead de dicionário, objeto indireto e referência cruzada, então a redução real de tamanho de arquivo é ligeiramente maior do que a relatada, e não menor. E o relatório expõe o erro máximo aceito e a carga de trabalho de comparação, de modo que você pode ver o quão perto as mesclagens chegaram dos seus limites
A grade fixa de amostragem de 64 por 64 é uma aproximação intencional, e tem uma consequência que vale a pena declarar claramente: uma diferença menor do que uma célula de amostra pode passar despercebida mesmo com um limite zero. Uma única palavra alterada em uma página digitalizada pode não sobreviver a essa amostragem. Quando prova em nível de byte é exigida, use o caminho de deduplicação exata em vez disso — ele mescla apenas recursos genuinamente idênticos e não faz nenhum julgamento visual
Onde isso se encaixa em um pipeline de redução de tamanho
Ordene as passagens por risco. Rode primeiro a deduplicação exata de recursos, já que ela não tem perdas e é gratuita. Depois a subsetagem de fontes, que também não tem perdas e geralmente é o maior ganho isolado em documentos com muito texto, como abordado em otimização de tamanho de arquivo PDF e subsetagem de fontes. Depois recompressão ou subamostragem de imagem, se o meio de destino permitir. A deduplicação perceptual vem depois dessas, porque é a única etapa cujo resultado depende de um julgamento
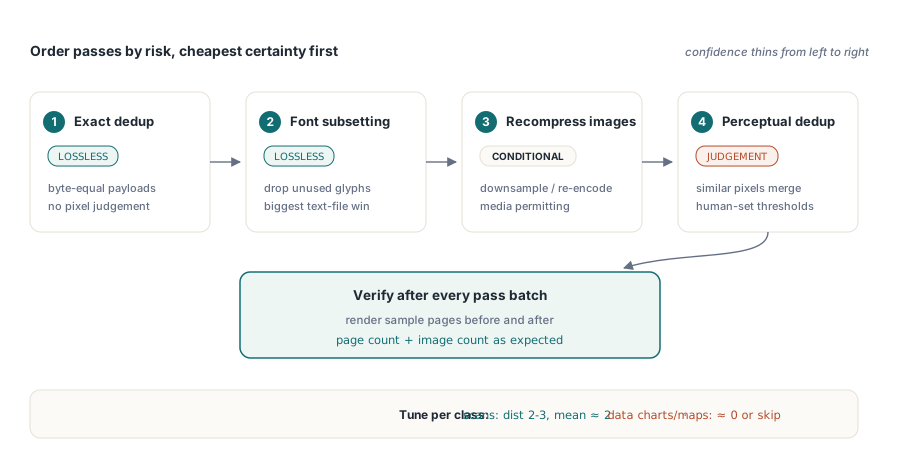
Escolha os limites por classe de documento, e não globalmente. Para lotes digitalizados em que toda página carrega o mesmo timbre, uma distância de hash de 2 a 3 com um erro médio em torno de 2 mescla o timbre de forma confiável. Para documentos em que as imagens carregam dados — gráficos, mapas, imagens médicas — use limites zero ou próximos de zero, ou pule a passagem inteiramente, porque dois gráficos que diferem em um ponto plotado são dois gráficos diferentes, não importa o quão parecidos pareçam em 64 por 64
Depois de otimizar, verifique. Renderize uma amostra de páginas antes e depois e compare-as, e confira se a contagem de páginas e a contagem de imagens mudaram do jeito que você esperava. O caminho de inspeção para o que um documento realmente contém é descrito em auditando o tamanho de arquivo PDF por categoria, que também é a forma mais rápida de descobrir se as imagens são seu problema, para começar
A deduplicação perceptual, a deduplicação exata de recursos e a auditoria de tamanho rodam sobre o mesmo grafo de objetos para Delphi, C++Builder e Free Pascal; a lista completa de recursos está na página da PDF Library for Delphi