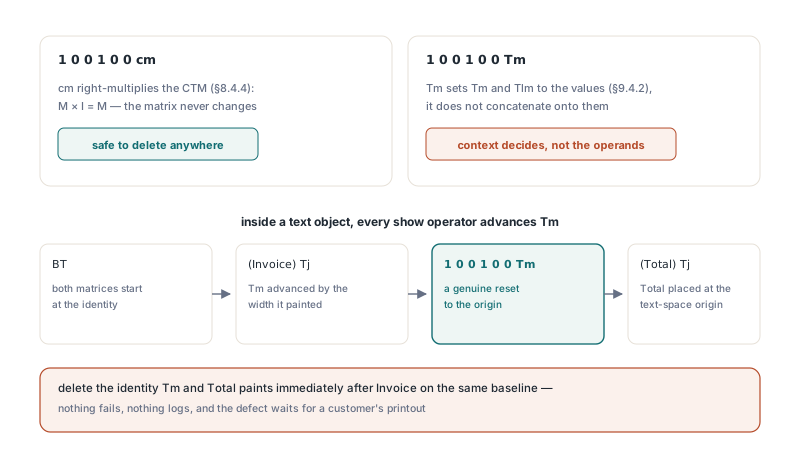
Pegue um content stream que um gerador de relatórios escreveria, BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET, e arranque o 1 0 0 1 0 0 Tm porque seus seis números soletram a matriz identidade. Renderize o resultado e "Total" não começa mais na origem do espaço de texto. Começa onde "Invoice" terminou, na mesma linha de base. Um Tm identidade é redundante só enquanto a matriz de texto e a matriz de linha de texto já guardam a identidade: direto depois de BT, ou direto depois de outro Tm identidade
A remoção é tentadora porque os mesmos seis números são de fato peso morto na frente de um cm. Um otimizador de content stream que trata os dois operadores igual vai encolher muitos streams corretamente. Então encontra um gerador que usa um Tm identidade como retorno de carro, e o texto se move
Por que 1 0 0 1 0 0 Tm nem sempre é um no-op?
Os dois operadores fazem aritmética diferente. A ISO 32000-1 §8.4.4 define o cm como concatenar seu operando com a matriz de transformação atual; multiplique qualquer matriz pela identidade e você recebe a mesma matriz de volta, então 1 0 0 1 0 0 cm pode ser deletado onde quer que apareça. O Tm é uma atribuição. Sob a §9.4.2 ele define tanto a matriz de texto quanto a matriz de linha de texto para seus operandos e joga fora o que quer que guardassem, então se ele muda algo depende inteiramente dos operadores na frente dele
A §9.4.1 diz que o BT começa as duas matrizes na identidade. A partir daí, quase tudo dentro de um objeto de texto move pelo menos uma delas. Td, TD, T* e um Tm não identidade reposicionam a matriz de linha de texto. Todo operador de exibição de texto (Tj, TJ, ' e ") avança a matriz de texto pela largura dos glifos que acabou de pintar, e os dois últimos começam uma linha nova antes. Uma vez que qualquer um deles rodou, um Tm identidade é um salto genuíno de volta à origem. O stream da fatura acima depende desse salto
Rastrear um stream à mão resolve rápido. Alimente o exemplo da fatura ao rastreador de estado de CTM e matriz de texto de content stream e o registro mostra o cm concatenando na CTM enquanto o Tm sobrescreve as duas matrizes de texto — duas regras de atualização diferentes escondidas atrás de operandos idênticos
How PDF Library for Delphi decides which identity Tm to drop
A PDF Library for Delphi derruba todo cm identidade durante sua passada peephole, e derruba um Tm identidade só quando uma varredura para trás a partir daquele operador alcança um BT ou outro Tm identidade antes de encontrar qualquer coisa que possa ter movido as matrizes de texto. O teste de "identidade" é numérico: o operador precisa de exatamente seis operandos numéricos iguais a 1, 0, 0, 1, 0, 0, então 1.0 0 0 1.0 0 0 Tm também se qualifica. Caminhando para trás, a varredura coloca cada operador que encontra em um de dois grupos:
- Parar e manter o Tm:
Td,TD,T*, umTmnão identidade,Tj,TJ,',",ET, qualquer operador que o parser não reconheça, ou o começo do stream - Passar por cima e seguir varrendo: operadores que nunca tocam a matriz de texto nem a matriz de linha de texto, como
Tf,Tc, definidores de cor,gs, operadores de marked-content,Doecm
Um Tm identidade anterior encerra a varredura em favor da remoção, quer o otimizador esteja mantendo-o ou já o tenha marcado para remoção. De qualquer forma ele deixou as duas matrizes na identidade, que é o mesmo estado que o BT deixa. É por isso que uma sequência de três operadores Tm identidade logo depois do BT colapsa para nada
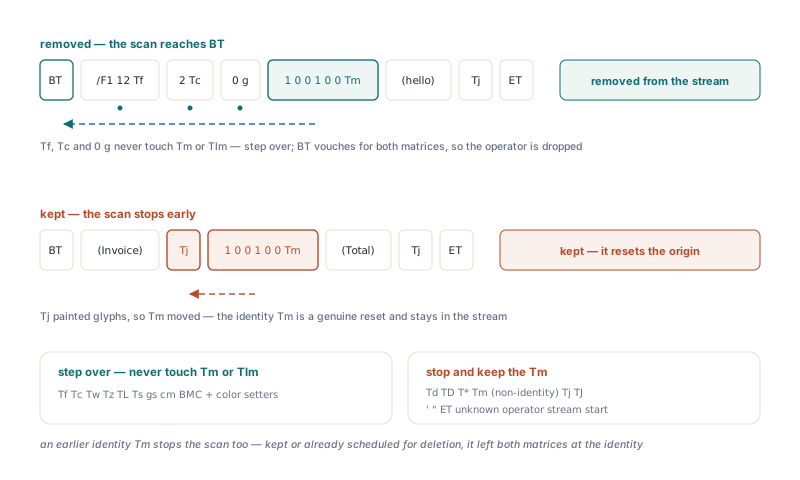
As paradas conservadoras são deliberadas. Um operador desconhecido pode ser uma extensão de fornecedor que faz qualquer coisa, então a varredura se recusa a raciocinar além dele. Depois de um ET não há objeto de texto aberto, e um Tm identidade sentado ali não tem nenhum BT atestando os valores das matrizes. A varredura também olha um content stream por vez. Isso importa para páginas cujo /Contents é um array: o PDF deixa um objeto de texto começar em um stream e continuar no seguinte, então uma camada que abre no meio de um objeto de texto, sem BT próprio, mantém seu Tm identidade mesmo quando a camada anterior o teria tornado redundante
Achamos que esse é o lado certo para errar. Rastrear matrizes através de fronteiras de stream, ou simular operadores desconhecidos, recuperaria talvez catorze bytes de texto não comprimido por arquivo estranho. Errar move um glifo em uma fatura impressa. O custo e o risco não estão na mesma liga
Um efeito colateral vale conhecer porque muda o que você vê na saída. A mesma passada também remove objetos de texto sem nada dentro, então BT 1 0 0 1 0 0 Tm ET desaparece por completo: o Tm identidade vai primeiro, e o par BT/ET que ele deixa para trás está vazio
Rodando o otimizador em um trecho de content stream
O otimizador trabalha sobre o mesmo modelo parseado TPDFContentProgram que você usaria para editar texto de página no nível de instrução, como na caminhada de mapeamento caractere para byte de conteúdo. Isso torna fácil experimentar a regra em uma string antes de confiar nela com um documento inteiro. O helper abaixo parseia um stream decodificado, roda o TPDFContentPeepholeOptimizer e emite o resultado com uma instrução por linha. Definir CanonicalNumbers antes do Parse espelha a passada do save, que reescreve todo número em uma precisão fixa
uses
  PDFlibContentModel, PDFlibContentOptimize;

function OptimizeSnippet(const Source: AnsiString): AnsiString;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
begin
  Result := Source;
  Prog := TPDFContentProgram.Create;
  try
    Prog.CanonicalNumbers := True; // mesmo tratamento de número da passada do save
    if not Prog.Parse(Source) then
      Exit; // dano estrutural grave: deixe os bytes em paz
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run; // devolve o número de instruções removidas
    finally
      Optimizer.Free;
    end;
    Result := Prog.Emit; // uma instrução por linha, separadas por #10
  finally
    Prog.Free;
  end;
end;

// Removido: Tm direto depois de BT, o segundo de dois Tm identidade em sequência
//   OptimizeSnippet('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET')
// Mantido: Tm depois de Td, depois de Tj, depois de um Tm não identidade, ou fora de BT
//   OptimizeSnippet('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET')
Rode o stream da fatura por ele e o Tm identidade sobrevive, porque a varredura para trás esbarra no Tj muito antes de alcançar o BT. Ponha /F1 12 Tf, 2 Tc e 0 g entre o BT e o Tm identidade e ele ainda vai embora, já que nenhum deles toca as matrizes de texto. O caso interessante é BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm. Ele perde exatamente um operador. O primeiro Tm identidade desfaz o movimento que o Td fez, e só o segundo é redundante
O Parse devolve False só em dano grave como uma string ou dicionário não terminado. Operadores desconhecidos parseiam bem e ficam no programa, onde agem como paradas duras para a varredura
Quando o otimizador peephole realmente roda?
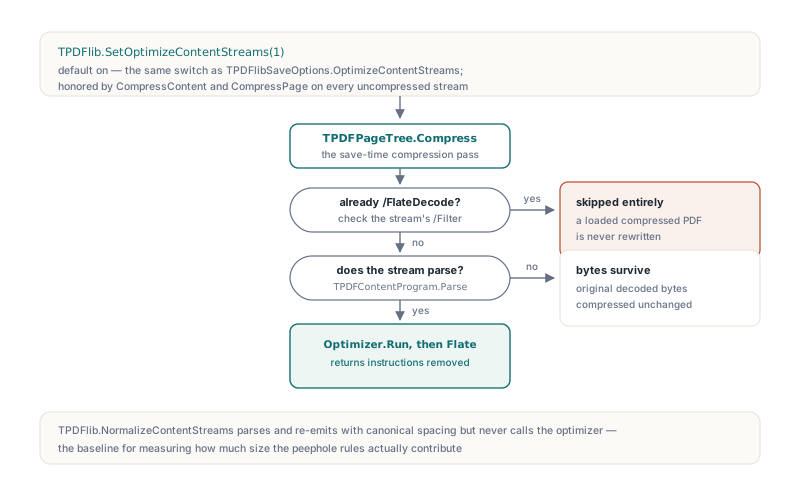
O otimizador roda só dentro da passada de compressão, e só em streams de conteúdo de página que ainda não estão comprimidos com Flate. O TPDFlib.SetOptimizeContentStreams(1) é o padrão, e o mesmo switch aparece como o campo OptimizeContentStreams de TPDFlibSaveOptions; o CompressContent e o CompressPage ambos o honram. Um stream cujo /Filter já é /FlateDecode é pulado por inteiro, então carregar um PDF comprimido típico e salvá-lo de novo deixa seus operadores exatamente como estavam. Streams gravados sem compressão são decodificados, otimizados e então comprimidos com Flate. Se um stream falha ao parsear, seus bytes originais decodificados são comprimidos sem mudança
var
  Lib: TPDFlib;
  Options: TPDFlibSaveOptions;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    // Streams de página não comprimidos passam pelas regras peephole, depois Flate
    Lib.SetOptimizeContentStreams(1);
    Lib.CompressContent;
    Lib.SaveToFile('report-optimized.pdf');

    // A mesma escolha pelas opções de save empacotadas; False desliga
    Options.CompressContent := True;
    Options.CompressFonts := True;
    Options.CompressImages := True;
    Options.Linearize := False;
    Options.KeepModDate := False;
    Options.OptimizeContentStreams := False;
    Options.GarbageCollect := False;
    Options.PackObjectStreams := True;
    Lib.SaveToFileOptions('report-plain.pdf', Options);
  finally
    Lib.Free;
  end;
end;
Deixe o padrão ligado. Toda transformação na passada é equivalente na saída, e a regra da matriz identidade vai atrás de um padrão que muitos geradores emitem, abrindo todo objeto de texto com BT 1 0 0 1 0 0 Tm. Desligá-la faz sentido principalmente quando você quer fazer diff da sua própria saída não comprimida contra o que escreveu, ou quando precisa de uma linha de base. Para essa linha de base, o TPDFlib.NormalizeContentStreams parseia e reemite conteúdo com espaçamento e números canônicos mas nunca chama o otimizador, então a diferença de tamanho entre um save normalizado e um save otimizado é o que as regras peephole contribuíram. Espere que seja modesto perto das vitórias maiores descritas em otimização de tamanho de arquivo PDF com subsetting de fontes
Um teste que cobre uma forma não define a regra
Um teste que alimenta BT 1 0 0 1 0 0 Tm (hello) Tj ET a um otimizador e assegura que nenhum Tm resta fixa uma forma: um Tm identidade direto depois de BT é removido. Ele não diz nada sobre um Tm identidade depois de um Td ou depois de texto exibido. Ler essa asserção única como "Tm identidade é sempre removível" é um erro fácil, e caro, porque a amostra passa dos dois jeitos. Testes para qualquer regra como essa precisam das formas mantidas escritas ao lado das removíveis
O helper abaixo conta os operadores Tm que sobrevivem, depois confere uma tabela de entradas. Troque o ExpectTm pela asserção do seu framework de teste; ele não faz parte da biblioteca
uses
  SysUtils, PDFlibContentModel, PDFlibContentOps, PDFlibContentOptimize;

function TmCountAfterOptimize(const Source: AnsiString): Integer;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
  I: Integer;
begin
  Result := -1; // -1 sinaliza falha de parse
  Prog := TPDFContentProgram.Create;
  try
    if not Prog.Parse(Source) then
      Exit;
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run;
    finally
      Optimizer.Free;
    end;
    Result := 0;
    for I := 0 to Prog.Count - 1 do
      if Prog[I].Op = coTextMatrix then
        Inc(Result);
  finally
    Prog.Free;
  end;
end;

// Seu próprio helper de checagem, sugerido aqui; troque por uma asserção real
procedure ExpectTm(const Source: AnsiString; Expected: Integer);
var
  Actual: Integer;
begin
  Actual := TmCountAfterOptimize(Source);
  if Actual <> Expected then
    raise Exception.CreateFmt('%s: expected %d Tm, got %d',
      [string(Source), Expected, Actual]);
end;

procedure CheckIdentityTmRule;
begin
// Formas removíveis
  ExpectTm('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET', 0);
  ExpectTm('BT 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  ExpectTm('BT /F1 12 Tf 2 Tc 0 g 1 0 0 1 0 0 Tm (a) Tj ET', 0);
// Formas que devem manter o Tm identidade
  ExpectTm('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET', 1);
  ExpectTm('BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 1);
  ExpectTm('BT 2 0 0 2 5 5 Tm (a) Tj 1 0 0 1 0 0 Tm (b) Tj ET', 2);
  ExpectTm('1 0 0 1 0 0 Tm (a) Tj', 1);    // sem BT envolvendo
  ExpectTm('BT ET 1 0 0 1 0 0 Tm', 1);     // depois de ET
end;
As duas últimas linhas parecem bobas até você lembrar que arrays /Contents em camadas produzem exatamente esses fragmentos. Um stream que começa no meio de um objeto de texto não tem BT, e um Tm identidade depois de um ET não pertence a objeto de texto algum. Ambos ficam. O par BT ET vazio na linha final é removido pela regra de objeto de texto vazio, que é por que a contagem confere operadores Tm em vez de comparar strings inteiras
O que a regra abre mão é o Tm identidade ocasional no meio de um objeto de texto, alguns bytes por página antes de o Flate sequer vê-los. O que ela compra é uma garantia sobre a qual o design do otimizador descansa: nenhuma transformação na passada muda a página visível. Um otimizador de tamanho que move texto é um bug de renderização com uma boa taxa de compressão
Se você gera ou pós-processa conteúdo PDF no Delphi ou no C++Builder, a PDF Library for Delphi and C++Builder traz o parser de content stream, essa passada peephole e as opções de save mostradas acima, junto com o NormalizeContentStreams para produzir uma linha de base limpa e não otimizada para comparação