Considere um arquivo cujo information dictionary declara /Title (Annual Maintenance Report) enquanto o pacote XMP dele não tem dc:title algum. Os visualizadores mostram o título sem reclamar, mas um validador PDF/A rejeita o arquivo porque as duas cópias de metadados discordam. Um segundo arquivo parece igualmente saudável mas não tem entrada pdfaid:part no XMP dele, e o validador responde com dezenas de erros: ele julga o arquivo como um PDF comum e reporta cada regra da parte reivindicada como falha, tudo por causa de uma linha ausente
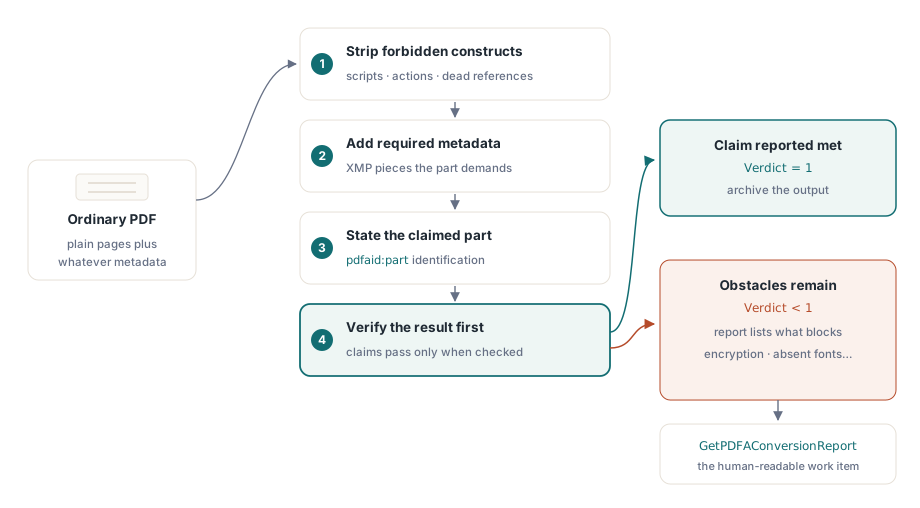
Os dois problemas pedem quantidades de trabalho muito diferentes. Conciliar metadados é um conserto estreito que você pode rodar em qualquer arquivo. Transformar um PDF qualquer em um documento de arquivamento significa remover o que a parte alvo proíbe, adicionar o que ela exige, declarar a reivindicação e então validar os bytes que de fato saíram. Construímos a conversão em torno dessa última etapa de propósito. O ConvertToPDFA, que vem na edição Enterprise (TPDFlibEnterprise) junto com o GetPDFAConversionReport, salva o documento convertido em memória, roda a checagem PDF/A sobre esses bytes e retorna 1 apenas quando a checagem passa
Por que um PDF que abre bem reprova em uma checagem PDF/A?
As duas falhas vêm de regras de metadados. Um PDF registra título, autor, produtor e datas no document information dictionary, e o PDF/A também exige os mesmos fatos em um pacote de metadados XMP; a ISO 19005-1 §6.7.3 pede que os dois sejam equivalentes, e PDF/A-2 e PDF/A-3 mantêm a regra. Entre os arquivos que reprovam nessa regra, o padrão usual é um produtor que preencheu o information dictionary e nunca escreveu a metade XMP, então o validador encontra um título em um lugar e nada no outro
A identificação ausente é mais silenciosa. As entradas pdfaid:part e pdfaid:conformance são o que marca um arquivo como PDF/A, e um arquivo pode ser perfeitamente bem formado sem elas. O caso que mais vemos é uma aplicação que fornece o próprio pacote XMP dela, substituindo o que o escritor de PDF gerou; o pacote personalizado carrega os campos da aplicação e nenhuma entrada pdfaid, então a lista de erros não aponta nem perto da causa real
O RepairDocumentMetadata trata os dois casos e retorna o número de entradas que mudou. Ele está disponível em todas as edições, assim como o SetPDFAMode e o SanitizeDocument. O reparo percorre Title, Author, Subject, Keywords, Creator, Producer, CreationDate e ModDate. Onde só o XMP carrega um valor, o information dictionary é preenchido a partir dele, então nada já registrado é jogado fora. Onde ambos carregam valores e eles diferem, o information dictionary vence. Fizemos essa escolha porque o information dictionary é a metade que os produtores mais definem, o que o torna o registro mais provável do que o autor pretendia
Se o seu XMP é a cópia autoritativa (digamos que foi curado em um sistema de gestão documental), empurre os valores que você quer para o information dictionary com SetInformation e só depois rode o reparo. Fazer ao contrário vai sobrescrever o título curado do seu XMP com o que o produtor original escreveu
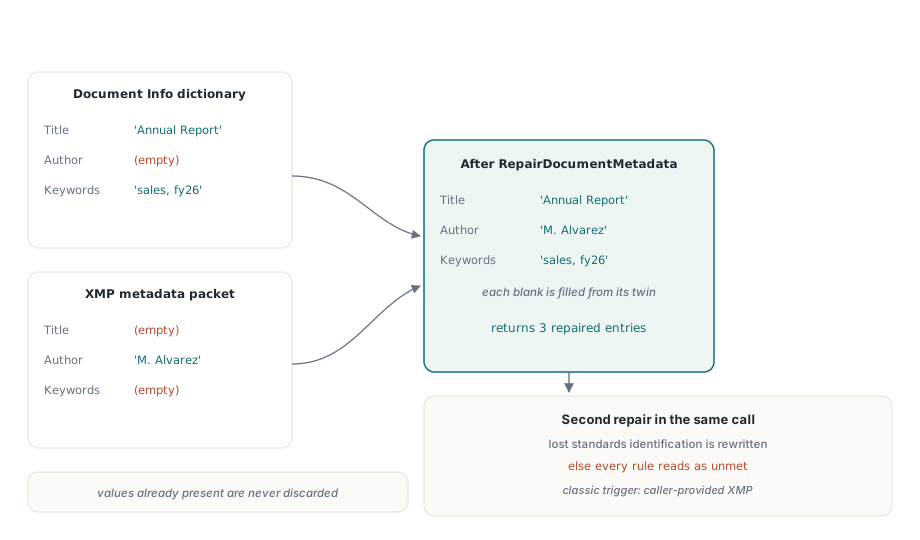
O reparo de identificação precisa de uma coisa sua: o documento tem de saber qual parte ele almeja. Um arquivo recém-carregado não tem modo PDF/A definido, então chame o SetPDFAMode antes do reparo. Com um modo no lugar, o RepairDocumentMetadata grava as entradas pdfaid correspondentes, adiciona pdfaid:rev com o ano 2020 para os modos da parte 4, e define dc:format como application/pdf, que os validadores também conferem
uses
  SysUtils, PDFlibrary;

procedure RepairIncoming(const InName, OutName: string);
var
  Lib: TPDFlib;
  Fixed: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InName]);

    // O título curado entra no information dictionary primeiro,
    // porque essa cópia vence quando as duas metades discordam
    Lib.SetInformation(2, 'Annual Maintenance Report 2025');

    Lib.SetPDFAMode(3);                  // 3 = PDF/A-2b, veja a tabela abaixo
    Fixed := Lib.RepairDocumentMetadata;
    Writeln(Format('%d metadata entries brought into agreement', [Fixed]));

    Lib.SaveToFile(OutName);
  finally
    Lib.Free;
  end;
end;
Escolhendo a parte alvo e o número de modo dela
Escolha a parte pelo que o documento precisa carregar, e só depois procure o número. O SetPDFAMode e o ConvertToPDFA compartilham um único esquema de numeração, e ele não corre na ordem que os nomes das partes sugerem
| Modo | Parte e nível | Notas |
|---|---|---|
| 1 | PDF/A-1a | PDF 1.4, com tags |
| 2 | PDF/A-1b | PDF 1.4 |
| 3 | PDF/A-2b | PDF 1.7 |
| 4 | PDF/A-2a | PDF 1.7, com tags |
| 5, 6, 7 | PDF/A-3b, 3a, 3u | Arquivos embutidos de qualquer tipo permitidos |
| 8 | PDF/A-2u | PDF 1.7, texto Unicode exigido |
| 9, 10, 11 | PDF/A-4, 4e, 4f | PDF 2.0; 4e adiciona 3D e rich media, 4f permite arquivos embutidos |
O modo 3 é PDF/A-2b e o modo 4 é PDF/A-2a. Essa inversão pega quem conta a partir do 1a e assume que o nível a sempre vem primeiro. O PDF/A-2u aparece no 8, depois dos modos da parte 3
A escolha com consequências reais é sobre anexos. As partes 1 e 2 proíbem arquivos embutidos, então o ConvertToPDFA os remove para os modos 1 a 4 e o modo 8. Converta uma fatura Factur-X ou ZUGFeRD para o modo 3 e o XML estruturado da fatura some da saída, junto com a razão de o arquivo existir. Para qualquer coisa que carregue um anexo, mire o modo 5 (PDF/A-3b), que também é a parte em que esses formatos de fatura são definidos, ou o modo 11 se você precisa de PDF 2.0. Todo anexo em um arquivo da parte 3 ou da parte 4 precisa declarar como se relaciona com o documento via /AFRelationship, e a PDF Library for Delphi grava essa entrada para cada arquivo embutido que ela salva nesses modos
A parte 4 se identifica de jeito diferente. Ela não tem letra de conformidade para o PDF/A-4 simples, usa E ou F para as duas extensões, e exige pdfaid:rev com o ano em que a parte foi publicada. O ConvertToPDFA eleva o arquivo a PDF 2.0 para os modos 9 a 11, porque a ISO 19005-4 §6.1.2 constrói a parte sobre o PDF 2.0, e a checagem julga tais arquivos contra o PDF 2.0 em vez do 1.7
O que o ConvertToPDFA muda no arquivo
O ConvertToPDFA faz uma sequência fixa de reparos, anota cada um em um relatório em texto puro, salva o resultado em memória e valida esses bytes. Uma checagem reprovada retorna 0, e um modo fora de 1 a 11 também, retornando antes que qualquer relatório seja escrito. A sequência vale a pena conhecer, porque cada passo é algo que a saída vai perder ou ganhar:
- Um documento criptografado cuja senha é desconhecida para a conversão de imediato com uma linha
blocked:; nada dentro dele pode ser lido, quanto menos reparado - JavaScript de nível de documento e a open action que o executa são removidos, junto com toda entrada de additional-actions e os tipos de ação que nenhuma parte permite, entre eles Launch, Sound, Movie, ResetForm, ImportData, Hide, SetOCGState, Rendition e Trans. Links GoTo e URI ficam, então a navegação continua funcionando
- Arquivos embutidos são removidos para as partes que os proíbem, como descrito acima
- Anotações ocultas ou definidas para nunca exibir são apagadas. O PDF/A exige que anotações sejam visíveis e imprimíveis, e revelá-las mudaria a aparência da página, então escolhemos a remoção
- Aparências de campos de formulário são regeneradas antes que a flag
/NeedAppearancesseja limpa, então os valores preenchidos continuam visíveis - Fontes usadas mas não embutidas são embutidas a partir das fontes instaladas na máquina
- Objetos que nada mais referencia são descartados, e um output intent sRGB é adicionado se o arquivo não tiver um
- Por fim a parte e o nível são declarados no XMP, e os bytes são conferidos
Em um servidor, o passo das fontes é o que mais provavelmente trava uma conversão. Um documento que usa uma fonte que não existe em lugar nenhum na máquina de conversão não pode ser reparado de dentro do arquivo, e o relatório vai dizer isso. Instale as fontes que seus documentos de fato usam na máquina de conversão; o passo a passo sobre embutir fontes ausentes em um PDF existente cobre esse passo isoladamente
Como um job em lote deve tratar uma conversão que falha?
Trate o valor de retorno como um portão e o relatório como a ordem de serviço. Arquive os arquivos que retornam 1, e encaminhe o resto para uma pessoa com o relatório anexado. Não salve a saída de uma conversão falhada no arquivo morto só porque ela parece mais limpa que a entrada. Aquele arquivo agora carrega uma reivindicação PDF/A que a checagem se recusou a confirmar, que é exatamente a situação que a etapa de verificação existe para impedir
O relatório do GetPDFAConversionReport é uma linha por ação, cada uma começando com um verbo: removed:, regenerated:, repaired:, embedded:, added:, stated:, mais blocked: se algo parou a execução, e uma linha final result:. A checagem por trás do veredito para na primeira falha, então quando um arquivo reprova, a conversão roda a checagem de novo por completo e o relatório mostra todos os problemas de uma vez. Roteamento pelos prefixos leva algumas linhas
uses
  Classes, SysUtils, PDFlibrary, PDFlibEnterprise;

function ArchiveOne(const InName, ArchiveDir, ReviewDir: string): Boolean;
var
  Lib: TPDFlibEnterprise;
  Report: TStringList;
  I: Integer;
  Blocked: Boolean;
begin
  Result := False;
  Lib := TPDFlibEnterprise.Create;
  Report := TStringList.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      Exit;
    Result := Lib.ConvertToPDFA(5) = 1;      // 5 = PDF/A-3b, mantém anexos
    Report.Text := Lib.GetPDFAConversionReport;
    if Result then
      Lib.SaveToFile(IncludeTrailingPathDelimiter(ArchiveDir) + ExtractFileName(InName))
    else
    begin
      Blocked := False;
      for I := 0 to Report.Count - 1 do
        if Pos('blocked:', Report[I]) = 1 then
          Blocked := True;
      // Mantenha o original intocado; só o relatório viaja com ele
      Report.SaveToFile(IncludeTrailingPathDelimiter(ReviewDir) +
        ChangeFileExt(ExtractFileName(InName), '.pdfa-report.txt'));
      if Blocked then
        Writeln(InName, ': needs a password or a rebuilt source file');
    end;
  finally
    Report.Free;
    Lib.Free;
  end;
end;
Uma linha blocked: normalmente significa que o conserto fica fora do PDF: uma senha, um arquivo de origem diferente, ou uma nova execução do que produziu o documento. Problemas de validação simples depois de uma conversão completa costumam ser conteúdo que carrega significado e não pode simplesmente ser apagado, e esses são os casos em que uma pessoa precisa decidir
Lendo a marca PDF/A que um arquivo já carrega
Antes de converter, confira o que o documento já reivindica sobre si mesmo. Arquivos que chegam de scanners, suítes de escritório e outras ferramentas PDF frequentemente já carregam uma marca PDF/A, e reconverter um PDF/A-3 válido para a parte 2 custaria os anexos dele à toa
A armadilha é que o XMP permite que a mesma propriedade seja escrita de duas formas. Alguns produtores escrevem a parte como elemento filho, <pdfaid:part>2</pdfaid:part>; outros escrevem como atributo em rdf:Description, pdfaid:part="2". Ambas são XMP ordinário e válido. Um detector que procura só uma forma decide que arquivos da outra família de produtores não carregam marca, e um verificador construído assim acaba julgando um PDF/A-2 válido contra a parte 1 e reportando-o como sem marca e de versão de PDF alta demais, o exato oposto da verdade. O validador na PDF Library for Delphi lê as duas formas. Se você fareja a marca por conta própria, faça o mesmo:
function DeclaredPDFAPart(Lib: TPDFlib): string;
const
  ElemTag = '<pdfaid:part>';
  AttrDQ  = 'pdfaid:part="';
  AttrSQ  = 'pdfaid:part=''';
var
  Packet: string;
  P: Integer;
begin
  Result := '';
  Packet := Lib.GetDocumentMetadata;
  P := Pos(ElemTag, Packet);                   // forma elemento
  if P > 0 then
    Exit(Copy(Packet, P + Length(ElemTag), 1));
  P := Pos(AttrDQ, Packet);                    // forma atributo, aspas duplas
  if P = 0 then
    P := Pos(AttrSQ, Packet);                  // forma atributo, aspas simples
  if P > 0 then
    Result := Copy(Packet, P + Length(AttrDQ), 1);
end;
Um resultado vazio significa nenhuma marca em nenhuma das formas. Um dígito diz qual parte o produtor quis, e esse é o número a comparar com o seu alvo antes de decidir se converte ou não
Higienizando scripts antes de o arquivo entrar no acervo
Conversão de arquivamento e higienização de segurança normalmente rodam juntas, já que o conteúdo que uma política de segurança quer fora se sobrepõe bastante ao que o PDF/A proíbe. O SanitizeDocument recebe uma máscara de bits de flags SANITIZE_* e retorna quantas remoções aplicou. O próprio ConvertToPDFA o chama com SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION como primeiro passo
Um detalhe importa aos validadores. Scripts de nível de documento vivem em uma árvore de nomes /JavaScript sob o dicionário /Names do catálogo, e quando o último script é removido a árvore agora vazia é removida com ele. Uma árvore vazia ainda anuncia que o documento tem scripts, e alguns verificadores reagem à chave em si sem contar o que há sob ela
Seja qual for a ferramenta que higienizou, verifique o arquivo salvo com uma carga nova em vez de confiar no estado em memória. Reabri-lo é barato:
var
  Lib, Check: TPDFlib;
begin
  Lib := TPDFlib.Create;
  Check := TPDFlib.Create;
  try
    Lib.LoadFromFile('upload.pdf', '');
    Lib.SanitizeDocument(SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION);
    Lib.SaveToFile('upload-clean.pdf');

    Check.LoadFromFile('upload-clean.pdf', '');
    if Check.GlobalJavaScriptCount > 0 then
      raise Exception.Create('Document-level scripts survived the save');
  finally
    Check.Free;
    Lib.Free;
  end;
end;
Para os passos vizinhos em um pipeline de arquivamento, veja os guias de preflight PDF/A e PDF/UA, redaction verdadeiro e remoção de conteúdo, e schemas de extensão XMP do PDF/A-3 para Factur-X, que retoma o lado de metadados quando um documento arquivado também carrega dados de fatura estruturados
Toda a conversão, reparo de metadados e validação mostrados aqui rodam dentro do seu próprio processo Delphi, C++Builder ou Lazarus, sem conversor externo nem validador de linha de comando na cadeia. A página do produto PDF Library for Delphi lista as partes PDF/A, edições e plataformas alvo