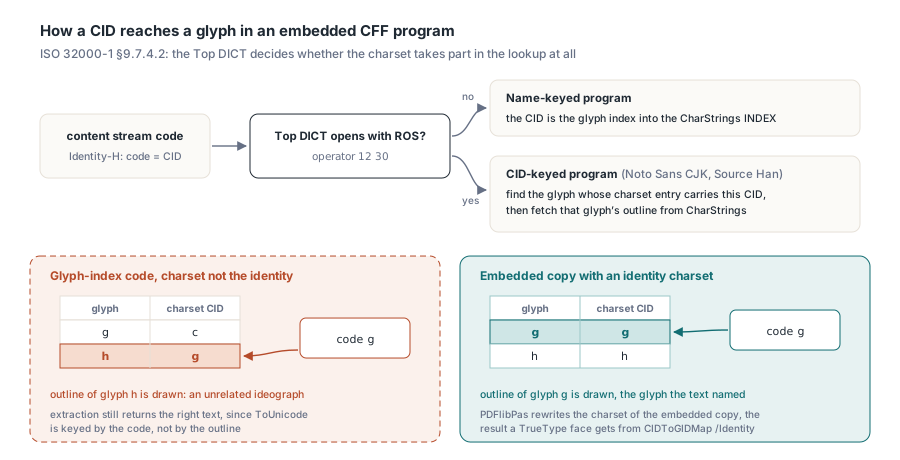
Uma fatura chinesa composta em Noto Sans SC a partir do arquivo .otf dela pode abrir no mutool com ideogramas sem relação nenhuma onde deveria estar o nome do cliente, enquanto uma fonte TrueType renderiza a mesma página corretamente. A causa é o CFF charset da fonte; o PDFlibPas o regrava para o identity na cópia incorporada, e os códigos de índice de glifo chegam aos glifos pretendidos
Se uma fonte apresenta o problema depende de como ela foi construída. Um programa TrueType incorporado como fonte CIDFontType2 recebe um CIDToGIDMap Identity, e o código no content stream cai no glifo pretendido. A maioria das fontes OpenType latinas com contornos CFF é name-keyed, e um programa CFF name-keyed usa o CID recebido diretamente como índice de glifo. A ISO 32000-1 até observa, em §9.7.4.2, que CID e GID coincidem em muitas fontes. Mas não em todas. As grandes famílias CJK construídas como fontes CID-keyed — Noto Sans CJK e suas irmãs Source Han entre elas — carregam numeração de CID própria, e um writer que manda índices de glifo direto nessa numeração recebe o glifo que por acaso é dono do CID correspondente
O que um programa CFF CID-keyed faz com um CID
A ISO 32000-1 §9.7.4.2 divide os programas CFF incorporados em dois casos olhando o Top DICT. Se o Top DICT usa os operadores CIDFont — na prática, ele abre com ROS (operador 12 30: registry, ordering, supplement) — o reader pega o CID do content stream, localiza o glifo cuja entrada de charset carrega esse CID e só então busca o contorno no CharStrings INDEX. Sem operadores CIDFont, o CID é o próprio índice de glifo; o charset não participa. Qualquer reader que seguir §9.7.4.2 como escrito vai desenhar o glifo errado para um código de índice de glifo sempre que o charset não for o identity, não importa qual viewer você abra. O charset em si, definido no Adobe Technical Note #5176, vem em três layouts com dois casos especiais:
- Format 0 armazena um SID ou CID de 2 bytes por glifo, na ordem de glifos
- Format 1 armazena faixas: um primeiro CID seguido de uma contagem de 1 byte dos glifos que o seguem com CIDs consecutivos
- Format 2 é o mesmo layout de faixa com uma contagem de 2 bytes, o que serve para fontes com sequências longas contínuas
- O glifo 0 é o
.notdefe não tem entrada em nenhum formato; um offset de charset de 0, 1 ou 2 nomeia um dos charsets predefinidos em vez de apontar para dados
Então comece descobrindo que tipo de fonte você tem. Identity-H do lado do PDF só diz que um código de 2 bytes é igual ao CID. Como esse CID chega a um glifo vive inteiramente dentro do programa de fonte. A função abaixo lê a tabela CFF de um .otf, percorre o Top DICT atrás de ROS e verifica se o charset mapeia cada glifo para um CID de mesmo número. Ela precisa apenas da RTL
uses
  System.SysUtils, System.IOUtils;

type
  TCFFCharsetReport = record
    IsCFF, CIDKeyed, IdentityCharset: Boolean;
    CharsetFormat, GlyphCount: Integer;
  end;

{$RANGECHECKS ON}  // um arquivo truncado levanta ERangeError em vez de ser lido errado
function InspectOtfCharset(const FileName: string): TCFFCharsetReport;
var
  B: TBytes;
  NumTables, I, Cff, P, Dict, DictEnd, Unused1, Unused2: Integer;
  Op, Operand, CharsetOfs, CharStringsOfs, G, Left: Integer;

  function BE(Pos, Count: Integer): Integer;
  var
    K: Integer;
  begin
    Result := 0;
    for K := 0 to Count - 1 do
      Result := (Result shl 8) or B[Pos + K];
  end;

  // Devolve o fim do INDEX em Pos e demarca o primeiro objeto dele
  function SkipIndex(Pos: Integer; out ObjStart, ObjEnd: Integer): Integer;
  var
    Count, OffSize, Base: Integer;
  begin
    Count := BE(Pos, 2);
    if Count = 0 then
    begin
      ObjStart := Pos + 2;
      ObjEnd := ObjStart;
      Exit(Pos + 2);
    end;
    OffSize := B[Pos + 2];
    Base := Pos + 2 + (Count + 1) * OffSize;  // os offsets são 1-based daqui em diante
    ObjStart := Base + BE(Pos + 3, OffSize);
    ObjEnd := Base + BE(Pos + 3 + OffSize, OffSize);
    Result := Base + BE(Pos + 3 + Count * OffSize, OffSize);
  end;

begin
  Result := Default(TCFFCharsetReport);
  Result.CharsetFormat := -1;
  B := TFile.ReadAllBytes(FileName);
  if (Length(B) < 12) or (BE(0, 4) <> $4F54544F) then  // 'OTTO'
    Exit;
  Cff := -1;
  NumTables := BE(4, 2);
  for I := 0 to NumTables - 1 do
    if BE(12 + I * 16, 4) = $43464620 then               // 'CFF '
      Cff := BE(12 + I * 16 + 8, 4);
  if Cff < 0 then
    Exit;
  Result.IsCFF := True;
  P := SkipIndex(Cff + B[Cff + 2], Unused1, Unused2);    // Name INDEX
  SkipIndex(P, Dict, DictEnd);                           // Top DICT INDEX
  Operand := 0;
  CharsetOfs := 0;
  CharStringsOfs := 0;
  P := Dict;
  while P < DictEnd do
  begin
    Op := B[P];
    case Op of
      12:
        begin
          if B[P + 1] = 30 then
            Result.CIDKeyed := True;                     // ROS
          Inc(P, 2);
        end;
      0..11, 13..21:
        begin
          if Op = 15 then
            CharsetOfs := Operand
          else if Op = 17 then
            CharStringsOfs := Operand;
          Inc(P);
        end;
      28: begin Operand := SmallInt(BE(P + 1, 2)); Inc(P, 3); end;
      29: begin Operand := BE(P + 1, 4); Inc(P, 5); end;
      30:
        begin                                            // número real
          repeat
            Inc(P);
          until ((B[P] and $F) = $F) or ((B[P] shr 4) = $F);
          Inc(P);
        end;
      32..246: begin Operand := Op - 139; Inc(P); end;
      247..250: begin Operand := (Op - 247) * 256 + B[P + 1] + 108; Inc(P, 2); end;
      251..254: begin Operand := -(Op - 251) * 256 - B[P + 1] - 108; Inc(P, 2); end;
    else
      Exit;                                              // byte reservado
    end;
  end;
  if (not Result.CIDKeyed) or (CharsetOfs <= 2) or (CharStringsOfs <= 0) then
    Exit;
  Result.GlyphCount := BE(Cff + CharStringsOfs, 2);
  P := Cff + CharsetOfs;
  Result.CharsetFormat := B[P];
  if Result.CharsetFormat > 2 then
    Exit;
  Inc(P);
  Result.IdentityCharset := True;
  G := 1;                                                // .notdef não tem entrada
  while G < Result.GlyphCount do
  begin
    if BE(P, 2) <> G then
      Result.IdentityCharset := False;
    case Result.CharsetFormat of
      0: Left := 0;
      1: Left := B[P + 2];
    else
      Left := BE(P + 2, 2);
    end;
    Inc(P, Result.CharsetFormat + 2);
    Inc(G, Left + 1);
  end;
end;
Um relatório com CIDKeyed = True e IdentityCharset = False descreve a fonte deste artigo: qualquer writer que põe índices de glifo no content stream sem considerar esse charset vai desenhar os glifos errados com ela. Um resultado name-keyed, ou uma fonte CID-keyed cujo charset por acaso já é o identity, renderiza corretamente sob o mesmo writer. É assim que uma fonte CJK em um produto funciona e a seguinte não. O loop compara apenas o primeiro CID de cada faixa, e isso basta: uma faixa cobre glifos consecutivos carregando CIDs consecutivos, então uma faixa que começa no próprio índice de glifo fica nele até o fim
Os índices de glifo atravessam todo o dicionário de fonte
Um writer PDF raramente tem CIDs em mãos. A tabela cmap e o shaping engine devolvem ambos índices de glifo, então o design natural escreve esses índices como códigos Identity-H de 2 bytes e chaveia todo o resto neles: o array de larguras /W, o bitmap /CIDSet que o PDF/A pede e o ToUnicode CMap que permite à extração recuperar o texto de origem. O TrueType tem uma válvula de escape. A Tabela 117 oferece o CIDToGIDMap, mas só para CIDFonts Type 2; um programa CFF mora em uma fonte CIDFontType0, que não tem como redirecionar um CID do lado do PDF. Isso também descarta um truque que alguns writers usam com TrueType — dar a um glifo reutilizado um segundo CID "alias" depois do fim da fonte, para que o ToUnicode possa ligar textos diferentes a cada uso. Em uma fonte CFF esse alias não seleciona glifo nenhum, e o mutool informa que não consegue renderizá-lo. Fontes que mapeiam U+4E00 e U+2F00 (KANGXI RADICAL ONE) para um único contorno são o caso comum. Se o documento precisa que os dois sejam extraídos de forma diferente, envolva a ocorrência em um span de marked-content com /ActualText (ISO 32000-1 §14.9.4), que o reader usa no lugar do mapeamento da fonte
Regravando o charset no lugar
Há dois caminhos para reconciliar códigos de índice de glifo com um programa CID-keyed. Um traduz cada índice de glifo para o CID da fonte antes de escrevê-lo, o que mexe nos códigos do content stream, nas chaves do /W, nas posições de bit do /CIDSet, nos códigos de origem do ToUnicode e em todo subset gerado ao salvar. O outro muda a única estrutura em desacordo, o charset, para que a fonte responda a índices de glifo do jeito que um programa name-keyed responderia. O segundo caminho é o mais seguro. O shaper, a tabela de larguras, o subsetter e o construtor de ToUnicode continuam trabalhando em espaço de glifo, e o único código que precisa entender CIDs é uma rotina curta que roda uma vez sobre a cópia incorporada da fonte. O PDFlibPas segue esse caminho
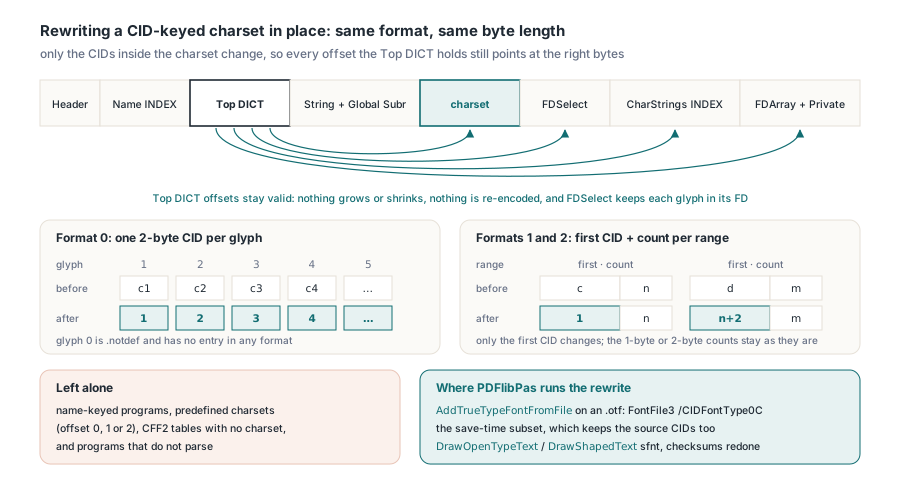
A regravação preserva o formato do charset e o comprimento em bytes dele. No format 0, cada entrada é sobrescrita com o próprio índice de glifo dela. Nos formats 1 e 2, só o primeiro CID de cada faixa muda, e as contagens ficam como estão. Nada cresce ou encolhe. Os offsets do Top DICT para CharStrings, os Private DICTs, FDArray e FDSelect continuam válidos sem re-encoder nada, e o FDSelect — que atribui dicionários de hinting por índice de glifo — mantém cada glifo no FD original dele. Programas name-keyed, charsets predefinidos, tabelas CFF2 (que não têm charset) e programas que não parseiam ficam intocados. Três caminhos de código executam a regravação:
- O
AddTrueTypeFontFromFileem um.otfincorpora a tabelaCFFpura comoFontFile3com subtypeCIDFontType0C, com o charset já regravado - O subset gerado ao salvar mantém os índices de glifo originais, mas também os CIDs de origem, então o charset dele é regravado uma segunda vez
- O companheiro de shaping por trás do
DrawOpenTypeTexte doDrawShapedTextmantém o sfnt inteiro; após a regravação o checksum da tabelaCFFé recalculado, e ocheckSumAdjustmentda tabelaheadvira0xB1B0AFBAmenos a soma do arquivo - Esse ajuste só está definido para uma fonte única, então uma fonte tirada de uma coleção fica só com o checksum de tabela
uses
  SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    // Um .otf com contornos CFF é incorporado como FontFile3 /CIDFontType0C;
    // a cópia incorporada recebe um charset identity quando é CID-keyed
    FontID := Lib.AddTrueTypeFontFromFile('C:\Fonts\NotoSansSC-Regular.otf');
    if FontID = 0 then
      raise Exception.Create('the font file could not be read or parsed');
    Lib.SetTextSize(18);
    Lib.DrawText(56, 760, '季度报表:华东区销售汇总');
    Lib.DrawText(56, 730, '发票号码 2026-11-0187,金额 ¥12,480.00');
    if Lib.SaveToFile('noto-sc.pdf') <> 1 then
      raise Exception.CreateFmt('save failed, error %d', [Lib.LastErrorCode]);
  finally
    Lib.Free;
  end;
end;
Confira a saída renderizando-a. A extração não mostra o problema. O pdftotext e todo outro extrator leem o ToUnicode, que é chaveado pelo código no content stream e não sabe nada sobre qual contorno a fonte escolhe para ele, então uma página exibindo os ideogramas errados ainda extrai a string certa. O mutool draw -r 150 -o page%d.png noto-sc.pdf mostra como a página realmente fica, e para esse caminho DrawText o pdffonts noto-sc.pdf do poppler deve listar a fonte como CID Type 0C. Esperado: as duas linhas renderizam em Noto Sans SC com os glifos que o texto de origem nomeia, e a mesma saída aparece no Ghostscript
Qual forma de incorporação pede PDF 1.6?
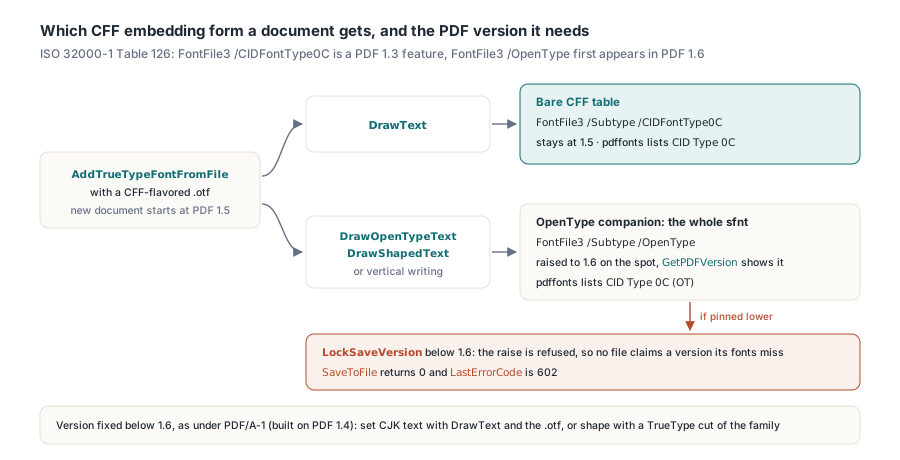
A do OpenType. A Tabela 126 da ISO 32000-1 lista um stream FontFile3 de subtype CIDFontType0C como recurso do PDF 1.3, enquanto o subtype OpenType — o sfnt inteiro com a tabela CFF dele — aparece pela primeira vez no PDF 1.6. Documentos PDFlibPas novos começam na versão 1.5, na qual o caminho DrawText de CFF puro cabe. A primeira chamada DrawOpenTypeText, DrawShapedText ou de escrita vertical com uma fonte CFF cria um companheiro OpenType e eleva o documento para 1.6 na hora, o que o GetPDFVersion informa imediatamente. Um lock de versão muda isso. Se o LockSaveVersion fixou o documento em um valor mais baixo, a elevação é recusada e o SaveToFile retorna 0 com LastErrorCode 602, para que nenhum arquivo reclame uma versão que as fontes dele não atendem. Quando um perfil de entrega trava a versão abaixo de 1.6 — PDF/A-1 sendo o caso comum, já que se apoia no PDF 1.4 —, defina texto CJK via DrawText com o .otf, ou use um corte TrueType da família para tudo que precisar de shaping
var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Writeln('before: ', Lib.GetPDFVersion);      // Esperado: 1.5
    if Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0) = 1 then
      Writeln('after: ', Lib.GetPDFVersion);     // Esperado: 1.6
    Lib.SaveToFile('shaped.pdf');  // Esperado no pdffonts: CID Type 0C (OT)
  finally
    Lib.Free;
  end;

  Lib := TPDFlib.Create;
  try
    Lib.LockSaveVersion('1.5');
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0);
    if Lib.SaveToFile('locked.pdf') = 0 then
      Writeln('save refused, error ', Lib.LastErrorCode);  // Esperado: 602
  finally
    Lib.Free;
  end;
end;
Larguras e ToUnicode chaveados pelos mesmos números
Quando o charset é o identity, o CID, o índice de glifo e o código do content stream são um só número. As larguras o acompanham. A ISO 32000-1 §9.7.4.3 indexa o /W pelo próprio CID, em grupos de um CID inicial seguido de um array de larguras ou de um primeiro CID, um último CID e uma largura compartilhada, sem offset /FirstChar do tipo que fontes simples usam. Qualquer CID que o array deixar de fora recebe o /DW, e a Tabela 117 define o default do /DW como 1000. Zero está errado. Um reader que recai em 0 para CIDs não listados colapsa uma linha de ideogramas sobre si mesma. Para um .otf carregado via AddTrueTypeFontFromFile, o PDFlibPas escreve um array /W que começa no CID 0 e lista o advance de cada glifo, ao lado de um /DW 1000 explícito. Do lado da leitura, texto CJK que sai como lixo na extração normalmente erra na metade codespace desse mesmo pipeline, e uma auditoria de fontes PDF/UA de larguras, CharSet e CIDSet confronta esses arrays com o programa incorporado
O ToUnicode tem uma regra de numeração própria. Uma entrada bfrange armazena apenas a primeira string de destino, e a §9.10.3 exige que o último byte dela não seja empurrado além de 255 pelo comprimento da faixa, porque um reader gera os destinos seguintes incrementando apenas esse último byte. Glifos consecutivos mapeados para U+4EFE, U+4EFF, U+4F00 e U+4F01 parecem uma faixa única — e não são: um reader decodificaria o terceiro como U+4E00. O writer do PDFlibPas mescla pares vizinhos de glifo-para-Unicode em um bfrange só quando os códigos de origem e os destinos ficam dentro de um mesmo bloco de 256, e divide a sequência caso contrário. A composição CJK vertical passa pelas mesmas fontes companheiras, então o texto vertical em japonês e chinês herda o charset identity e essas faixas ToUnicode sem chamadas extras
Toda fonte que o InspectOtfCharset reporta como CID-keyed com charset não identity é um caso em que os códigos de índice de glifo e a fonte discordam. Incorporada via PDFlibPas for Delphi, essa fonte mantém os contornos, os offsets e o comprimento de charset dela, e o que muda são os CIDs nessa única tabela, mais os checksums quando o sfnt inteiro é mantido