Wywołanie, które umieszcza tekst na stronie PDF, jest proste. Podajesz AddText ciąg, czcionkę, rozmiar i pozycję, a glify się pojawiają. Czego nie robi, to nie mówi ci, jak szeroki będzie ten ciąg po narysowaniu, i nie łamie długiego ciągu na kilka wierszy. Pojedyncze wywołanie maluje jeden fragment tekstu w jednej pozycji. Jeśli fragment jest szerszy niż kolumna, w którą miał się zmieścić, po prostu wybiega poza krawędź i nic w wywołaniu rysującym cię nie ostrzega. W chwili, gdy chcesz akapitu, a nie pojedynczej etykiety, brakującym elementem jest szerokość ciągu w wybranej czcionce i rozmiarze, zmierzona przed umieszczeniem go na stronie
To klasyczny problem układu. Żeby zawinąć akapit w kolumnę, musisz wiedzieć, słowo po słowie, ile miejsca w poziomie zajmie każdy kandydat na wiersz, i musisz to wiedzieć, zanim cokolwiek narysujesz. Zawijanie wierszy to pętla pomiarowa owinięta wokół wywołania rysującego, a wiązanie, które tylko rysuje, daje ci drugą połowę. Obsługa pomiaru tekstu w komponencie PDFium zamyka tę lukę dwiema funkcjami, MeasureText i MeasureTextWidth, które raportują wyrenderowany zasięg ciągu, nie zostawiając śladu na żadnej stronie
Dlaczego pomiar jest class helperem, a nie nową metodą TPdf
Obsługa pomiaru przychodzi jako class helper Delphi dla TPdf, mieszkający we własnym module, a nie jako nowe metody wkręcone w klasę TPdf. Class helper to cecha języka, która pozwala doczepić metody do istniejącego typu spoza jego deklaracji. Gdy moduł jest w zasięgu, nowe metody wywołuje się dokładnie tak, jakby należały do klasy, więc metoda helpera czyta się jako Pdf.MeasureTextWidth(...), bez osobnego obiektu do skonstruowania czy przekazywania
Powodem takiego warstwowania jest rozdzielenie. Rdzeniowy typ TPdf zostaje taki, jaki jest, bez dodanego pola i bez ruszania istniejących sygnatur, więc projekt, który nigdy nie potrzebuje układu, nigdy nie nosi kodu pomiarowego. Projekt, który go potrzebuje, dodaje jeden moduł do klauzuli uses i metody się zapalają. Możliwość staje się opcjonalna w granularności pojedynczego modułu, a to najczystszy sposób rozszerzenia typu, którego nie jesteś właścicielem albo którego nie chcesz naruszać
uses
  PDFium, FPdfView, FPdfEdit,
  FPdfMeasure;   // moduł helpera; wnosi MeasureText do zasięgu TPdf

// Gdy moduł jest w zasięgu, metody czytają się jak składowe TPdf:
var
  W, H: Double;
begin
  Pdf.MeasureText('Subtotal', 'Helvetica', 11, W, H);
  // W i H to teraz wyrenderowana szerokość i wysokość w jednostkach użytkownika PDF
end;
Pomiar bez dotykania strony
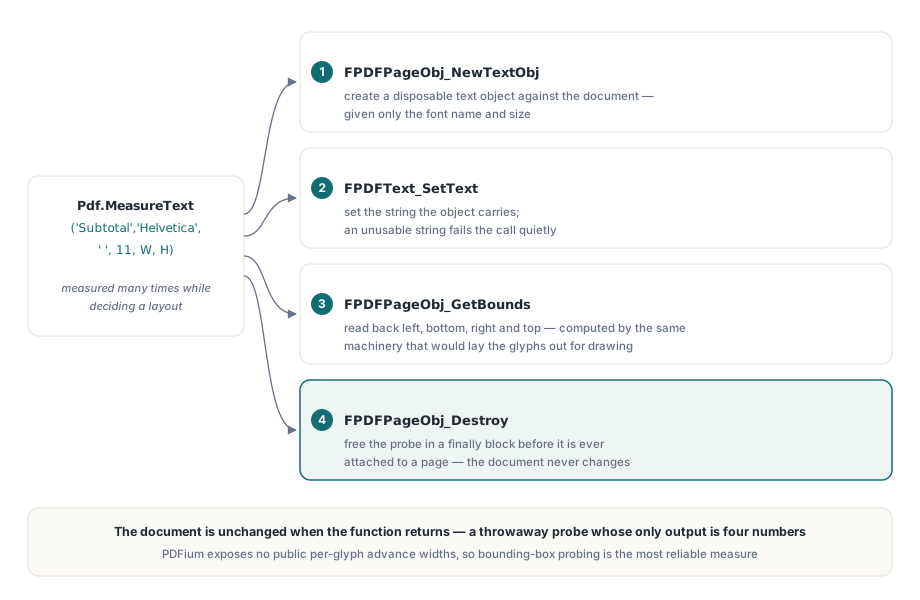
Pomiar musi być wolny od efektów ubocznych. Musi raportować szerokość, nie zostawiając niczego za sobą, bo wywołujesz go wielokrotnie, decydując o układzie, a strona musi wyglądać dokładnie tak, jak wyglądałaby, gdybyś nigdy nie mierzył. Techniką, która to umożliwia, jest zbudowanie obiektu tekstowego, zapytanie go o rozmiar i wyrzucenie, zanim w ogóle zostanie doczepiony do strony
Sekwencja to cztery wywołania PDFium. FPDFPageObj_NewTextObj tworzy obiekt tekstowy względem dokumentu, na podstawie nazwy czcionki i rozmiaru. FPDFText_SetText ustawia ciąg, który ten obiekt niesie. FPDFPageObj_GetBounds odczytuje prostokąt ograniczający obiektu. FPDFPageObj_Destroy zwalnia obiekt. Kluczowe jest to, że nic w tej sekwencji nie wywołuje API wstawiania na stronę. Obiekt jest tworzony, odpytywany i niszczony w izolacji, więc dokument jest niezmieniony, gdy funkcja wraca. To jednorazowa sonda, której jedynym wyjściem są cztery liczby jej prostokąta ograniczającego
Jest to solidny sposób, bo PDFium nie udostępnia wygodnej szerokości nabiegowej pojedynczego glifu, którą mógłbyś sam zsumować. Metryki glifów zależą od programu czcionki, od kodowania i od tego, jak PDFium wczytuje krój, a nie ma publicznego wywołania podającego ci nabieg każdego znaku w ciągu. Prostokąt ograniczający prawdziwego obiektu tekstowego jest natomiast liczony przez tę samą maszynerię, która ułożyłaby glify do rysowania, więc odzwierciedla faktyczny wyrenderowany zasięg, a nie przybliżenie. Zbudowanie jednego jednorazowego obiektu i odczytanie jego granic to najbardziej wiarygodny pomiar, jaki biblioteka może dać
// Kształt MeasureText, wyrażony na zweryfikowanych wywołaniach PDFium.
// Obiekt tekstowy jest budowany, mierzony i niszczony; żadna strona nie bierze w tym udziału.
procedure TPdfMeasureHelper.MeasureText(const Text, Font: WString;
  FontSize: Single; out Width, Height: Double);
var
  TextObject: FPDF_PAGEOBJECT;
  L, B, R, T: Single;
begin
  Width  := 0;
  Height := 0;
  if Self.Document = nil then
    Exit;
  TextObject := FPDFPageObj_NewTextObj(Self.Document,
    FPDF_BYTESTRING(AnsiString(Font)), FontSize);
  if TextObject = nil then
    Exit;
  try
    if FPDFText_SetText(TextObject, FPDF_WIDESTRING(WideString(Text))) = 0 then
      Exit;
    if FPDFPageObj_GetBounds(TextObject, L, B, R, T) <> 0 then
    begin
      Width  := R - L;
      Height := T - B;
    end;
  finally
    FPDFPageObj_Destroy(TextObject);   // sonda odrzucona, strona nietknięta
  end;
end;
Współrzędne i jednostki wyniku
Prostokąt ograniczający wraca jako cztery krawędzie: lewa, dolna, prawa i górna, a dwa wymiary wypadają z odejmowania. Szerokość to prawa minus lewa, a wysokość to górna minus dolna. Oba wyrażone są w jednostkach użytkownika PDF, gdzie jedna jednostka to jedna siedemdziesiąta druga cala, w tej samej przestrzeni współrzędnych, w której pozycjonujesz tekst na stronie. Na tym etapie nie ma żadnej ukrytej jednostki urządzenia ani piksela. Szerokość 36 oznacza pół cala strony, niezależnie od ostatecznej rozdzielczości renderowania
Oś pionowa biegnie tak, jak definiuje ją PDF, z Y rosnącym w górę, i dlatego wysokość to górna minus dolna, a nie odwrotnie. Ten szczegół ma znaczenie, gdy przesuwasz kursor w dół kolumny. Mierzysz wysokość wiersza, a potem odejmujesz ją od bieżącej linii bazowej, żeby znaleźć następną, bo ruch w dół strony oznacza ruch ku mniejszym Y. Jeśli twoim celem jest ekran, a nie papier, przeliczasz jednostki użytkownika na piksele urządzenia z rozdzielczością wyświetlacza: wartość w jednostkach użytkownika pomnożona przez DPI i podzielona przez 72 daje piksele, więc szerokość kolumny ustawioną w punktach można zestawić ze zmierzonym fragmentem, zanim zdecydujesz, gdzie pada podział
Co się dzieje przy wejściu zdegenerowanym
Funkcje są napisane tak, by zawodzić po cichu. Jeśli nie ma otwartego dokumentu albo obiektu tekstowego nie da się utworzyć, wynikiem jest zerowy zasięg, a nie zgłoszony wyjątek. Szerokość i wysokość są inicjalizowane zerem na początku i nadpisywane dopiero po pomyślnym odczytaniu prostokąta ograniczającego. Pusty ciąg, brakujący dokument, czcionka, której biblioteka nie potrafi rozwiązać w obiekt: każde z tych zwraca zero, zamiast rzucać wyjątek
Ten wybór utrzymuje pętlę pomiarową prostą, bo pętla przebiegająca tysiące słów nie jest miejscem na obsługę wyjątków w każdej iteracji. Kosztem jest to, że kontrolę niesie wywołujący. Zerowa szerokość jest wartownikiem, a nie faktem o tekście, więc kod, który dzieli przez zmierzoną szerokość albo zakłada wartość dodatnią, musi zabezpieczyć się przed zerem, zanim mu zaufa. Traktuj zero jako „nie udało się zmierzyć”, a kontrakt jest jasny; zignoruj je, a zdegenerowane wejście po cichu zamienia się w układ z kolumną nachodzących na siebie glifów
Zachłanne zawijanie wierszy zbudowane na pomiarze
Mając funkcję szerokości w ręku, zawijanie wierszy to krótka zachłanna pętla. Dzielisz akapit na słowa, trzymasz bieżący wiersz i dla każdego słowa mierzysz, jak wyglądałby wiersz po dołączeniu tego słowa. Dopóki próbny wiersz wciąż mieści się w szerokości kolumny, dodajesz dalej; gdy miałby ją przelać, wypłukujesz bieżący wiersz przez AddText i zaczynasz nowy od słowa, które się nie zmieściło. Akumulacja odbywa się w całości przez MeasureTextWidth, a jedynym, co kiedykolwiek trafia na stronę, jest wiersz, o którym już potwierdziłeś, że się mieści

procedure WrapParagraph(Pdf: TPdf; const Para, Font: WString;
  FontSize: Single; X, TopY, ColumnWidth, LineHeight: Double);
var
  Words: TArray<string>;
  Line, Trial: WideString;
  I: Integer;
  Y: Double;
begin
  Words := string(Para).Split([' ']);
  Line  := '';
  Y     := TopY;
  for I := 0 to High(Words) do
  begin
    if Line = '' then
      Trial := Words[I]
    else
      Trial := Line + ' ' + Words[I];
    // Zmierz kandydata na wiersz przed narysowaniem czegokolwiek.
    if (Line <> '') and (Pdf.MeasureTextWidth(Trial, Font, FontSize) > ColumnWidth) then
    begin
      Pdf.AddText(Line, Font, FontSize, X, Y);   // wypłucz wiersz, który się zmieścił
      Y    := Y - LineHeight;                    // Y maleje w dół strony
      Line := Words[I];                          // przelewające się słowo zaczyna następny
    end
    else
      Line := Trial;
  end;
  if Line <> '' then
    Pdf.AddText(Line, Font, FontSize, X, Y);      // wypłucz ostatni wiersz
end;
Pętla mierzy próbny wiersz, zamiast mierzyć każde słowo i sumować, bo szerokość wiersza nie jest sumą szerokości jego słów. Odstępy między słowami też się liczą, a zmierzony fragment ujmuje to wprost. Reguła zachłanna, czyli zmieść tyle słów, ile pozwala kolumna, i złam na ostatnim, które się mieści, jest tą samą regułą, która wypełnia lukę między surowym AddText a prawdziwym akapitem. Wywołanie rysujące nigdy nie było trudną częścią. Jest nią pomiar, który musi je poprzedzić, i to właśnie dostarcza helper
Gdzie to pasuje
Pomiar to warstwa między generowaniem treści a jej renderowaniem, więc łączy się naturalnie z resztą przepływu budowania dokumentu od zera. Jeśli dopiero składasz strony i rozmieszczasz tekst, podstawy są w artykule o tworzeniu dokumentów PDF od zera komponentem PDFium w Delphi, gdzie AddText i konfiguracja strony są omówione w całości. Gdy czcionka, którą mierzysz, liczy się tak samo jak ciąg, bo metryki zależą od kroju, artykuł o analizowaniu właściwości czcionek PDF komponentem PDFium w Delphi pokazuje, jak biblioteka raportuje informacje o czcionce sterujące tymi prostokątami ograniczającymi. Oba budują na tym samym wiązaniu, PDFium Component dla Delphi i Lazarusa, gdzie helper pomiarowy jest wysyłany razem z API dokumentu, strony i tekstu opisywanymi na tym blogu