Batch skanów może być niczym innym jak jednym JPEG na stronę, bez czcionek, bez adnotacji i bez zakładek, i nadal zawieść jako PDF/raster. ISO 23504-1 żąda od pliku więcej niż samych stron rastrowych: musi się identyfikować komentarzem %PDF-raster-1.0 w obszarze traileru, nieść metadane XMP i trailerowy /ID oraz trzymać katalog i słownik Info na krótkich dozwolonych listach. Sprawdzanie batcha akwizycji bierze więc dwa różne odczyty: jeden po surowych bajtach i jeden po tym, co każda strona faktycznie rysuje
Dwa odczyty tego samego pliku
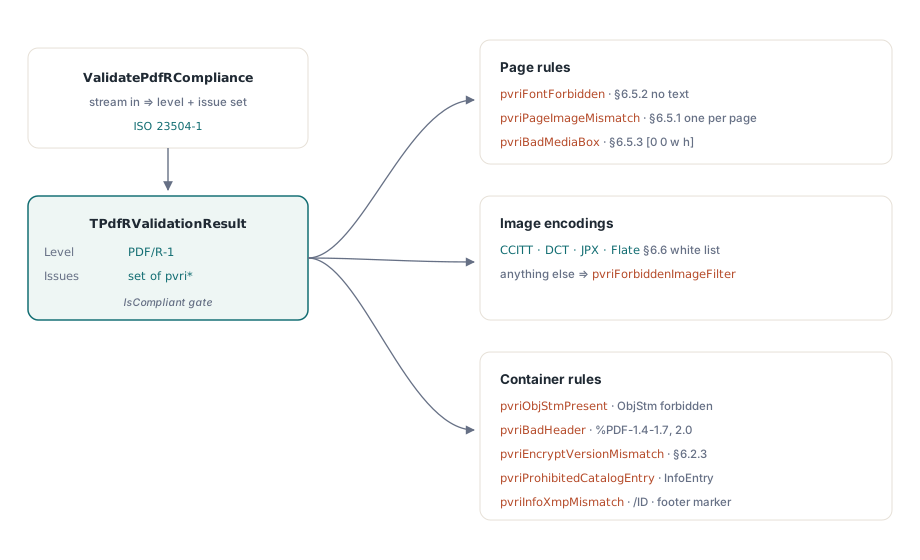
Walidacja PDF/R i SaveAsPdfR przychodzą z edycjami Small Business i Enterprise PDFium Component, które dzieli walidację właśnie po tej linii. ValidatePdfRCompliance w jednostce FPdfPdfr czyta strumień i sprawdza reguły bajtowe: wersję nagłówka, znacznik rastrowy, strumienie obiektów, wpisy katalogu i Info, XMP, trailerowy /ID, pochodzenia MediaBox, zasoby czcionek, zakazane nazwy filtrów i to, czy liczba obiektów obrazów zgadza się z liczbą stron. ValidatePdfRPageFacts sprawdza jedną stronę na raz z rekordu TPdfRPageFacts: ile obiektów tekstu, ścieżek, form i cieniowań rysuje strona, gdzie siedzi pojedynczy obraz paskowy, jego rozmiar w pikselach, głębię bitową, przestrzeń barw i łańcuch filtrów
Oba odczyty raportują przez jedną enumerację, TPdfRValidationIssue, a połączone punkty wejścia zlewają je w jeden TPdfRValidationResult. Jego pole Conformance staje się prc1 tylko, gdy znacznik rastrowy zostanie znaleziony, a IsCompliant zwraca True tylko, gdy poziom to prc1 i zbiór problemów jest pusty. Plik doskonały w każdym innym względzie, ale bez znacznika, raportuje prcNone, co zaskakuje ludzi przy pierwszym przepuszczeniu czystego skanu
Pytanie brzmi, skąd biorą się fakty stron. TPdf.ValidatePdfR zbiera je z wczytanego dokumentu, ale najpierw serializuje ten dokument do tymczasowego magazynu i przegania kontrole bajtowe po ponownie zapisanej kopii, więc werdykty znacznika i katalogu opisują świeży zapis, który może różnić się od pliku na dysku. ValidatePdfRasterSource w FPdfBusinessWorkflows bierze jeden snapshot strumienia wejściowego i przegania wobec niego oba odczyty. Dla pliku, który zaraz trafi do archiwum, to jest wywołanie właściwe: werdykt odnosi się wtedy do bajtów, które są archiwizowane
uses
  System.Classes, System.SysUtils, System.TypInfo,
  FPdfPdfr, FPdfReport, FPdfBusinessWorkflows;

procedure CheckDeliveredScan(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Options: TPdfRasterSourceValidationOptions;
  Report: TPdfRasterSourceValidationReport;
  Issue: TPdfRValidationIssue;
  I: Integer;
begin
  Options := TPdfRasterSourceValidationOptions.Default;
  Options.MaxInputBytes := 512 * 1024 * 1024;     // domyślny budżet to 64 MiB
  Options.Validation.MinimumResolutionDpi := 200; // nasz kontrakt akwizycji
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if not ValidatePdfRasterSource(Src, Options, Report) then
    begin
      Log.Add(Format('Check stopped (%s): %s',
        [GetEnumName(TypeInfo(TPdfRasterSourceStatus), Ord(Report.Status)),
         Report.ErrorMessage]));
      Exit;
    end;
  finally
    Src.Free;
  end;

  if Report.IsCompliant then
    Log.Add('PDF/R-1 conformant')
  else
  begin
    // Validation.Issues trzyma problemy bajtowe plus każdy problem strony
    for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
      if Issue in Report.Validation.Issues then
        Log.Add('File: ' + GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue)));
    // PageIssues mówi, które strony przeskanować ponownie
    for I := 0 to Report.ProcessedPageCount - 1 do
      for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
        if Issue in Report.PageIssues[I] then
          Log.Add(Format('Page %d: %s', [Report.Pages[I].PageNumber,
            GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue))]));
  end;

  // Trzymaj werdykt czytelny dla maszyny obok archiwizowanego pliku
  Log.Add(Report.ToJson(TPdfReportLimits.Default));
end;
Dwa domyślne w TPdfRasterSourceValidationOptions znaczą dla batchów skanów. MaxInputBytes to 64 MiB, a MaxPages to 1000; długi batch skanów kolorowych może przekroczyć budżet bajtowy i kontrola kończy wtedy statusem prssBudgetExceeded przy Complete równym False. MemoryLimitBytes to 8 MiB, poza którymi snapshot przelewa się do TemporaryDirectory, a raport ustawia SnapshotSpilled. Report.IsCompliant wymaga też Complete, więc kontrola zatrzymana w połowie nigdy nie czyta się jako zaliczona
Dlaczego warstwa tekstu OCR wywala PDF/R?
Bo strona rastrowa rysuje zeskanowany obraz i nic więcej. Niewidzialna warstwa OCR to normalny dodatek w przepływie PDF/A i wkłada do pliku dwie rzeczy, które PDF/R wyklucza: zasób czcionki, raportowany przez odczyt bajtowy jako pvriFontForbidden, i obiekty tekstu na stronie, raportowane przez odczyt strony jako pvriNonRasterPageContent. Ten sam problem strony odpala się dla ścieżek wektorowych, cieniowań i form XObjects, więc ostemplowany numer strony albo narysowana linia obramowania zawodzą tak samo jak ukryty tekst
Relacja strony do obrazu też jest surowa. Każda strona musi nieść dokładnie jeden obraz paskowy; pvriPageImageMismatch odpala się na stronie bez obrazu i na stronie, której skan został zapisany jako dwa obrazy obok siebie. Po stronie bajtów liczenie idzie po każdym obiekcie, którego /Subtype to /Image, więc każdy dodatkowy obiekt obrazu, na przykład miękka maska doklejona do paska, pcha sumę ponad liczbę stron
Geometria dostaje dwie kontrole. pvriBadMediaBox raportuje MediaBox, który nie startuje od [0 0 ...]; odczyt bajtowy ogląda wbudowane tablice numeryczne. Odczyt strony porównuje potem narysowane granice paska z MediaBox i raportuje pvriStripGeometryInvalid, gdy jakakolwiek krawędź odbiega o więcej niż GeometryTolerancePoints, domyślnie 0.5 punkta. Sterownik skanera zostawiający biały margines przez skalowanie obrazu do 98% strony zawodzi tutaj, choć strona wygląda dobrze na ekranie. Ustawienie RequireFullPageStrip na False wyłącza test pokrycia dla wewnętrznych plików, gdzie margines jest akceptowalny
Które kodowania obrazów przechodzą
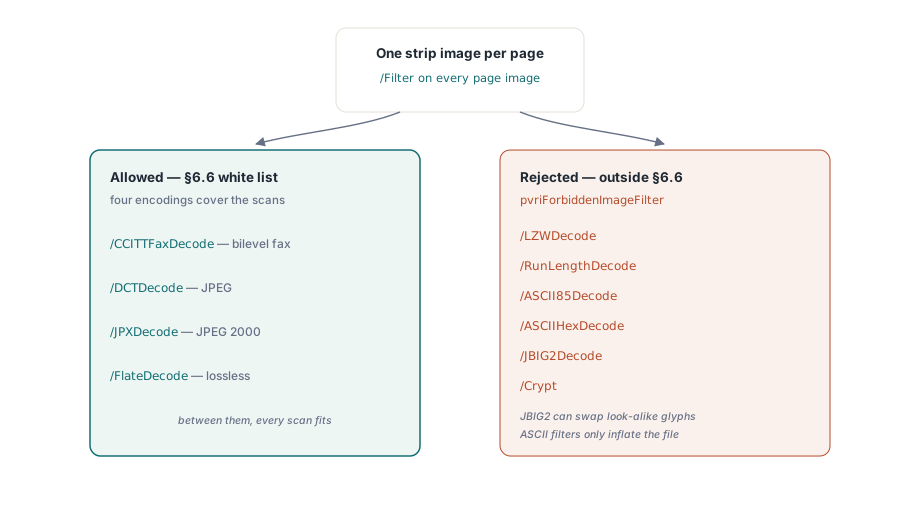
Walidator przyjmuje cztery filtry pasków: /CCITTFaxDecode, /DCTDecode, /JPXDecode i /FlateDecode. Odczyt bajtowy flaguje inne standardowe filtry po nazwie jako pvriForbiddenImageFilter: /LZWDecode, /RunLengthDecode, /ASCII85Decode, /ASCIIHexDecode, /JBIG2Decode i /Crypt
JBIG2 to odrzucenie, na które zespoły akwizycji trafiają najpierw. Jest dozwolony w PDF/A i bardzo dobrze kompresuje strony dwupoziomowe, więc profil akwizycji zbudowany pod PDF/A może już go emitować. Jego stratny tryb dopasowania wzorców jest też znany z zastępowania zeskanowanego glifu podobnie wyglądającym — udokumentowany problem z cyframi na zeskanowanych formularzach — a archiwum rastrowe istnieje właśnie po to, żeby to, co było na papierze, było w pliku. Przekodowanie tych stron jako CCITT Group 4 trzyma je dwupoziomowymi i bezstratnymi
Odczyt strony idzie o krok dalej i patrzy na łańcuch filtrów razem z głębią bitową i przestrzenią barw obrazu, raportując niezgodności jako pvriImageCompressionParametersInvalid:
- Łańcuch dłuższy niż jeden filtr jest odrzucany, więc obraz Flate owinięty ASCII85 zawodzi dwa razy — raz po stronie bajtów i raz tutaj
/CCITTFaxDecodemusi siedzieć na pasku 1-bitowym DeviceGray/DCTDecodemusi siedzieć na pasku 8-bitowym albo 24-bitowym w DeviceGray lub DeviceRGB/FlateDecodejest przyjmowany na paskach 1-bitowych; strona Flate 24-bitowa zawodzi tę kontrolę/JPXDecodejest przyjmowany przy 1, 8 albo 24 bitach na piksel
Niezależnie od filtra pasek, którego przestrzeń barw nie jest ani DeviceGray, ani DeviceRGB, dostaje pvriImageColorInvalid. Skan oparty na ICC albo CMYK musi być więc przekonwertowany przed zawinięciem, a najtańsze miejsce na to to profil skanera, przed zapisaniem jakiegokolwiek PDF
Jak wyliczana jest rozdzielczość paska
Gdy obraz niesie własną rozdzielczość, odczyt strony jej używa. Gdy jej nie niesie, efektywna rozdzielczość jest wyprowadzana z pikseli i rozmiaru strony: szerokość w pikselach razy 72 podzielone przez szerokość MediaBox w punktach i to samo dla wysokości. Załóżmy, że skaner zapisuje pasek 2550 na 3300 pikseli na stronie US Letter o 612 na 792 punktów. Wychodzi dokładnie 300 dpi w obu kierunkach. Ta sama strona przy 600 na 776 pikseli wychodzi na około 70.6 dpi w poziomie, czyli poniżej domyślnego minimum 72, więc strona dostaje pvriImageResolutionInvalid
Domyślny zakres w TPdfRValidationOptions to od 72 do 2400 dpi. Te granice łapią tylko ewidentnie zepsute strony. Kontrakt akwizycji zwykle obiecuje konkretne minimum, często 200 albo 300 dpi, i ta wartość należy do MinimumResolutionDpi: strona 150 dpi przechodzi domyślny zakres, a to dokładnie ta strona, by wykluczyć którą napisano tamten kontrakt. Ustawienie którejkolwiek granicy na 0 wyłącza tę stronę kontroli
ValidatePdfRPageFacts jest publiczny, więc te same reguły mogą działać, zanim istnieje jakikolwiek PDF, wprost z tego, co skaner raportuje o każdym obrazie:
uses
  FPdfPdfr;

// Buduje fakty strony z wyjścia skanera; ten pomocnik jest twój, nie część biblioteki
function ScannerStripFacts(PixelW, PixelH: Integer;
  PageWidthPt, PageHeightPt: Single; const Filter: string;
  BitsPerPixel: LongWord; ColorSpace: Integer): TPdfRPageFacts;
begin
  Result := Default(TPdfRPageFacts);
  Result.PageNumber := 1;
  Result.MediaWidth := PageWidthPt;
  Result.MediaHeight := PageHeightPt;
  Result.ImageCount := 1;
  Result.ImageRight := PageWidthPt;   // pasek pokrywa całą stronę
  Result.ImageTop := PageHeightPt;
  Result.PixelWidth := PixelW;        // HorizontalDpi zostawione na 0: wyliczane
  Result.PixelHeight := PixelH;
  Result.BitsPerPixel := BitsPerPixel;
  Result.ColorSpace := ColorSpace;    // 1 = DeviceGray, 2 = DeviceRGB
  SetLength(Result.Filters, 1);
  Result.Filters[0] := Filter;
end;

var
  Opts: TPdfRValidationOptions;
  Issues: TPdfRValidationIssues;
begin
  Opts := TPdfRValidationOptions.Default;
  Opts.MinimumResolutionDpi := 300;

  // Kolorowy JPEG 300 dpi na Letter: pusty zbiór
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'DCTDecode', 24, 2), Opts);

  // Ta sama strona skompresowana Flate przy 24 bitach:
  // [pvriImageCompressionParametersInvalid]
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'FlateDecode', 24, 2), Opts);
end;
Katalog, słownik Info i XMP
Poza wymaganymi /Type i /Pages ISO 23504-1 pozwala w katalogu wyłącznie na Version, ViewerPreferences, PageLayout, PageMode, AcroForm i Metadata. Walidator sprawdza katalog wobec 21 standardowych kluczy poza tym zbiorem i podnosi pvriProhibitedCatalogEntry, gdy którykolwiek się pojawi — wśród nich Outlines, Names, PageLabels, OpenAction, StructTreeRoot, MarkInfo, Lang, OCProperties i OutputIntents. Ten ostatni ma znaczenie w praktyce: plik PDF/A zawsze niesie intencję wyjściową, więc jeden plik nie zaspokoi obu profili
Słownik Info może trzymać Creator, Producer, CreationDate i ModDate; Title, Author, Subject, Keywords i Trapped podnoszą pvriProhibitedInfoEntry. Katalog bez strumienia /Metadata dostaje pvriMissingXmpMetadata. Gdy strumień jest, ale jego XMP nie ma któregokolwiek z xmp:CreateDate, xmp:ModifyDate i xmp:MetadataDate, ustaleniem jest zamiast tego pvriMetadataInvalid. pvriInfoXmpMismatch porównuje Producer z pdf:Producer i Creator z xmp:CreatorTool. Daty są wyłączone z tego porównania, bo te dwa kodowania mogą się legalnie różnić, a wartości Info zapisane jako stringi hex są pomijane. Typowym wyzwalaczem jest późniejsze narzędzie przepisujące Info Producer bez dotykania XMP
Pozostałe reguły kontenera są krótkie. Nagłówek musi być %PDF-1.4 przez %PDF-1.7 albo %PDF-2.0 (pvriBadHeader), każdy strumień /Type /ObjStm podnosi pvriObjStmPresent, a zaszyfrowany plik musi używać nagłówka %PDF-2.0 (pvriEncryptVersionMismatch). Przy zostawionym RequireEncryptedPdf20Profile słownik szyfrowania musi też deklarować /V 5 albo 6 z /R 5 lub nowszym, inaczej plik dostaje pvriEncryptedPdf20ProfileInvalid
Zapisywanie znaczników
TPdfRSaveOptions niesie Creator, Producer, CreationDate, ModDate, DocumentId i InstanceId i nie ma pola dla Title, Author, Subject ani Keywords, bo profil ich zakazuje. StripInfoOptionalEntries i StripCatalogOptionalEntries domyślnie oba są True i usuwają wykluczone wpisy ze źródła; ustaw któreś na False, a wpisy zostaną, kosztem zgodności. TPdf.SaveAsPdfR wypełnia puste pola opcji z własnych metadanych wczytanego dokumentu i identyfikatorów pliku, usuwa zabezpieczenia, a potem zapisuje znacznik, przycięte słowniki, pakiet XMP i trailerowy /ID
uses
  System.Classes, System.SysUtils, PDFium, FPdfPdfr;

procedure WrapScanAsPdfR(const InFile, OutFile: string; Log: TStrings);
var
  Pdf: TPdf;
  Opts: TPdfRSaveOptions;
  Written: TFileStream;
  Res: TPdfRValidationResult;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := InFile;
    Pdf.Active := True;
    Opts := TPdfRSaveOptions.Default;
    Opts.Creator := 'Capture Station 4';   // Producer, daty i ID przychodzą ze źródła
    if not Pdf.SaveAsPdfR(OutFile, Opts) then
      raise Exception.Create('PDF/R save failed: ' + InFile);
  finally
    Pdf.Free;
  end;

  // Sprawdź zapisane bajty, nie dokument w pamięci
  Written := TFileStream.Create(OutFile, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfRCompliance(Written);
    if pvriPageImageMismatch in Res.Issues then
      Log.Add('A source page still has no single strip image');
    if pvriFontForbidden in Res.Issues then
      Log.Add('The source carries fonts; rescan or drop the text layer');
  finally
    Written.Free;
  end;
end;
Zawinięcie zmienia tylko metadane i identyfikację. Strona źródłowa rysująca tekst wektorowy albo niemieszcząca paska obrazu wychodzi z SaveAsPdfR z tą samą treścią strony i zawodzi te same kontrole strony. Treść strony jest zostawiana celowo, bo po cichu wyrenderowanie skanu na nowo zmieniłoby dokładnie te piksele, które archiwum ma zachować. Odpalenie CheckDeliveredScan z pierwszego zestawienia na OutFile daje pełny werdykt, z odczytami stron włącznie
Gdzie PDF/R pasuje w potoku akwizycji
PDF/R pasuje do deliverables, gdzie sam skan jest rejestrem, a wierność to cały kontrakt: obrazowanie dowodowe, akwizycja czeków i przekazów, archiwa rysunków ze skanera wielkoformatowego. Gdy tylko dokument potrzebuje tekstu do przeszukiwania, tagowania, załączników albo zakładek, należy do PDF/A, bo każda z tamtych funkcji ląduje na wykluczonych listach z wyżej
Wiele zespołów trzyma oba. Oryginał PDF/R jest zapisywany raz i nigdy się nie zmienia, a pochodna PDF/A z warstwą OCR obsługuje wyszukiwanie. Walidatory są niezależne, więc jedno zadanie batchowe może sprawdzić każdy plik wobec profilu, do którego się przyznaje. Stronę archiwalną pokrywają zgodność archiwalna PDF/A i walidacja preflight PDF/A, a wyjście drukarskie walidacja dokumentów PDF/X gotowych do druku
Kontrole PDF/R pokazane tutaj są częścią edycji Small Business i Enterprise PDFium Component dla Delphi, C++Builder i Lazarus, obok walidatorów PDF/A, PDF/X, PDF/E i PDF/UA; edycje i wspierane wersje IDE są na stronie produktu PDFium Component