Słownik Info trzymający /ModDate (D:20260827093659+08'00') i pakiet XMP trzymający xmp:ModifyDate jako 2026-08-27T01:36:59Z opisują tę samą sekundę, a walidator PDF/A ma wszelkie powody, by tę parę zaakceptować. Skopiuj jednak napis Subject dokumentu do dc:subject, a pakiet zawodzi, choć tekst zgadza się znak w znak. ISO 19005-1 §6.7.3 żąda równoważnych wartości, w konkretnych właściwościach XMP, w konkretnych kształtach RDF
Zgłoszenie błędu, które zwykle otwiera ten temat, wygląda niewinnie. System zarządzania dokumentami wytłacza świeży /ModDate do słownika Info przy każdym zapisie inkrementalnym i zostawia pakiet XMP w spokoju. Kilka miesięcy później audyt archiwum oflagowuje tysiące plików. Obie daty tam są; przestały się zgadzać przy pierwszej edycji, a kontrola, która patrzy tylko na istnienie właściwości, nigdy tego nie zobaczyła. Edycje tytułu przez API tylko-Info zawodzą tak samo, i napis autora typu Finance; Controlling, który jakieś narzędzie rozbiło na dwa wpisy dc:creator, też
Czego ISO 19005-1 wymaga od Info i XMP
Tabela 1 ISO 19005-1 paruje osiem kluczy Info z właściwościami XMP, a §6.7.3 mówi, że gdy klucz Info jest obecny, zmapowana właściwość XMP musi nieść równoważną wartość. Nieobecny klucz niczego nie żąda. PDF/A-2 i PDF/A-3 trzymają to samo wymaganie równoważności dla tych samych ośmiu kluczy. PDF/A-4 idzie w drugą stronę i ogranicza sam słownik Info: może wystąpić tylko obok /PieceInfo w katalogu i wtedy trzymać nic poza ModDate, co TPdf.ValidatePdfA zgłasza przez pvaiPdfA4InfoWithoutPieceInfo i pvaiPdfA4InfoInvalid
W PDFium Component porównanie mieszka w ComparePdfAInfoAndXmp w FPdfPdfa.pas. Każdą właściwość wyszukuje po URI przestrzeni nazw, więc pakiet, który wiąże http://purl.org/dc/elements/1.1/ z nietypowym prefiksem, jest czytany dokładnie jak ten z dc. Zmapowane kształty to:
- Title →
dc:titlei Subject →dc:description: alternatywa językowardf:Alt, porównywana tylko z jej wpisemx-default; tag języka jest dopasowywany bez rozróżniania wielkości liter, a Alt bezx-defaultliczy się jako brak - Author →
dc:creator:rdf:Seqz dokładnie jednym wpisem tekstowym trzymającym cały napis Info, więc lista autorów rozdzielana średnikami zostaje jednym wpisem - Keywords →
pdf:Keywordsi Producer →pdf:Producer(przestrzeń nazwhttp://ns.adobe.com/pdf/1.3/): proste właściwości tekstowe - Creator →
xmp:CreatorTool, CreationDate →xmp:CreateDate, ModDate →xmp:ModifyDate(przestrzeń nazwhttp://ns.adobe.com/xap/1.0/): proste właściwości tekstowe
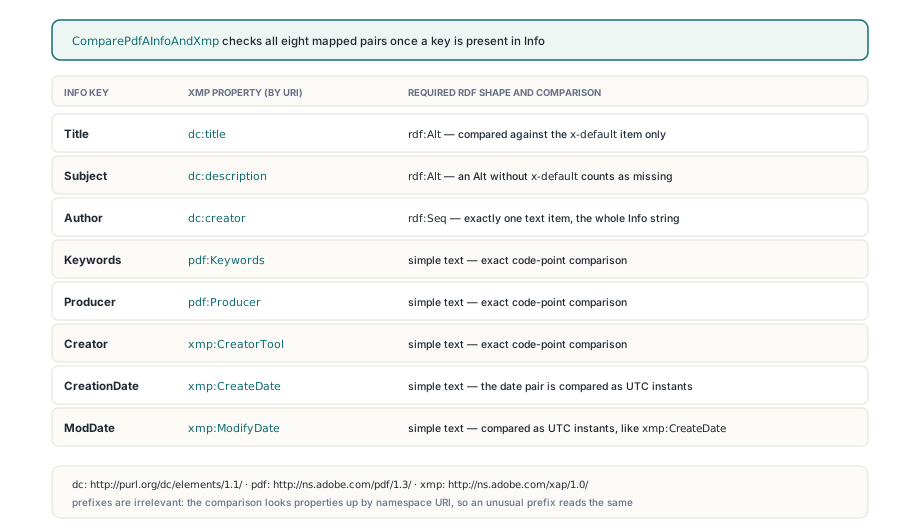
Wiersz Subject to miejsce, gdzie ręcznie składane szablony schodzą najczęściej. dc:subject Dublin Core to nieuporządkowany worek słów kluczowych, a nazwa zaprasza, by wrzucić do niego Subject z Info. Porównanie szuka dc:description, nie znajduje nic i zgłasza Subject jako pamsXmpMissing, podczas gdy „właściwy” tekst siedzi o jedną właściwość obok. Trzy linie we właściwych kształtach wyglądają tak:
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
Dlaczego poprawny napis nadal zawodzi w porównaniu
Poprawny napis zawodzi, gdy siedzi w złym pojemniku albo różni się jednym punktem kodowym. Wartości tekstowe są porównywane jako dokładne sekwence punktów kodowych Unicode, bez strzyżenia, składania wielkości liter czy normalizacji. Końcowa spacja to niezgodność. Tak samo prekomponowane é po jednej stronie kontra rozłożone e plus łączący ostry akcent po drugiej, choć oba zwykle renderują się na ekranie identycznie
Błędy kształtu dostają własny stan. dc:title zapisany jako zwykły tekst, dc:creator zadeklarowany jako rdf:Bag albo Seq dc:creator z dwoma wpisami — wszystkie produkują pamsXmpTypeMismatch zamiast pamsValueMismatch, więc raport potrafi oddzielić „narzędzie wybrało złą strukturę RDF” od „narzędzie zapisało inny tekst”. Oba problemy zwykle przychodzą z różnych miejsc pipeline'u, a naprawianie niewłaściwego marnuje popołudnie
Strona Info zawsze pochodzi z własnego dekodowania PDFium napisów PDFDocEncoding i UTF-16BE przez FPDF_GetMetaText, tej samej ścieżki, której używa TPdf.GetMetadata, więc napis ze znacznikiem kolejności bajtów albo z zescapeowaną sekwencją ósemkową jest czytany tak, jak czyta go silnik. Strona XMP jest czysta tak bardzo, jak bajty, które ją zbudowały. Pakiet złożony w złej stronie kodowej może nieść mojibake, któremu żadne porównanie nie wybaczy, dlatego pułapki stron kodowych psujące metadane XMP pod Free Pascalem należą do tej samej listy kontrolnej
Kiedy data PDF i data XMP są równe
Data PDF i data XMP są równe, gdy opisują ten sam moment z dokładnością do sekundy z tą samą wiedzą o strefie czasowej po obu stronach. Oba parsery akceptują legalną zredukowaną precyzję, więc D:2026 i 2026 oba znaczą 1 stycznia 2026 o północy. Gdy obie wartości niosą strefę, każda jest najpierw konwertowana na UTC: D:20260827093659+08'00' równa się 2026-08-27T01:36:59Z. Gdy żadna nie niesie strefy, lokalne składowe są porównywane tak, jak zapisano
Gdy tylko jedna strona ma strefę, wynikiem jest pamsValueMismatch. Wymyślenie offsetu dla wartości bez strefy byłoby zgadywaniem, i to zgadywaniem, które akurat trafia w strefę czasową serwera, przejdzie na jednej maszynie i zawiedzie na innej. Niezerowa część ułamkowa sekundy, jak .250 w XMP, też wymusza niezgodność, bo data PDF nie ma jak jej wyrazić; .000 jest akceptowane. Wartości, które w ogóle się nie parsują, są zgłaszane jako pamsInvalidInfoDate albo pamsInvalidXmpDate
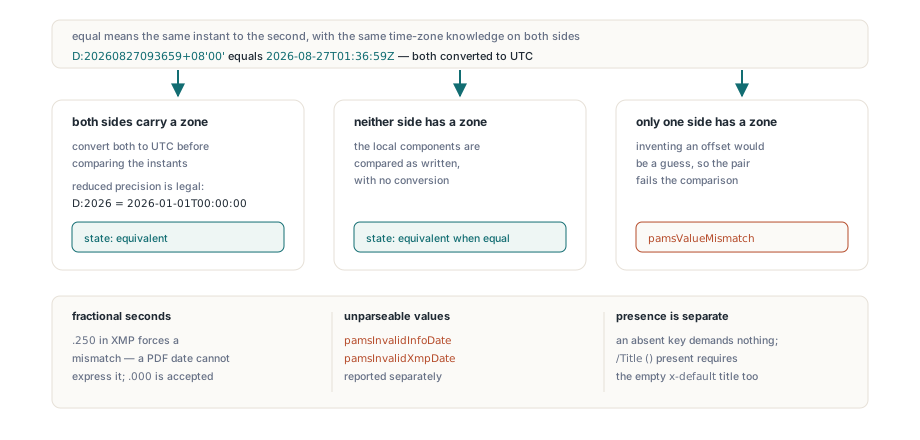
Te dwie gramatyki dat nie są wymienne, a parsery trzymają każdą stronę przy jej własnej. Po stronie PDF apostrofy wokół minut offsetu są opcjonalne, a Z jest akceptowane. Po stronie XMP offset potrzebuje dwukropka: 2026-08-27T09:36:59+08:00 parsuje się, podczas gdy +0800 to pamsInvalidXmpDate. Czas XMP potrzebuje też co najmniej godzin i minut, gdy tylko pojawi się T, a offsety ponad 14 godzin są odrzucane po obu stronach. Otaczający biały znak jest strzyżony przed parsowaniem daty — uprzejmość, której pola tekstowe nie dostają
Obecność ma własną regułę. TPdfAMetadataValues.Present to zbiór wypełniany przez przejście po słowniku /Info aktywnej przyczepy i rozdziela „klucz nieobecny” od „klucz obecny z pustym napisem”. Nieobecny klucz daje pamsNotRequired. /Title () jest obecny, więc pakiet musi nieść też pusty tytuł x-default
Czytanie raportu per pole, zanim ruszysz plik
TPdf.InspectPdfAMetadata zwraca TPdfAMetadataReport z jednym TPdfAMetadataComparison na pole. Każdy wpis trzyma wartość Info, wartość XMP i TPdfAMetadataState, więc awarię da się wytłumaczyć pole po polu. MismatchFields zbiera zbiór zawodzących, HasXmpPacket mówi, czy pakiet znaleziono, a XmpParseError niesie komunikat parsera, gdy pakiet istnieje, ale nie da się go przeczytać. W tym ostatnim przypadku każde obecne pole zgłasza pamsXmpMissing, bo z pakietu nie dało się nic przeczytać
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;
TPdf.ValidatePdfA wtapia to samo porównanie w swój zbiór problemów. Skan poziomu bajtów, opisany w walidacji preflight PDF/A z PDFium Component, zgłasza pvaiMissingXmpDates, gdy pakietowi brakuje obu właściwości dat, i pvaiInfoXmpDateMismatch, gdy Info niesie CreationDate albo ModDate, a pakiet nie ma pasującej właściwości daty. Na tym ValidatePdfA puszcza pełne porównanie wartości i dodaje pvaiInfoXmpValueMismatch za każdym razem, gdy pakiet istnieje, ale nie zgadza się z Info — pakiet nieczytelny włącznie. Dokument bez pakietu w ogóle jest zgłaszany tylko jako pvaiMissingXmpMetadata, więc jeden defekt nigdy nie wychodzi dwa razy. Funkcja na poziomie strumienia ValidatePdfACompliance puszcza sam skan bajtowy
function MetadataGateOk(Pdf: TPdf): Boolean;
var
  Res: TPdfAValidationResult;
begin
  Res := Pdf.ValidatePdfA;
  if pvaiMissingXmpMetadata in Res.Issues then
    Writeln('No usable XMP packet: rebuild the file with SaveAsPdfA');
  if pvaiInfoXmpDateMismatch in Res.Issues then
    Writeln('Info has a date property the XMP packet lacks entirely');
  if pvaiInfoXmpValueMismatch in Res.Issues then
    Writeln('Mapped values disagree: run InspectPdfAMetadata for details');
  Result := Res.IsCompliant;
end;
Co przepisuje NormalizePdfAMetadata i gdzie się zatrzymuje
TPdf.NormalizePdfAMetadata traktuje słownik Info jako źródło prawdy i przepisuje tylko te właściwości XMP, których pole wylądowało w MismatchFields. Title i Subject idą do wpisu x-default, a inne alternatywy językowe zostają nietknięte. Author staje się jednoelementowym rdf:Seq. Data Info ze strefą jest zapisywana jako kanoniczna data UTC XMP z sufiksem Z, a bez strefy trzyma swoje lokalne składowe. Nieznane przestrzenie nazw, niepowiązane właściwości i właściwości XMP dla nieobecnych kluczy Info zostają w spokoju, a istniejące wiązanie prefiksu jest używane ponownie, gdy właściwość jest zapisywana z powrotem
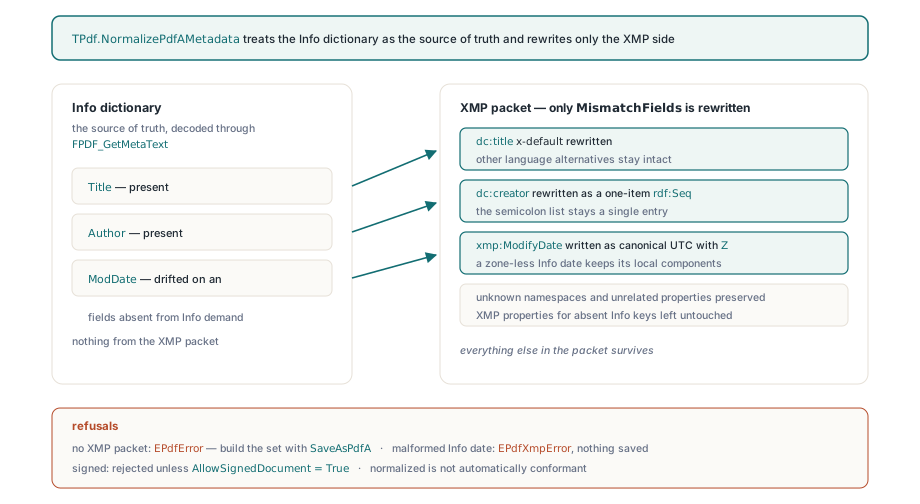
Uczynienie Info autorytatywnym ma koszt, który wychodzi na prawdziwych plikach. Seq dc:creator wymieniający „Finance” i „Controlling” jako dwie osoby jest zastępowany jednym wpisem Finance; Controlling, a dc:title schowany w złym pojemniku jest odbudowywany jako świeży Alt trzymający tylko x-default, więc cokolwiek stary pojemnik trzymał — znika. Ta strata jest tu akceptowalna. Tabela 1 pozwala na dokładnie jeden wpis twórcy, napis Info już trzyma pełną listę w jednym kawałku, a oryginalny pakiet nadal jest w pliku źródłowym, gdyby ktokolwiek potrzebował bogatszej listy
Odmowy są celowe. Bez pakietu XMP metoda rzuca EPdfError: budowanie kompletnego zestawu identyfikacji i metadanych PDF/A to robota SaveAsPdfA, omówiona w tworzeniu plików archiwalnych PDF/A z PDFium Component. Nieczytelny pakiet albo zniekształcona data Info rzuca EPdfXmpError, zanim cokolwiek zostanie zapisane, bo wiarygodnie wyglądająca zła data w XMP jest gorsza niż brak wyjścia. Podpisane dokumenty rzucają EPdfError, chyba że wywołujący poda AllowSignedDocument = True; wyjście to pełny zapis z nowymi metadanymi doklejonymi jako zapis inkrementalny, więc podpisane bajty nie są przenoszone bez zmian
Ta ścieżka zapisu ma jeszcze jedną konsekwencję. NormalizePdfAMetadata zapisuje nowy plik nawet, gdy każde pole już się zgadza, bo zsynchronizowanie niczego i tak kończy się zapisem. Wywołaj najpierw InspectPdfAMetadata i pomijaj pliki zgodne; nocne zadanie, które przepisuje tysiące niezmienionych archiwów, kupuje nic poza nowymi znacznikami czasu plików. Wariant plikowy pisze przez plik tymczasowy i zastępuje cel atomowo. Plik źródłowy zostaje otwarty tak długo, jak dokument jest załadowany, więc daj wyjściu inną ścieżkę
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // już zgodne, zostaw plik w spokoju
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // zniekształcona data Info albo nieczytelny pakiet
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
      on E: EPdfError do         // podpisane wejście bez AllowSignedDocument
        raise Exception.CreateFmt('Skipped %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
Równoważność to jeden punkt ISO 19005-1. Znormalizowany plik nadal musi przejść fonty, kolor, przezroczystość i każdą inną kontrolę PDF/A, więc ValidatePdfA pozostaje bramką, zanim dokument pojedzie do długoterminowego przechowywania
Porównanie pakietu bez wczytanego dokumentu
ComparePdfAInfoAndXmp i SynchronizePdfAInfoToXmp to zwykłe funkcje w FPdfPdfa, które pracują na TPdfXmpPacket bez otwartego PDF, co pasuje testom jednostkowym i pipeline'om wypełniającym XMP z szablonu, zanim dokument istnieje. SynchronizePdfAInfoToXmp zwraca zbiór pól, które przepisała, i rzuca EPdfXmpError, gdy dostanie pakiet nil
Jedna pułapka to Present. Rekord zainicjalizowany przez Default(TPdfAMetadataValues) ma pusty zbiór, każde pole zgłasza wtedy pamsNotRequired, a porównanie przechodzi niezależnie od tego, jakie wartości wpisałeś. Pola napisowe rekordu niosą wartości; tylko Present decyduje, które z nich standard faktycznie żąda
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Present decyduje, które pola są obowiązkowe; same wartości są ignorowane
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // niezgodne xmp:ModifyDate staje się 2026-08-27T01:36:59Z,
    // niezgodne dc:creator staje się jednoelementowym rdf:Seq
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
Przepuszczenie tego samego szablonu przez ComparePdfAInfoAndXmp potem powinno zwrócić pusty MismatchFields, co daje tanią asercję dla kroku budowy, który regeneruje szablony
Archiwa, które inne systemy ciągle edytują, dryfują pole po polu, a raport per pole pokazuje, które odeszło. InspectPdfAMetadata, NormalizePdfAMetadata i reszta narzędzi walidacji i konwersji PDF/A są częścią PDFium Component for Delphi and C++Builder