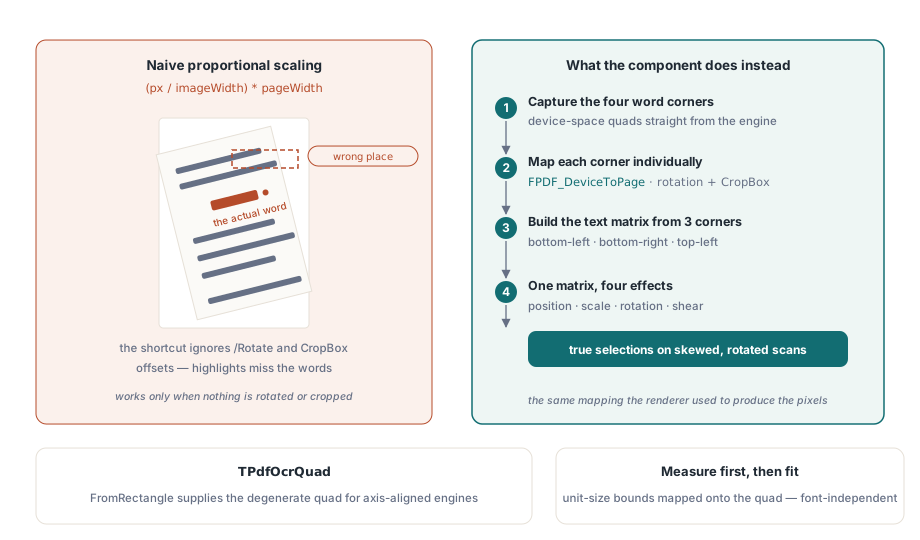
Wyszukiwanie numeru faktury w zeskanowanym PDF znajduje trafienie, ale podświetlenie ląduje pół cala na lewo od wydrukowanych cyfr i pół cala poniżej nich. Pół cala to 36 punktów, a strona, o której mowa, ma CropBox równy [36 36 576 756]. Ktokolwiek budował tamtą warstwę tekstu, przeliczył pozycje pikseli na pozycje strony, dzieląc przez szerokość mapy bitowej i mnożąc przez szerokość strony, co zakłada, że widoczny obszar zaczyna się w punkcie zerowym. Na stronie z wpisem /Rotate 90 ta sama formuła wypada jeszcze gorzej: oś x mapy bitowej biegnie wzdłuż osi y strony i słowa lądują w zupełnie złej części strony
Czym właściwie jest niewidoczna warstwa tekstu
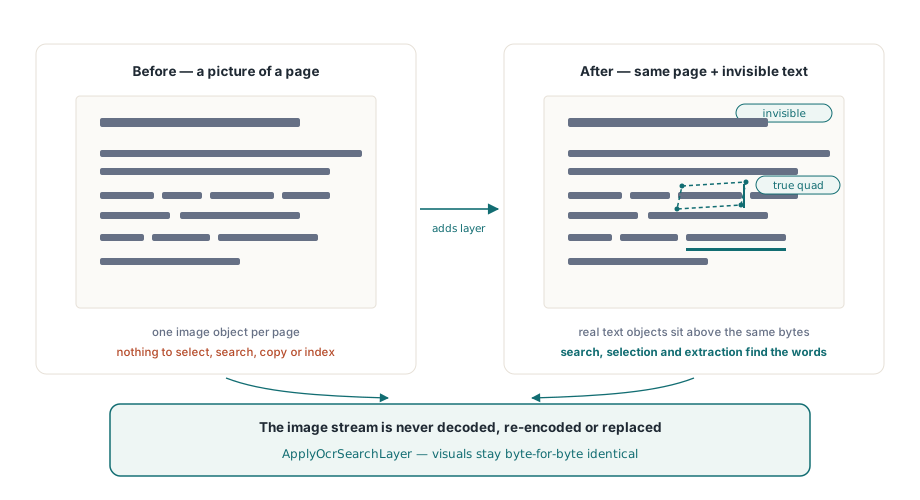
Zeskanowana strona to jeden wielki obraz malowany przez strumień treści. Nie ma tam nic do zaznaczenia, wyszukania, skopiowania ani zindeksowania. Przeszukiwalna warstwa tekstu dodaje zwykłe obiekty tekstowe na wierzchu tego obrazu i ustawia ich tryb renderowania tekstu na 3, co ISO 32000-1 §9.3.6 (tabela 106) definiuje jako ani wypełnienie, ani obrys: glify istnieją dla zaznaczania, wyszukiwania i ekstrakcji, a przeglądarka niczego za nimi nie maluje. Gdy zrobi się to dobrze, czytelnik widzi oryginalny skan, a Ctrl+F znajduje słowa dokładnie tam, gdzie są wydrukowane
W PDFium Component cała robota to jedno wywołanie, TPdf.ApplyOcrSearchLayer. Renderuje ono każdą wybraną stronę, przekazuje piksele dostawcy OCR, filtruje rozpoznane słowa według pewności i zapisuje ocalałe z powrotem jako niewidoczne obiekty tekstowe. Obraz strony zostaje taki, jaki był: skan nie jest dekodowany, ponownie kodowany ani zastępowany, więc obraz JBIG2 albo CCITT G4 zachowuje dokładnie te skompresowane bajty, z którymi przyszedł. Metoda jest dostępna w edycjach Small Business i Enterprise, więc projekt potrzebuje Lib\SmallBusiness na ścieżce wyszukiwania i FPdfSmallBusiness w klauzuli uses; bez tej jednostki wywołanie zgłasza EPdfSmallBusinessRequired
Implementowanie IPdfOcrProvider
Samo rozpoznawanie siedzi za jednym interfejsem. IPdfOcrProvider.RecognizePage dostaje TPdfOcrImage (numer strony, szerokość, wysokość, stride, DPI, format pikseli i bufor TBytes z wierszami BGRA o początku u góry) plus token anulowania, a zwraca tablicę rekordów TPdfOcrWord: tekst Unicode, pewność z zakresu od 0 do 1 i czworokąt o czterech narożnikach w pikselach obrazu. Edycja dostarcza jednego gotowego dostawcy, CreatePdfTesseractOcrProvider w FPdfOcrTesseract, który wiąże się z biblioteką Tesseract i katalogiem traineddata, które dostarczasz sam. Każdy inny silnik, chmurowe API albo komercyjne SDK, podpina się przez klasę jak poniżej:
uses
  System.SysUtils, PDFium, FPdfAsync, FPdfSmallBusiness;

type
  TMyOcrProvider = class(TInterfacedObject, IPdfOcrProvider)
  public
    function RecognizePage(const Image: TPdfOcrImage;
      const CancellationToken: IPdfCancellationToken;
      out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
  end;

function TMyOcrProvider.RecognizePage(const Image: TPdfOcrImage;
  const CancellationToken: IPdfCancellationToken;
  out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
var
  I, Count: Integer;
begin
  // Rutyny Engine* oznaczają poniżej własne powiązanie z silnikiem OCR
  Count := EngineRecognize(Image.Pixels, Image.Width, Image.Height,
    Image.Stride, Image.Dpi);
  CancellationToken.ThrowIfCancelled;   // zgłoś anulowanie jako anulowanie

  SetLength(Words, Count);
  for I := 0 to Count - 1 do
  begin
    Words[I].Text := EngineWordText(I);
    // Wiele silników raportuje 0..100; warstwa oczekuje 0..1
    Words[I].Confidence := EngineWordConfidence(I) / 100;
    Words[I].Quad := TPdfOcrQuad.FromRectangle(
      EngineLeft(I), EngineTop(I), EngineRight(I), EngineBottom(I));
  end;
  ErrorMessage := '';
  Result := True;
end;
Dostawca, który przepuści 87,5 od Tesseraca bez przeróbki, dostanie odrzucone wszystkie słowa. Tesseract raportuje pewność słowa jako procent, a dołączony adapter dzieli ją przed zwróceniem; własny dostawca musi zrobić to samo, bo ApplyOcrSearchLayer traktuje pewność powyżej 1 jako nieprawidłowe dane wejściowe. Objaw jest jednoznaczny, gdy już wiesz, gdzie patrzeć: Report.RejectedWordCount równa się Report.DetectedWordCount, a zapisany plik nie ma tekstu wcale
Wywołanie tokenu ma znaczenie z innego powodu. Jeśli dostawca zauważy anulowanie i po prostu zwróci False, strona zostanie zapisana jako popsFailed z dowolnym komunikatem, który ustawisz. Wywołanie ThrowIfCancelled zamiast tego zgłasza EPdfOperationCancelled, co warstwa łapie i zapisuje jako popsCancelled, z ustawionym Report.Cancelled i zatrzymaną pętlą. Token nigdy nie jest nil wewnątrz dostawcy; gdy wywołujący nie poda żadnego, dostarczany jest token, którego nigdy nie da się anulować
Czworokąty i słowa, których warstwa nie przyjmuje
Skany rzadko są idealnie równoległe do krawędzi strony, więc słowo na lekko przekrzywionej kartce zajmuje równoległobok. TPdfOcrQuad niesie punkty TopLeft, TopRight, BottomRight i BottomLeft właśnie na ten przypadek, a FromRectangle buduje wersję wyrównaną do osi dla silników raportujących tylko prostokąty. Słowo jest pomijane i liczone w RejectedWordCount, gdy jego tekst jest pusty albo dłuższy niż MaxWordCharacters, gdy jego pewność to NaN, jest poniżej MinConfidence lub powyżej 1, gdy którykolwiek narożnik wypada poza mapą bitową albo gdy czworokąt zapada się w włośkę węższą niż 0,01 pt po zmapowaniu
Dlaczego skalowanie proporcjonalne gubi słowa OCR
Skalowanie proporcjonalne jest poprawne tylko wtedy, gdy strona nie ma wpisu /Rotate, a jej CropBox zaczyna się w (0, 0). Mnóstwo skanów zawodzi na jednym z tych warunków: kartka pozioma bywa zapisana jako pionowa strona z ustawionym /Rotate, a pola przycięcia dostają przesunięcie, gdy ktoś obetnie marginesy w edytorze. Otwierający przykład to łagodna awaria; przy obrocie błąd przestaje być przesunięciem, a staje się zamianą osi
ApplyOcrSearchLayer przepuszcza każdy z czterech narożników przez FPDF_DeviceToPage, używając tych samych rozmiarów mapy bitowej i obrotu, które wytworzyły piksele widziane przez dostawcę. Obrót i przesunięcia pola przycięcia są więc obsłużone tą samą transformacją, której użył renderer. Narożniki są zaokrąglane do pełnych pikseli na wejściu, co przy domyślnych 300 DPI daje krok kwantyzacji 0,24 pt, znacznie poniżej tego, co potrafi pokazać podświetlenie zaznaczenia
Z zmapowanych punktów narożniki dolno-lewy, dolno-prawy i górno-lewy definiują macierz afiniczną. Trzy punkty wystarczą, by wyrazić pozycję, skalę, obrót i pochylenie, dlatego czwarty narożnik jest tylko walidowany, nigdy nieużywany do dopasowania. Obiekt tekstowy jest tworzony z rozmiarem fontu 1, mierzy się jego rzeczywiste granice, a macierz mapuje te zmierzone granice na docelowy czworokąt. Zgadywanie rozmiaru punktowego z wysokości czworokąta dryfowałoby z każdym ascendentem i descendentem fontu; wcześniejszy pomiar czyni dopasowanie niezależnym od fontu, który podaje Options.FontName
Font nadal ma znaczenie dla ekstrakcji, choć nic nie jest rysowane. TPdfOcrOptions.Default ustawia go na Arial. Jeśli tego fontu nie da się wczytać, warstwa spada do standardowego Helvetica, jednego ze 14 fontów standardowych, którego wbudowane kodowanie pokrywa tylko tekst łaciński. Dla wyjścia cyrylickiego, greckiego albo CJK ustaw FontName na zainstalowany font pokrywający dane pismo
Uruchamianie warstwy i czytanie raportu
ApplyOcrSearchLayer zwraca True tylko wtedy, gdy żadna strona nie zawiodła i nic nie zostało anulowane. Ta wartość zwrotna to zły przełącznik dla zapisu. Przy ContinueOnError zostawionym na domyślnym True zadanie o 300 stronach z jedną nieczytelną stroną zwróci False, mimo że 299 stron niesie poprawną warstwę, a strona, która zawiodła, została już przywrócona do stanu wyjściowego. Warunkuj zapis raportem:
var
  Pdf: TPdf;
  Options: TPdfOcrOptions;
  Report: TPdfOcrReport;
  Cancel: IPdfCancellationTokenSource;
  I: Integer;
begin
  Cancel := TPdfCancellationTokenSource.New;  // trzymaj go pod ręką dla przycisku Anuluj
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'scanned-contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfOcrOptions.Default;      // 300 DPI, MinConfidence 0.5, Arial
    Options.MinConfidence := 0.6;
    Options.MaxTotalPixels := Int64(4000) * 1000 * 1000;

    Pdf.ApplyOcrSearchLayer(TMyOcrProvider.Create, Options, Report,
      Cancel.Token);

    for I := 0 to High(Report.Pages) do
      if Report.Pages[I].Status = popsFailed then
        Writeln(Format('page %d failed: %s',
          [Report.Pages[I].PageNumber, Report.Pages[I].ErrorMessage]));
    Writeln(Format('%d inserted, %d rejected, %d skipped, %d failed',
      [Report.InsertedWordCount, Report.RejectedWordCount,
       Report.SkippedPageCount, Report.FailedPageCount]));

    if not Report.Cancelled and (Report.InsertedWordCount > 0) then
      Pdf.SaveAs('scanned-contract-searchable.pdf');
  finally
    Pdf.Free;
  end;
end;
Niezapisywanie po anulowaniu to kwestia osądu i właśnie taki wybór tu zapadł. Anulowane zadanie zostawia plik przeszukiwalny w pierwszej części i pusty w reszcie, a nic w PDF nie mówi następnemu czytelnikowi, gdzie warstwa się urywa. Ponowne przetworzenie całego dokumentu później jest tańsze niż tłumaczenie się z częściowo zaindeksowanego archiwum
SkipPagesWithText ma domyślnie True i sprawdza, czy strona już daje jakiekolwiek ekstrahowalne znaki. To trzyma strony natywne cyfrowo z dala od OCR, zapobiega drugiej warstwie w plikach przetwarzanych wcześniej i sprawia, że powtórny przebieg po tym samym wyjściu jest operacją pustą. Druga strona medalu: pojedynczy prawdziwy znak się liczy, więc skan z numerem Batesa wytłoczonym jako prawdziwy tekst zostanie zgłoszony jako popsSkippedExistingText i nie dostanie warstwy. Archiwa zbudowane w ten sposób potrzebują SkipPagesWithText := False i ostrożnego zakresu stron przez FirstPage i LastPage, w przeciwnym razie wcześniej przetworzone strony dostaną zduplikowaną warstwę, a ekstrakcja zwróci każde słowo dwukrotnie
Budżety pikseli, anulowanie i wycofywanie per strona
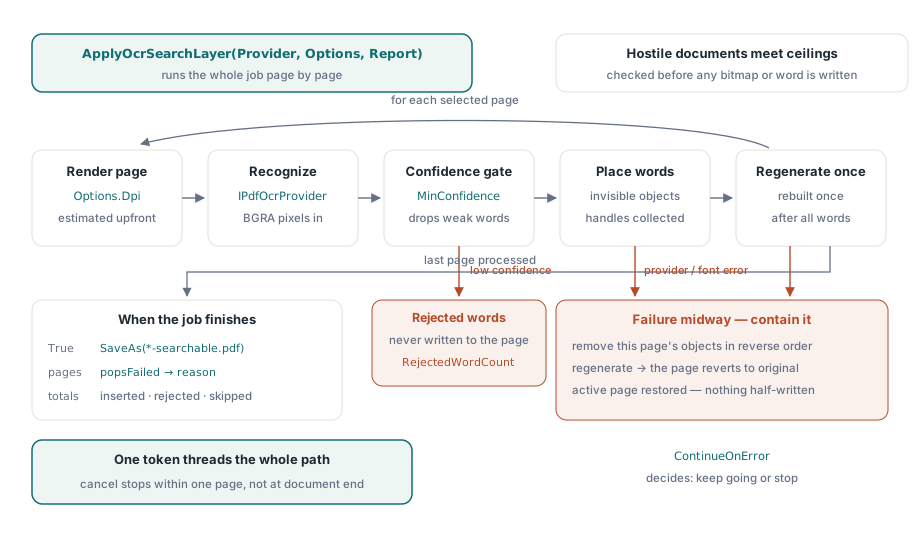
Każda wielkość, którą wrogi albo zwyczajnie ogromny dokument potrafi rozdąć, ma pułap w TPdfOcrOptions, a kontrole pikseli lecą, zanim jakakolwiek mapa bitowa zostanie zaalokowana. Rozmiar renderowania to Ceil(PageWidth * Dpi / 72) na Ceil(PageHeight * Dpi / 72), więc liczby można policzyć z wyprzedzeniem:
| Strona przy 300 DPI | Mapa bitowa | Pikseli |
|---|---|---|
| US Letter, 612 × 792 pt | 2550 × 3300 | 8,415,000 |
| A4, 595 × 842 pt | 2480 × 3509 | 8,702,320 |
| A3, 842 × 1191 pt | 3509 × 4963 | 17,415,167 |
| A0, 2384 × 3370 pt | 9934 × 14042 | 139,493,228 |
Domyślnie jest to 100 milionów pikseli na stronę i miliard na całe zadanie. Rysunek A0 przy 300 DPI przekracza więc MaxPixelsPerPage w pojedynkę. Budżet na całe zadanie wyczerpie się wcześniej niż ten na stronę: przy 8 415 000 pikseli na stronę Letter pod miliard mieści się 118 stron, a strona 119 zawodzi z komunikatem wymieniającym MaxTotalPixels, podobnie jak każda kolejna po niej. Dla długich zeskanowanych archiwów podnieś MaxTotalPixels jak w przykładzie wyżej albo podziel pracę na zakresy przez FirstPage i LastPage. Pominięte strony nie są nigdy renderowane i nie liczą się. Dołączony adapter Tesseract dodaje własny limit, TPdfTesseractOptions.MaxPixels, domyślnie 16 777 216; arkusz A3 przy 300 DPI jest tuż nad tym limitem, więc partie A3 potrzebują podniesionego limitu adaptera albo niższego DPI
DPI musi mieścić się między 36 a 1200. Podwojenie ze 300 do 600 czterokrotnie zwiększa mapę bitową, a każdy piksel kosztuje 4 bajty, więc strona Letter rośnie z około 34 MB BGRA do około 135 MB. Dla zwykłych biurowych skanów 300 DPI równoważy jakość rozpoznawania z pamięcią; 600 opłaca się przy drobnym druku i przypisach, nie przy całych archiwach. Liczby słów ograniczają MaxWordsPerPage i MaxTotalWords, a dostawca, który zwróci więcej słów, niż strona pozwala, zawala tę stronę zamiast zostać skróconym
Token anulowania sięga progresywnego renderowania, wywołania dostawcy i pętli wstawiającej słowa. Anulowanie w trakcie rozpoznawania strony 212 w pliku o 400 stronach zatrzymuje pracę na stronie 212, o ile dostawca uszanuje przekazany token. Adapter Tesseract idzie krok dalej i rejestruje callback anulowania w silniku, obok domyślnego limitu czasu 60 000 ms na stronę
Powstrzymywanie awarii działa per strona. Warstwa zapamiętuje uchwyt każdego wstawianego obiektu tekstowego i wywołuje FPDFPage_GenerateContent raz, po umieszczeniu ostatniego słowa na danej stronie. Jeśli cokolwiek zawiedzie po drodze — font odmawiający znaku albo anulowanie wpadające w środku pętli — obiekty już wstawione na tej stronie są usuwane w odwrotnej kolejności, a treść strony jest regenerowana, więc strona wraca do stanu sprzed wywołania. Pętla dalej kontynuuje albo się zatrzymuje zgodnie z ContinueOnError, a strona aktywna przed wywołaniem jest znowu aktywna po nim
Sprawdzanie wyniku
Dwie kontrole pokrywają większość tego, co może pójść nie tak. Pierwsza jest wizualna: wyrenderuj jedną stronę z oryginalnego pliku i tę samą stronę z przetworzonego w tym samym rozmiarze przez TPdf.RenderPage, a potem porównaj mapy bitowe. Oczekiwany wynik: identyczne, bo tryb 3 niczego nie maluje, a strumień obrazu nie został ruszony; jakakolwiek różnica pikseli oznacza, że stronę zmieniło coś innego niż warstwa tekstu. Druga sprawdza, że słowa istnieją i siedzą tam, gdzie pokazuje skan:
procedure CheckOcrPage(Pdf: TPdf; PageNo: Integer; const Probe: WString);
const
  TEXT_MODE_INVISIBLE = 3;   // FPDF_TEXTRENDERMODE_INVISIBLE
var
  TextObjects: TPdfIntegerArray;
  I, Invisible, Hit: Integer;
  Box: TPdfRectangle;
begin
  Pdf.PageNumber := PageNo;
  TextObjects := Pdf.GetObjectsByType(otText);
  Invisible := 0;
  for I := 0 to High(TextObjects) do
    if Pdf.GetTextRenderMode(TextObjects[I]) = TEXT_MODE_INVISIBLE then
      Inc(Invisible);
  Writeln(Format('page %d: %d invisible text objects', [PageNo, Invisible]));

  Hit := Pdf.FindFirst(Probe);
  if Hit >= 0 then
  begin
    Box := Pdf.CharacterRectangle[Hit];
    Writeln(Format('"%s" starts at x=%.1f, y=%.1f pt',
      [Probe, Box.Left, Box.Bottom]));
  end;
end;
Wybierz słowo probiercze, które na skanie znajdziesz okiem — nagłówek albo sumę — i porównaj zgłoszone współrzędne z jego pozycją w wyrenderowanym obrazie. Na stronie z CropBoxem z otwarcia wartość x powinna startować od 36 lub więcej, nigdy blisko zera. Stronę ekstrakcji omawia głębiej ekstrakcja tekstu z dokumentów PDF, renderowanie stron pod nakładkę wyrównawczą konwersja stron PDF do JPEG, a wzorzec tokenu używany w całym komponencie anulowalne renderowanie progresywne
Nakładanie warstwy OCR siedzi obok renderowania, ekstrakcji tekstu i edycji stron na tym samym obiekcie TPdf, w Delphi, C++Builder i Lazarus. Edycje i pełna lista API są na stronie produktu PDFium Component for Delphi