Załataj tablicę liścia, żeby dodać jedną nazwę, a wpis wciąż może czytać się jako brakujący. PDFium Component odpowiada na to TPdfTreeEditor, ogólnym edytorem drzew nazw i drzew liczb ISO 32000: ładuje drzewo ze ścisłą walidacją, edytuje wpisy w pamięci, przebudowuje zbalansowany zestaw węzłów z poprawnymi /Limits i zapisuje zweryfikowaną rewizję inkrementalną
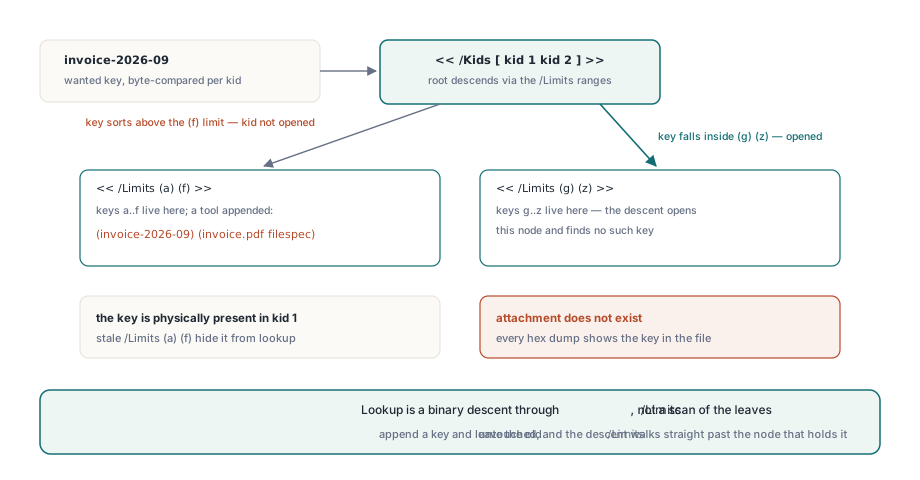
Awaria, która zmotywowała ten unit, jest z tego rodzaju, który diagnozuje się tylko czytaniem bajtów. Narzędzie dopisuje klucz i wartość do liściowej tablicy /Names, zapisuje nową rewizję, a każdy hex dump potwierdza, że klucz jest w pliku. Acrobat wciąż mówi, że załącznik nie istnieje. Nic nie jest zepsute w naiwnym sensie. Drzewo po prostu nie jest już drzewem, po którym algorytm wyszukiwania potrafi zejść
Czemu poprawiona łata tablicy liścia psuje wyszukiwanie?
Bo wyszukiwanie to binarny zstęp przez /Limits, a nie skan liści. ISO 32000-1 §7.9.6 definiuje drzewo nazw jako korzeń, którego /Kids prowadzą w dół do liści trzymających /Names, tablicę naprzemiennych kluczy i wartości, z kluczami uporządkowanymi porównaniem bajtowym w całym drzewie, a każdy węzeł niebędący korzeniem deklaruje /Limits jako swój najmniejszy i największy klucz. Zgodny czytnik porównuje szukany klucz z każdym zakresem dziecka i otwiera dokładnie jedno dziecko. Dopisz klucz do liścia, zostaw stare /Limits nietknięte, a zstęp przechodzi obok węzła, który faktycznie go trzyma
Drzewa liczb (§7.9.7) mają ten sam kształt z /Nums i kluczami całkowitymi i niosą prawdziwy ruch: /PageLabels w §12.4.2 to drzewo liczb, a kategorie /Names katalogu z §7.7.4 dają ci /Dests, /EmbeddedFiles i /JavaScript jako drzewa nazw. Cztery niezmienniki muszą więc trzymać się razem, nie pojedynczo. Klucze muszą być ściśle rosnące w porządku drzewa, każdy poziom musi publikować limity pasujące do swojego faktycznego zakresu kluczy, zakresy rodzeństwa nie mogą na siebie nachodzić, a numer obiektu i generacja korzenia muszą zostać dokładnie tam, gdzie były, bo katalog i każdy inny odwołujący się wskazuje ten korzeń referencją pośrednią. Nasza notka o pracy z załącznikami PDF w Delphi pokazuje konsumencką stronę tej samej struktury
Czego TPdfTreeEditor odmawia załadowania?
Więcej, niż byś się spodziewał, i celowo. TPdfTreeEditor.TryLoad przechodzi graf węzłów przez TPdfSparseDictionaryReader, rozwiązując każde dziecko przez ReadDictionary na dokładnej generacji wskazanej referencją, zamiast przyjmować tę rewizję, która akurat jest aktywna. Drzewo, którego nie da się dowieść jako poprawnie uformowane, jest odrzucane, zanim wolno będzie jakąkolwiek edycję, co powstrzymuje zepsute wejście przed staniem się wiarygodnie wyglądającym zepsutym wyjściem
- Cykle i powtórzone referencje, oba raportowane jako
ptviCycle, więc wpis/Kidswskazujący w górę łańcucha kończy się zamiast rekursji - Mieszane kształty węzłów: słownik niosący
/Kidsrazem z/Nameslub/NumstoptviInvalidNodeShape, podobnie jak pusty liść niebędący korzeniem - Nieposortowane lub zduplikowane klucze, raportowane jako
ptviUnsortedKeyiptviDuplicateKey, sprawdzane przez cały przebieg, nie wewnątrz jednego liścia - Limits niezgodne z faktycznie obecnymi kluczami, raportowane jako
ptviInvalidLimits - Surowa wartość, która nie jest dokładnie jednym kompletnym obiektem PDF, raportowana jako
ptviInvalidValue - Przekroczenia budżetu:
ptviDepthLimit,ptviNodeLimit,ptviEntryLimitiptviDeadlineExceeded, ograniczane zarówno przezTPdfTreeEditOptions, jak i centralny budżet parsera
TPdfTreeEditOptions.Default ustawia te lokalne dla drzewa limity na 1 000 000 wpisów, 100 000 węzłów, głębokość 64, 64 wpisy na liść i 32 dzieci na węzeł. Liczby liści i dzieci to nie tylko strażnicy; to fan-out używany później przy przebudowie drzewa, dlatego rekord waliduje, że obie są co najmniej równe dwa
uses
  FPdfCompress;

var
  Options: TPdfTreeEditOptions;
  RootRef: TPdfTreeObjectReference;
  Editor: TPdfTreeEditor;
  Report: TPdfTreeValidationReport;
begin
  Options := TPdfTreeEditOptions.Default;
  RootRef.ObjectNumber := EmbeddedFilesRootObject;   { katalog /Names /EmbeddedFiles }
  RootRef.Generation := EmbeddedFilesRootGeneration;
  if not TPdfTreeEditor.TryLoad(Source, ptkName, RootRef, Options,
    Editor, Report) then
  begin
    Writeln('tree rejected: ', Report.ErrorMessage);
    Exit;
  end;
  try
    { wartość to surowe bajty jednego kompletnego obiektu PDF }
    Editor.UpsertName('invoice-2026-09',
      '<< /Type /Filespec /F (invoice.pdf) /EF << /F 42 0 R >> >>');
    Editor.RemoveName('draft-2025-11');
  finally
    { Editor.Free po zapisie poniżej }
  end;
end;
Wartości wpisów pozostają surowymi bajtami obiektów PDF
Wartość wpisu jest przechowywana wiernie i to jedyna decyzja projektowa, która czyni edytor bezpiecznym do wskazywania na pliki, których nie wyprodukowałeś. TPdfTreeEntry trzyma NameKey, NumberKey i RawValue, a RawValue to surowy ciąg bajtów jednego kompletnego obiektu PDF: słownika, tablicy, stringa, referencji do strumienia albo gołej referencji pośredniej. Nic nie jest dekodowane do varianta Delphi, TStrings czy typowanego rekordu. Zysk to lossless round-trip wartości, o których unit nic nie wie. /Filespec z rozszerzeniem od producenta, tablica miejsca docelowego z nietypowym typem dopasowania, słownik akcji /JavaScript z prywatnymi kluczami — wszystko przetrwa przebudowę bajt po bajcie, bo edytor nigdy nie miał opinii o ich zawartości. To też zwęża API modyfikacji do czegoś dowodliwego: UpsertName i UpsertNumber muszą tylko sprawdzić, że dostarczona wartość parsuje się jako dokładnie jeden kompletny obiekt, a RemoveName, RemoveNumber i Clear tylko ruszają listę wpisów
Jak przebudowuje się zbalansowane drzewo bez przenumerowania korzenia?
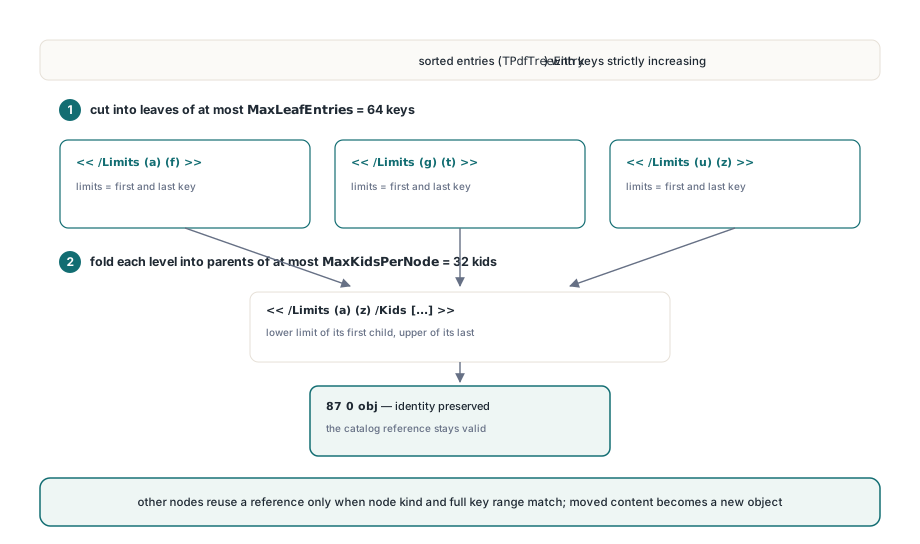
W dwóch przebiegach z jednym punktem stałym. BuildBalancedObjects najpierw tnie posortowaną listę wpisów na liście o co najwyżej MaxLeafEntries, potem składa każdy poziom w rodziców o co najwyżej MaxKidsPerNode i powtarza, aż zostanie jeden węzeł. Limity są liczone od dołu: liść bierze swój pierwszy i ostatni klucz, węzeł wewnętrzny dolną granicę pierwszego dziecka i górną granicę ostatniego, więc nachodzące zakresy rodzeństwa nie mogą powstać z konstrukcji
Punkt stały to tożsamość. Finalny korzeń zawsze dostaje numer obiektu i generację, z którymi drzewo zostało załadowane, więc referencja katalogu zostaje ważna i nic innego w dokumencie nie wymaga przepisania. Każdy inny węzeł reużywa referencji wcześniej załadowanego węzła tylko wtedy, gdy rodzaj węzła się zgadza i pełny zakres kluczy się zgadza, a w przeciwnym razie dostaje świeży numer przydzielony z aktywnego maksymalnego numeru obiektu plus jeden. Ta kombinacja trzyma niezmienione poddrzewa wskazujące swoje istniejące obiekty, gwarantując zarazem, że każdy węzeł, którego zawartość się przesunęła, jest zapisany jako nowy obiekt, a nie po cichu zinterpretowany ponownie. Ta sama dyscyplina reużycia referencji napędza edytor konspektu i jego remapowanie stron w siostrzanym unitcie
var
  Serialized: TPdfTreeSerializedObjects;
  I: Integer;
begin
  { FirstNewObjectNumber pochodzi z rewizji źródłowej }
  if Editor.BuildBalancedObjects(MaximumObjectNumber + 1,
    Serialized, Report) then
  begin
    Writeln('nodes ', Report.NodeCount, ' depth ', Report.MaximumDepth);
    for I := 0 to High(Serialized) do
      Writeln(Serialized[I].Reference.ObjectNumber, ' ',
        Serialized[I].Reference.Generation, ' obj');
  end
  else
    for I := 0 to High(Report.Issues) do
      Writeln('issue ', Ord(Report.Issues[I].Kind), ' at obj ',
        Report.Issues[I].ObjectNumber, ': ', Report.Issues[I].Message);
end;
Zapisz rewizję, potem przeczytaj wynik z powrotem
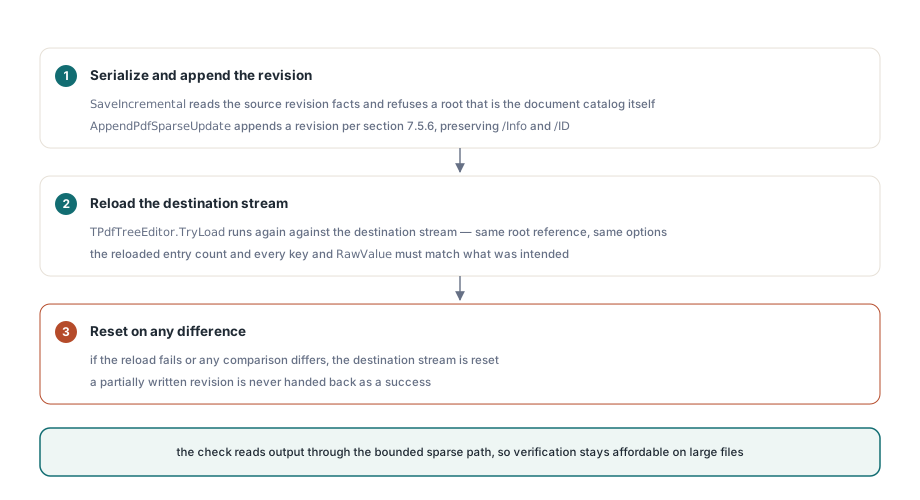
Zapis jest skończony dopiero, gdy wynik został ponownie otwarty i porównany. SaveIncremental czyta fakty rewizji źródłowej, odmawia korzenia będącego samym katalogiem dokumentu, serializuje zbalansowany zestaw węzłów plus obiekt katalogu i przekazuje wszystko do AppendPdfSparseUpdate, który dopisuje nową rewizję zgodnie z §7.5.6, zachowując istniejącą referencję /Info i tablicę /ID dokumentu
Potem przychodzi część, którą warto przepisać do własnych pisarzy. Edytor wywołuje TPdfTreeEditor.TryLoad ponownie, tym razem na strumieniu docelowym, z tą samą referencją korzenia i tymi samymi opcjami, i porównuje ponownie załadowaną liczbę wpisów oraz każdy klucz i RawValue z tym, co zamierzał zapisać. Jeśli przeładowanie się nie powiedzie albo którekolwiek porównanie się różni, strumień docelowy jest resetowany zamiast zwracany, więc częściowo zapisana rewizja nigdy nie wraca jako sukces. Weryfikacja czyta wynik przez tę samą ograniczoną ścieżkę sparse, opisaną w naszym tekście o sparse lazy indeksie obiektów PDF, i to właśnie trzyma sprawdzanie tanim na dużych plikach
var
  Dest: TFileStream;
begin
  Dest := TFileStream.Create(OutputName, fmCreate);
  try
    if Editor.SaveIncremental(Source, Dest, Report) then
      Writeln('wrote ', Report.NodeCount, ' nodes, ',
        Report.EntryCount, ' entries')
    else
      { strumień docelowy już zresetowany, nic na wpół zapisanego nie zostało }
      Writeln('save refused: ', Report.ErrorMessage);
  finally
    Dest.Free;
    Editor.Free;
  end;
end;
Zaszyfrowane źródła są odrzucane i to jest uczciwe
Obecna implementacja odrzuca zaszyfrowane źródło wprost. Powód jest konkretny, a nie obronny: przebudowa drzewa wprowadza nowe obiekty stringów i może wprowadzić nowe referencje do strumieni, a §7.6 wymaga, żeby były szyfrowane per obiekt kluczem dokumentu oraz numerem obiektu i generacją właściciela. Skopiowanie wpisu /Encrypt z traila do przodu przy dopisywaniu jawnych stringów dałoby plik, który otwiera się, a potem czyta jako śmieci dokładnie tam, gdzie są twoje nowe klucze, co jest gorsze niż jasna odmowa. Warto wprost podać jeszcze dwie granice. Edytor pracuje na migawce strumienia źródłowego, więc źródła nie wolno modyfikować, dopóki żyje nad nim edytor, i odmawia traktowania katalogu dokumentu jako korzenia drzewa, bo katalog to słownik, który akurat zawiera drzewa, a nie sam węzeł drzewa. Jeśli utrzymujesz kod w Delphi, C++Builderze albo Lazarusie, który zapisuje /EmbeddedFiles, /Dests, /JavaScript lub /PageLabels, i łatałeś tablice liści ręcznie, edytor drzew i jego weryfikowany zapis inkrementalny są w komponencie PDFiumPas dla Delphi PDFium