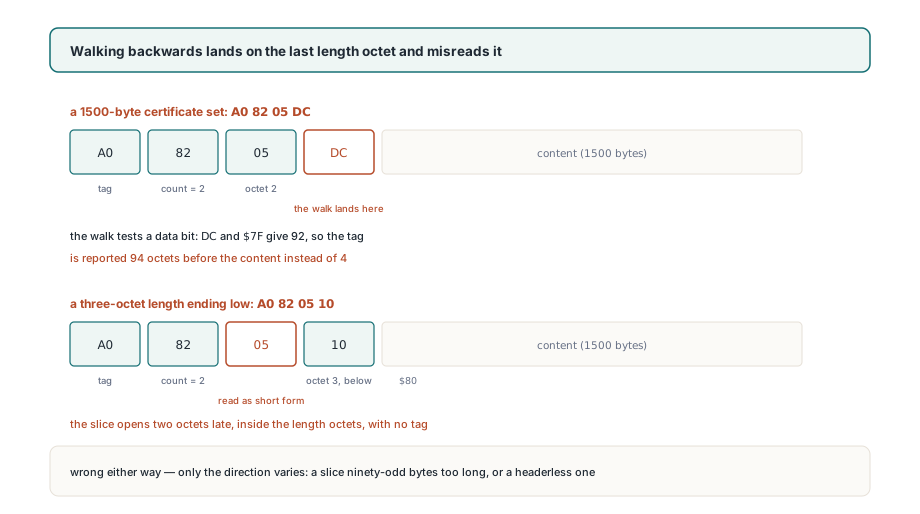
Cztery bajty A0 82 05 DC otwierają element kontekstowy [0] niosący 1500 bajtów treści. Czytane od lewej do prawej są jednoznaczne: tag A0, wstępny bajt długości 82 zapowiadający dwa kolejne, potem 05 DC. Czytane od prawej do lewej, zaczynając od pierwszego bajtu treści, pierwszym bajtem, jaki spotykasz, jest DC. Ma ustawiony górny bit, a jego dolne siedem bitów mówi 92, więc pomocnik, który mu ufa, zgłasza tag 94 bajty przed treścią. Prawdziwa odległość to 4
Nikt nie chodzi wstecz naumieńście. To się zdarza, bo większość czytników DER oddaje offset treści i długość każdego elementu — dokładnie to, czego potrzebujesz, by w niego zejść — podczas gdy skopiowanie elementu sąsiedniego bez zmian potrzebuje offsetu jego tagu. Odejmowanie od offsetu treści wygląda jak robota na dwie linie i pozostaje poprawne, dopóki każda długość mieści się w jednym bajcie. Długość prawdziwego zbioru certyfikatów nigdy w jednym się nie mieści
Co znacznik czasu podpisu robi z podpisanym CMS
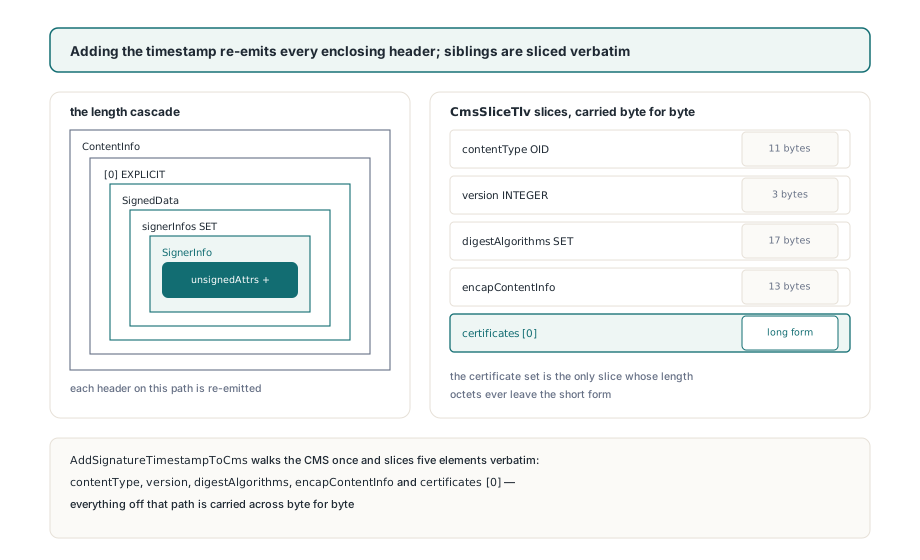
Dodanie znacznika czasu PAdES B-T wymusza rekodowanie każdego otaczającego nagłówka CMS, przy czym pięć elementów sąsiednich musi przejść bajt po bajcie. Atrybut znacznika czasu podpisu, który ETSI EN 319 122-1, punkt 5.3, definiuje pod OID-em 1.2.840.113549.1.9.16.2.14, mieszka w unsignedAttrs SignerInfo z RFC 5652, punktu 5.3, a token RFC 3161 wewnątrz niego jest liczony po wartości podpisu. CMS jest więc już zbudowany i już podpisany, gdy token przychodzi od TSA. Jeden dodatkowy atrybut wydłuża SignerInfo, co wydłuża zbiór signerInfos, potem SignedData, potem opakowanie [0] EXPLICIT, potem zewnętrzne ContentInfo
W PDFium Component ta sekwencja to trzy eksportowane wywołania w FPdfCms.pas i FPdfTsa.pas. SignPadesBytes puszczają za ciebie, gdy TPadesSignOptions.Level to plB_T lub wyżej i TsaUrl jest ustawiony, a podnosi EPadesCrypto, gdy poziom B-T jest żądany z pustym TsaUrl, zamiast zapisywać zwykły podpis B-B. Jeśli budujesz CMS sam przez BuildSignedData, łańcuch wygląda tak
// CmsDer trzyma ContentInfo zwrócony przez BuildSignedData.
// SignPadesBytes wykonuje te same trzy kroki, gdy Options.Level >= plB_T
var
  SigValue: TBytes;
  Ts: TPadesTimestamp;
begin
  if not ExtractSignatureValue(CmsDer, SigValue) then
    raise Exception.Create('CMS carries no signature value');
  // messageImprint TSA jest liczony po bajtach wartości podpisu
  Ts:= RequestTimestamp(TsaUrl, SigValue, Nonce);
  // Rekoduje SignerInfo aż po ContentInfo, kopiuje sąsiadów bez zmian
  AddSignatureTimestampToCms(CmsDer, Ts.TokenDer);
end;
AddSignatureTimestampToCms przenosi pięć elementów nietkniętych: OID contentType, INTEGER wersji SignedData, zbiór digestAlgorithms, SEQUENCE encapContentInfo i, gdy jest, zbiór certificates [0]. W CMS, który BuildSignedData emituje z SHA-256, cztery z nich są malutkie: 11 bajtów na OID, 3 na wersję, 17 na zbiór algorytmów digestu, 13 na odłączony encapContentInfo. Zbiór certyfikatów trzyma certyfikat podpisującego, po którym idzie każdy certyfikat łańcucha, który podałeś. Prawdziwy certyfikat X.509 sięga kilkuset bajtów. To jedyny wycinek, którego bajty długości zawsze używają formy długiej
Dlaczego po bajtach długości DER nie można chodzić wstecz?
Liczba bajtów długości jest zapisana w pierwszym z nich, a chód wstecz spotyka najpierw ostatni. X.690, punkt 8.1.3.4, definiuje formę krótką: jeden bajt, bit 8 wyzerowany, bity 7 do 1 trzymające długość od 0 do 127. Punkt 8.1.3.5 definiuje formę długą. Jej wstępny bajt ma ustawiony bit 8, a bity 7 do 1 liczą kolejne bajty trzymające długość jako bezznakową liczbę big-endian. Nic nie oznacza bajtu kolejnego jako kolejnego. Jego bit 8 to bit wartości jak pozostałe siedem. Pomocnik testujący więc górny bit Buf[ContentOffs- 1] testuje dane, a potem czyta dane jako liczbę
// Kuszący pomocnik, dostający wyłącznie offset treści. Nie wysyłaj tego w świat
function NaiveHeaderStart(const Buf: TBytes; ContentOffs: Integer): Integer;
var
  P, LenByte: Integer;
begin
  P:= ContentOffs- 1;            // ląduje na OSTATNIM bajcie długości
  if P< 0 then
    Exit(ContentOffs);
  LenByte:= Buf[P];
  if (LenByte and $80)= 0 then   // ma sens tylko dla PIERWSZEGO
    Result:= P- 1
  else
    Result:= P- (LenByte and $7F)- 1;
end;

// A0 82 05 DC (1500 bajtów): Buf[ContentOffs- 1]= $DC, $DC and $7F= 92
//   Result= ContentOffs- 94, tag siedzi na ContentOffs- 4
// A0 82 05 10 (1296 bajtów): $10 ma wyzerowany bit 8, czytane jako forma krótka
//   Result= ContentOffs- 2, co wskazuje na 05 wewnątrz bajtów długości
Oba kierunki porażki wychodzą przy zwykłych rozmiarach. Zbiór certyfikatów 1500 bajtów kończy nagłówek na DC i pomocnik zaczyna wycinek 90 bajtów za wcześnie. Zbiór 1296 bajtów kończy na 10, pomocnik bierze to za długość w formie krótkiej i wycinek zaczyna się dwa bajty za późno, bez żadnego tagu. O tym, czy dany łańcuch wpadnie w pierwszy czy drugi przypadek, rozstrzyga nic poza niskim bajtem jego całkowitej długości
Wczesny przypadek potrafi też przebiec przed początek bufora. Dla CMS ułożonego tak, jak układa go BuildSignedData — z każdym otaczającym lengthiem na dwóch bajtach — treść zbioru certyfikatów zaczyna się na 60 bajcie: 4 na nagłówek ContentInfo, 11 na OID, po 4 na nagłówki [0] i SignedData, potem 3, 17 i 13 na małych sąsiadów i 4 na nagłówek zbioru certyfikatów. Odejmij 94 od 60, a pomocnik zwróci -34. Jego jedyna straż siedzi na ContentOffs- 1, więc ujemny wynik leci wprost do kopiowania
Co punkt 10.1 X.690 przybija
DER czyni kodowanie długości czystą funkcją długości. X.690, punkt 10.1, ogranicza DER do formy określonej i wymaga minimalnej liczby bajtów, co usuwa dwie wolności, na które pozwala BER: formę nieokreśloną i długość w formie długiej wyściełaną zerami wiodącymi. Pod tą regułą długość treści poniżej 128 zawsze bierze dokładnie jeden bajt długości. Jakakolwiek inna długość bierze jeden bajt wstępny plus dokładnie tyle bajtów kolejnych, ile znaczących bajtów ma wartość. To daje 81 80 dla 128. Przy 256 nagłówek rośnie do 82 01 00, a 65536 potrzebuje 83 01 00 00. Kod, który już trzyma długość treści, potrafi wyliczyć rozmiar nagłówka, nie czytając ani bajtu bufora
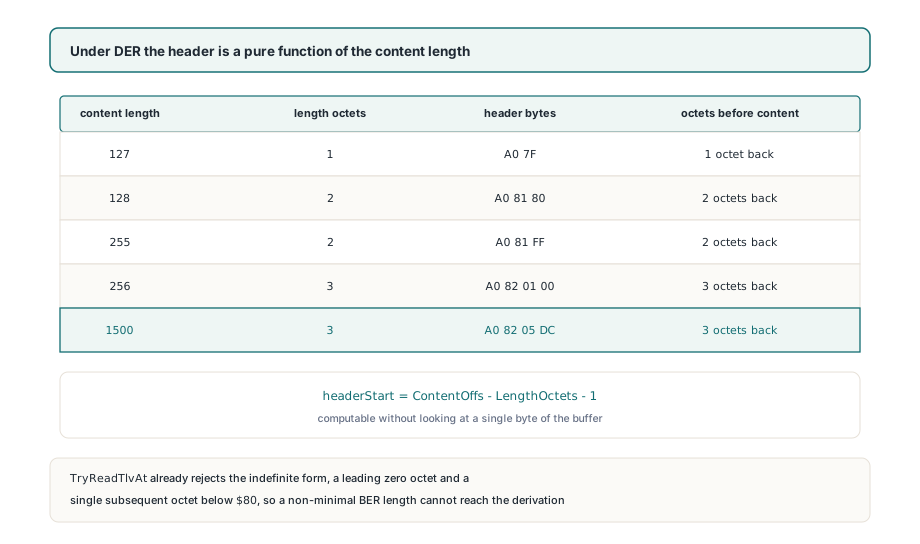
Wyprowadzenie jest tylko tak dobre, jak twierdzenie, że wejście naprawdę jest DER. TDerReader.TryReadTlvAt egzekwuje to twierdzenie, zanim dojdzie do jakiegokolwiek cięcia. Odrzuca wstępny bajt długości $80 (formę nieokreśloną), długość w formie długiej, której pierwszy bajt kolejny jest zerem, pojedynczy bajt kolejny poniżej $80, który powinien był być formą krótką, i więcej niż cztery bajty kolejne. ReadTlv jest zbudowany na TryReadTlvAt, więc każdy element, po którym chodzi AddSignatureTimestampToCms, zdążył już przejść te kontrole. Wyściełany w stylu BER length nigdy nie dociera do arytmetyki
Wewnątrz AddSignatureTimestampToCms offset tagu każdego sąsiada jest wyprowadzany z jego offsetu treści i długości treści właśnie tak. Gdy wyprowadzony start wypada przed początkiem bufora — czyli offsety nie mogą do siebie należeć — procedura podnosi wyjątek z komunikatem CMS: TLV header precedes the buffer start i nie produkuje żadnego CMS. Zniekształcona przebudowa, która nadal się parsuje, jest dużo trudniejsza do wyśledzenia niż wyjątek w miejscu, gdzie offsety przestały się zgadzać
Wyprowadzenie niesie jedno założenie więcej: identyfikator bierze jeden bajt. X.690 pozwala na identyfikatory wielobajtowe dla numerów tagów od 31 wzwyż i TryReadTlvAt umie je parsować. CMS SignedData nigdy takiego nie używa, bo jego tagi to uniwersalne SEQUENCE, SET, INTEGER i OID plus kontekstowe [0] i [1], więc założenie trzyma dla każdego elementu, którego dotyka przebudowa ze znacznikiem czasu
Kopiowanie elementów sąsiednich we własnym kodzie DER
Jeśli piszesz kod względem TDerReader, pomiń wyprowadzanie w ogóle. PeekTlv i ReadNextTlv wypełniają rekord TDerTlv, którego Offset już wskazuje tag, a HeaderLength to zmierzony rozmiar tagu plus bajtów długości, i EncodedBytes zwraca element od Offset do NextOffset. Ta droga radzi sobie też z identyfikatorami wielobajtowymi, których żadna arytmetyka długości nie odzyska. ReadTlv z czterema parametrami wyjściowymi jest wygodny do schodzenia w głąb. Zgłasza jednak tylko stronę treści, więc sięgaj po niego, gdy potrzebujesz treści, a po formę rekordu, gdy potrzebujesz całego elementu
// Każde dziecko SignedData jako kompletny TLV: tag, bajty długości, treść.
// TDerTlv.Offset wskazuje tag, więc żadna arytmetyka nagłówków nie uczestniczy
function SignedDataChildren(const CmsDer: TBytes): TDerByteArrays;
var
  Root, Ci, Explicit0, Sd: TDerReader;
  Tlv: TDerTlv;
begin
  Result:= nil;
  Root.Initialize(CmsDer);
  if not Root.ReadNextTlv(Tlv) or not Root.EnterConstructed(Tlv, Ci) then
    raise Exception.Create('ContentInfo SEQUENCE expected');
  if not Ci.SkipTlv then                            // contentType OID
    raise Exception.Create('contentType OID expected');
  if not Ci.ReadNextTlv(Tlv) or not Ci.EnterConstructed(Tlv, Explicit0) then
    raise Exception.Create('[0] EXPLICIT content expected');
  if not Explicit0.ReadNextTlv(Tlv) or not Explicit0.EnterConstructed(Tlv, Sd) then
    raise Exception.Create('SignedData SEQUENCE expected');
  while not Sd.AtEnd do
  begin
    if not Sd.ReadNextTlv(Tlv) then
      raise Exception.Create('SignedData child malformed');
    SetLength(Result, Length(Result)+ 1);
    Result[High(Result)]:= Sd.EncodedBytes(Tlv);   // np. A0 82 05 DC ...
  end;
end;
Dla przypadków, gdy jakieś inne API daje ci nic poza offsetem treści i długością, wyprowadzenie w przód jest krótkie. DerHeaderStart — pokazany ze swoją kontrolą brzegową w następnej sekcji — to twój własny kod; odwzorowuje regułę z punktu 10.1 i zwraca -1 dla offsetów, które nie mogą być spójne, więc wołający dostaje wartość, którą może odrzucić, a nie wyglądająco wiarygodny bajt startu
Dlaczego krótkie testowe certyfikaty chowają błąd?
Mały certyfikat zastępczy trzyma zbiór certyfikatów w formie krótkiej, a chód wstecz jest poprawny dokładnie dla tego przypadku. Zbiór 32 bajtów koduje się jako A0 20, a 64 bajty jako A0 40. Krok wstecz od treści ląduje na tym pojedynczym bajcie długości, a jego górny bit jest wyzerowany, bo jest pierwszym i jedynym. Poprawna odpowiedź, niewłaściwy powód. Test znacznika czasu zbudowany na tak małych certyfikatach umie sparsować wynik od nowa, znaleźć atrybut, zgłosić B-T i ani razu nie przepuścić przez wycinek zbioru certyfikatów realistycznego rozmiaru
Każda ścieżka kodu zależna od tego, jak długość jest zakodowana, potrzebuje wejścia testowego przekraczającego granicę kodowania. Dla DER znaczy to treść od 128 bajtów wzwyż, która wymusza formę długą, i od 256 bajtów wzwyż, która wymusza drugi bajt kolejny. Kontrola poniżej porównuje DerHeaderStart z nagłówkiem zmierzonym przez czytnik podczas parsowania — na obu granicach i na przypadku 1500 bajtów z otwarcia. Niesortowany SET OF w signedAttrs przeskakuje rundy same-pochodzenia z tego samego powodu strukturalnego: test podaje wyłącznie wejścia, na których zły kod i dobry kod się zgadzają
// Twój własny pomocnik dla API zgłaszających tylko offset treści i długość.
// Zakłada jednobajtowy identyfikator — prawda dla każdego tagu w CMS SignedData
function DerHeaderStart(ContentOffs, ContentLen: Integer): Integer;
var
  LengthOctets, Remaining: Integer;
begin
  LengthOctets:= 1;                  // forma krótka, X.690 8.1.3.4
  if ContentLen>= 128 then
  begin
    Remaining:= ContentLen;          // forma długa, X.690 8.1.3.5
    while Remaining> 0 do
    begin
      Inc(LengthOctets);             // jeden na znaczący bajt
      Remaining:= Remaining shr 8;
    end;
  end;
  Result:= ContentOffs- LengthOctets- 1;
  if Result< 0 then
    Result:= -1;                     // niespójne offsety: niech wołający podniesie
end;

// Kontrola brzegowa, napisana jako twój własny kod testowy: wyprowadzony
// offset tagu musi równać się offsetowi zmierzonemu przez TDerReader przy parsowaniu nagłówka
procedure CheckHeaderDerivation;
const
  Lens: array[0..6] of Integer= (127, 128, 255, 256, 1500, 65535, 65536);
var
  W: TDerWriter;
  R: TDerReader;
  Tlv: TDerTlv;
  Content: TBytes;
  I: Integer;
begin
  W:= TDerWriter.Create;
  try
    for I:= Low(Lens) to High(Lens) do
    begin
      SetLength(Content, Lens[I]);
      R.Initialize(W.Wrap($A0, Content));   // A0 7F / A0 81 80 / A0 82 05 DC ...
      W.Clear;
      if not R.PeekTlv(Tlv) then
        raise Exception.CreateFmt('unreadable TLV for %d bytes', [Lens[I]]);
      if DerHeaderStart(Tlv.ContentOffset, Tlv.ContentLength)<> Tlv.Offset then
        raise Exception.CreateFmt('header start wrong for %d bytes', [Lens[I]]);
    end;
  finally
    W.Free;
  end;
end;
Ta sama granica jest osiągalna od końca do końca przez funkcje eksportowane. Podaj BuildSignedData certyfikaty łańcucha, których łączny rozmiar stawia zbiór certyfikatów tuż pod i tuż ponad 128 i 256 bajty, puść AddSignatureTimestampToCms na każdym wyniku, potem obchódź wyjście przez SignedDataChildren i porównaj element zbioru certyfikatów bajt po bajcie z tym z CMS sprzed dodania znacznika czasu
Co przyjmuje AddSignatureTimestampToCms
AddSignatureTimestampToCms jest napisany pod CMS, który emituje BuildSignedData: jeden SignerInfo, opcjonalny zbiór certificates [0], brak crls [1] i jeszcze brak unsignedAttrs. Podaj mu zbiór signerInfos trzymający więcej niż jeden SignerInfo, a podniesie wyjątek zamiast zatrzymać pierwszego podpisującego i wyrzucić resztę. CMS niosący zbiór crls [1] zatrzymuje się na wyjątku CMS: signerInfos SET expected, bo element po certyfikatach nie jest zbiorem, którego szuka chód. Obie odmowy dzieją się, nim cokolwiek zostanie zapisane z powrotem do CmsDer
Nowy unsignedAttrs trzyma dokładnie jeden atrybut, więc reguła porządkowania SET OF z punktu 11.6 X.690 jest spełniona bez sortowania. Podpisana część SignerInfo — od wersji aż po OCTET STRING podpisu — jest kopiowana jako jeden blok, co znaczy, że walidator przeliczający signedAttrs widzi te same bajty przed i po dodaniu tokenu. Gdy walidator i tak odrzuca dokument, przyczyny zwykle siedzą gdzie indziej i pokrywa je ta checklista powodów odrzuceń PAdES. Co token kupuje ci w czasie i jak na nim budują B-LT i B-LTA, jest w przewodniku po znacznikach czasu RFC 3161 i DSS
Czytnik i writer DER w FPdfAsn1.pas, budowniczy CMS i krok znacznika czasu w FPdfCms.pas to wszystko źródła Pascala dostarczane z PDFium Component for Delphi. Gdy przebudowany SignedData odmawia parsowania w walidatorze, możesz przejść krok po kroku kod, który wyciął każdy element, i zestawić go z punktem X.690, na który się powołuje