Otwórz ten sam PDF faktury na Windows i na telefonie, a łamania wierszy, fonty i logo wylądują w identycznych miejscach. Plik PDF to zbiór numerowanych obiektów plus indeks przesunięć bajtowych, a czytnik, jak silnik PDFium wewnątrz PDFium Component, otwiera go od końca: startxref, tabela xref, katalog, drzewo stron, strumienie zawartości, potem piksele
Czym więc jest plik PDF i czemu wygląda tak samo wszędzie? Dokumenty Word i RTF przechowują tekst i style i zostawiają układ maszynie, która je otwiera, więc brakujący font albo inny sterownik drukarki przełama strony na nowo. PDF przechowuje zamiast tego gotowy wynik. Każdy glif i linia mają absolutną pozycję w przestrzeni współrzędnych mierzonej w punktach, programy fontów podróżują wewnątrz pliku, a obrazy niosą własne dane koloru i filtry kompresji. Nic nie jest układane w chwili oglądania, dlatego każdy zgodny renderer na każdym systemie operacyjnym maluje tę samą stronę. Format zaczął jako PDF 1.0 z Acrobatem w 1993, zbudowany na modelu obrazowania PostScriptu, i każda rewizja dokładała część mechaniki opisanej niżej:
- PDF 1.1 do 1.4 przyniósł szyfrowanie, interaktywne formularze, podpisy cyfrowe ze strukturą logiczną i przezroczystość
- PDF 1.5 dodał strumienie obiektów i strumienie odsyłaczy; PDF 1.6 dodał szyfrowanie AES
- PDF 1.7 stał się ISO 32000-1:2008, a PDF 2.0 stał się ISO 32000-2:2017, zrewidowanym w 2020
- PDF/A (ISO 19005), PDF/X (ISO 15930) i PDF/UA (ISO 14289) zawężają tę bazę dla archiwizacji, produkcji druku i dostępności
Co się dzieje, gdy czytnik otwiera plik PDF?
Otwarcie PDF-a to łańcuch odpytań, który zaczyna się na ostatnich bajtach pliku i kończy bitmapą. Prawie każde ogniwo tego łańcucha to słownik, jeden z podstawowych typów obiektów w ISO 32000-1 §7.3, a słowniki wskazują na siebie referencjami pośrednimi typu 7 0 R (obiekt 7, generacja 0). Plik zachowuje się więc jak graf obiektów, a nie sekwencja stron. Nagłówek, ciało, tabela odsyłaczy i trailer są rozłożone w przeglądzie struktury pliku PDF, a minimalny PDF z adnotacją przy każdej linii pokazuje, jak obj, endobj i stream wyglądają w edytorze tekstu. Oto kolejność, którą idzie każdy czytnik:
- Przeskocz na koniec pliku i przeczytaj przesunięcie bajtowe zapisane po słowie kluczowym
startxref - Wczytaj dane odsyłaczy pod tym przesunięciem, które mapuje każdy numer obiektu na pozycję w pliku
- Przeczytaj trailer i idź za
/Rootdo katalogu dokumentu - Idź za wpisem
/Pageskatalogu w dół drzewa stron do żądanego obiektu strony - Zdekoduj strumień zawartości strony i zinterpretuj jego operatory po kolei
- Rozwiąż fonty, obrazy i Form XObjects, które te operatory nazywają przez
/Resources - Zrastryzuj ścieżki, kontury glifów i obrazy w piksele w rozdzielczości urządzenia
Krok pierwszy: startxref i tabela odsyłaczy
Czytnik nigdy nie skanuje PDF-a od góry. Dobrze uformowany plik kończy się słowem kluczowym startxref, liczbą dziesiętną typu 48211 i %%EOF, i ta liczba to przesunięcie bajtowe danych odsyłaczy. Naiwne wsteczne szukanie xref zatrzymuje się wewnątrz startxref, więc szukaj pełnego słowa kluczowego. Klasyczna tabela używa wpisów o stałej szerokości (§7.5.4), co pozwala czytnikowi wskoczyć do wpisu dowolnego numeru obiektu bez parsowania pozostałych; układ bajtowy każdego wpisu jest omówiony w przeglądzie struktury. Trailer po tabeli nazywa /Size, /Root i opcjonalnie /Encrypt, /ID oraz /Prev
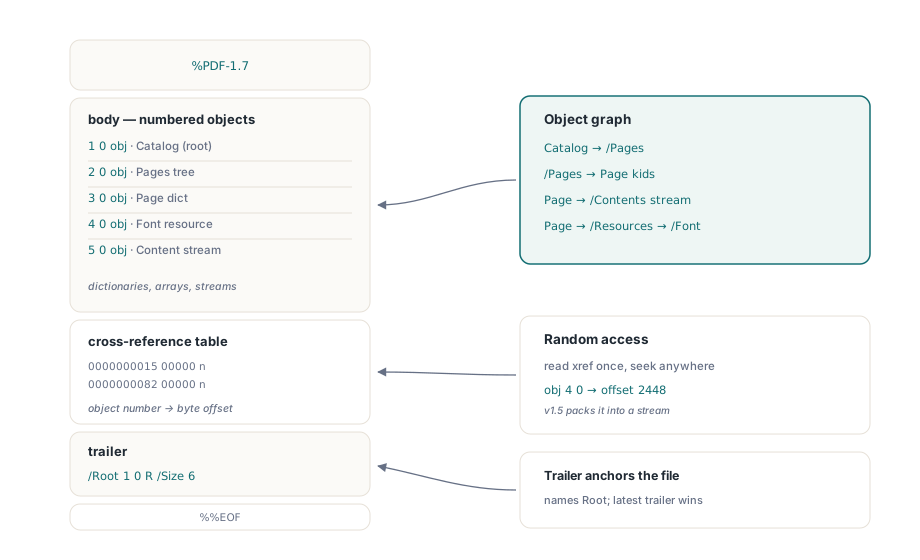
Każdy wpis to absolutna pozycja bajtowa, więc cokolwiek przesuwającego bajty, jak edytor przepisujący zakończenia linii, zostawia indeks wskazujący złe miejsca. Czytniki z przebiegiem naprawczym przebudują go skanując słowa kluczowe obj; czytniki bez niego odmówią pliku, dlatego uszkodzony PDF może otworzyć się w jednej przeglądarce i paść w innej. To, co siedzi pod przesunięciem startxref, mówi ci, w którym przypadku jesteś: słowo kluczowe xref dla klasycznej tabeli, nagłówek N 0 obj dla strumienia odsyłaczy PDF 1.5 i cokolwiek innego dla nieaktualnego przesunięcia. Helper poniżej to twój własny kod, zbudowany na zwykłych strumieniach RTL
uses
  System.SysUtils, System.Classes;

// Twój własny helper: Offset to liczba zapisana po startxref.
// Klasyfikuje, co czytnik znajdzie pod tą pozycją
function DescribeXrefAt(const FileName: string; Offset: Int64): string;
var
  FS: TFileStream;
  Buf: TBytes;
  Head: string;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if Offset >= FS.Size then
      Exit('offset beyond end of file: the file needs a repair pass');
    FS.Position := Offset;
    SetLength(Buf, 32);
    SetLength(Buf, FS.Read(Buf[0], Length(Buf)));
  finally
    FS.Free;
  end;
  Head := TEncoding.ASCII.GetString(Buf);
  if Head.StartsWith('xref') then
    Result := 'classic cross-reference table'
  else if Head.Contains(' obj') then
    Result := 'cross-reference stream (PDF 1.5 or later)'
  else
    Result := 'stale offset: the file needs a repair pass';
end;
Strumień odsyłaczy (§7.5.8) to skompresowany obiekt z /Type /XRef, tablicą /W podającą szerokość bajtową każdej kolumny i binarnymi wierszami, które wskazują albo przesunięcie bajtowe, albo do strumienia obiektów (§7.5.7). Klucze trailera przenoszą się do jego słownika, więc plik nie ma w ogóle słowa kluczowego trailer. HotPDF pisze tę formę, gdy UseXRefStream jest ustawione na THotPDF. Dla plików wychodzących spod twojej kontroli, jak załączniki pocztowe albo uploady do drukarni, klasyczna tabela pozostaje bezpieczniejszym wyborem, bo czytniki starsze niż PDF 1.5 nadal umieją ją sparsować. PDF/A-1 rozstrzyga pytanie dla archiwów: ISO 19005-1 buduje na PDF 1.4, a jego §6.1.4 stanowi, że strumieni odsyłaczy nie wolno używać, więc HotPDF pisze klasyczną tabelę, ilekroć aktywny jest profil PDF/A-1
48 0 obj
<< /Type /XRef /Size 49 /Root 1 0 R
   /W [1 3 1] /Index [0 49]
   /Filter /FlateDecode /Length 162 >>
stream
...binary rows: 1 + 3 + 1 bytes each...
endstream
endobj
startxref
48211
%%EOF
Od /Root do właściwej strony: katalog i drzewo stron
/Root trailera wskazuje katalog dokumentu, a /Pages katalogu wskazuje korzeń drzewa stron. Każdy pośredni węzeł /Pages niesie /Count stron liściastych pod sobą, więc czytnik szukający strony 5000 odejmuje liczniki przy schodzeniu i pomija całe poddrzewa nieotwarte. ISO 32000-1 §7.7.3 nie wymaga drzewa zrównoważonego; pojedyncza tablica /Kids z 10 000 wpisów jest legalna, tylko wolniejsza w przeszukiwaniu. Kod czytający tylko liść wpada w jedną pułapkę. /Resources, /MediaBox, /CropBox i /Rotate są dziedziczne (§7.7.3.4), więc strona bez własnego /MediaBox jest nadal ważna, bo wartość mieszka u przodka
12 0 obj
<< /Type /Page
   /Parent 3 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 7 0 R >> >>
   /Contents 13 0 R
>>
endobj
Media box ustawia przestrzeń współrzędnych dla wszystkiego rysowanego na stronie: początek w lewym dolnym rogu, Y biegnie w górę, jedna jednostka to 1/72 cala, chyba że PDF 1.6 /UserUnit ją przeskaluje. PDFium Component wykonuje całe schodzenie, gdy prosisz o stronę po numerze. TPdf.PageMetrics zwraca rozmiar strony w punktach z odziedziczonymi polami już rozwiązanymi, plus obrót strony, więc listing poniżej raportuje poprawne rozmiary nawet dla plików, których strony liściaste nie niosą własnego pola
uses
  System.SysUtils, PDFium;

// Wypisuje liczbę stron i rozmiar każdej strony w punktach
procedure ListPages(const FileName: string);
const
  Degrees: array[TRotation] of Integer = (0, 90, 180, 270);
var
  Pdf: TPdf;
  I: Integer;
  M: TPdfPageMetrics;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;           // parsuje dane odsyłaczy, trailer i katalog
    if not Pdf.Active then        // nieudane wczytanie zostawia Active = False
      raise Exception.Create('Cannot open ' + FileName);
    Writeln(Pdf.PageCount, ' pages');
    for I := 1 to Pdf.PageCount do
    begin
      M := Pdf.PageMetrics[I];    // liczone od 1; wczytuje stronę przez drzewo
      Writeln(Format('Page %d: %.1f x %.1f pt, /Rotate %d',
        [I, M.Width, M.Height, Degrees[M.Rotation]]));
    end;
  finally
    Pdf.Free;
  end;
end;
Jak PDF rysuje stronę na ekranie?
Widoczna zawartość strony to mały program: operatory postfixowe w jednym albo więcej strumieniach zawartości, interpretowane po kolei po tym, jak czytnik odpali dekoder nazwany w /Filter, najczęściej /FlateDecode. BT otwiera obiekt tekstowy, Tf wybiera zasób fontu i rozmiar, Td przesuwa pozycję tekstu, Tj maluje string, a ET zamyka obiekt. Ścieżki budują m, l, c i re, potem wypełnia f albo kreskuje S. Stan grafiki (§8.4) trzyma to, co te operatory czytają niejawnie, jak macierz transformacji, kolory i ścieżkę przycinania. q odkłada kopię, a Q ją zdejmuje, więc transformacja ustawiona wewnątrz pary nie wycieknie do dalszej zawartości
q
1 0 0 1 72 700 cm     % przesuwa początek do (72, 700)
BT
  /F1 12 Tf           % zasób fontu F1 w 12 punktach
  0 0 Td
  (Invoice 2026-0417) Tj
ET
0.2 0.2 0.8 RG        % kolor kreski, ograniczony przez q/Q
0 -6 m 140 -6 l S
Q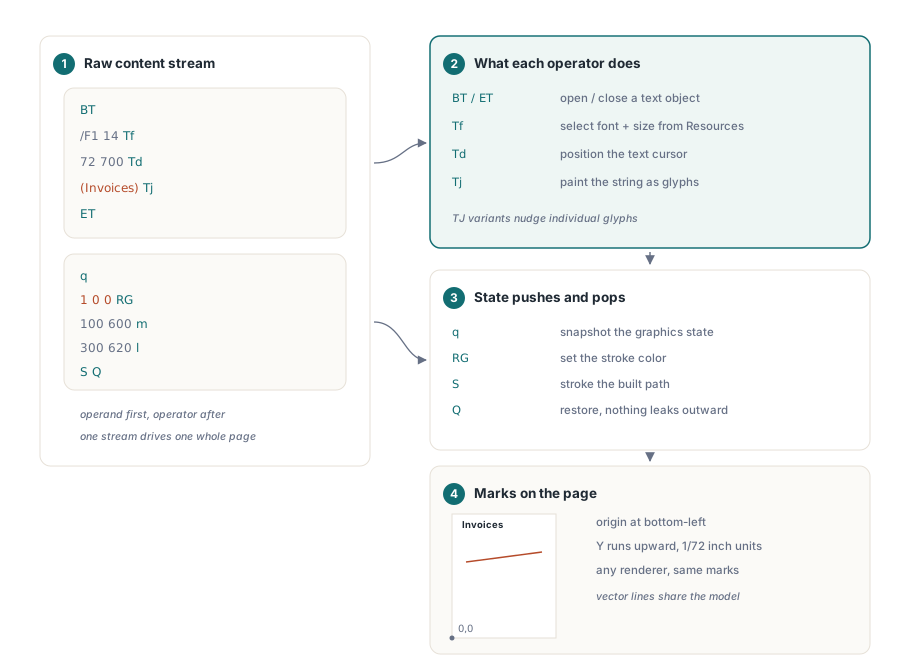
Nazwy typu /F1 to klucze do /Resources strony. Słownik fontu prowadzi przez swój deskryptor fontu (§9.8) do osadzonego programu fontu, a obraz jest malowany jednym Do, gdy jego dane JPEG albo Flate zostaną zdekodowane. Rasteryzacja przychodzi ostatnia. Renderer aplikuje macierz transformacji do każdej ścieżki i konturu glifa, mapuje punkty na piksele urządzenia i wypełnia wynik z antyaliasingiem. Ponieważ strona jest w tym punkcie nadal danymi wektorowymi, zoom do 400 procent przepuszcza strumień zawartości ponownie w większej skali zamiast rozciągać bitmapę. Rozdzielczość docelową wybiera wywołujący: 96 albo 150 pikseli na cal dla ekranu, 300 i więcej dla druku. W PDFium Component tym etapem jest TPdf.RenderPage, który bierze rozmiar wyjścia w pikselach
uses
  System.SysUtils, Vcl.Graphics, PDFium;

// Renderuje stronę 1 FileName przy Dpi pikseli na cal i zapisuje jako BMP
procedure RenderFirstPage(const FileName: string; Dpi: Integer);
var
  Pdf: TPdf;
  Bmp: TBitmap;
  W, H: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.Create('Cannot open ' + FileName);
    Pdf.PageNumber := 1;        // liczone od 1
    // PageWidth i PageHeight są w punktach (1/72 cala)
    W := Round(Pdf.PageWidth * Dpi / 72);
    H := Round(Pdf.PageHeight * Dpi / 72);
    Bmp := Pdf.RenderPage(0, 0, W, H, ro0, [reAnnotations]);
    try
      Bmp.SaveToFile(ChangeFileExt(FileName, '-p1.bmp'));
    finally
      Bmp.Free;                 // forma funkcyjna zwraca nową bitmapę
    end;
  finally
    Pdf.Free;
  end;
end;
Czemu kopiuj-wklej zwraca śmieci, skoro strona wygląda dobrze?
Kopiuj-wklej zawodzi, gdy plik rejestruje, który glif narysować, ale nie który znak on przedstawia. Renderowanie potrzebuje tylko kształtów glifów z osadzonego programu fontu. Ekstrakcja potrzebuje Unicode, który przychodzi ze standardowego kodowania albo mapy /ToUnicode na słowniku fontu (§9.10.3). Font złożony z /Encoding /Identity-H zapisuje surowe identyfikatory glifów wprost do strumienia zawartości, a bez mapy ToUnicode te identyfikatory nie mają zdefiniowanego związku z żadnym znakiem. Ekran wygląda perfekcyjnie, podczas gdy schowek napełnia się symbolami. Fonty podzbioru robią to bardziej prawdopodobnym, bo trzymają tylko glify, których dokument używa, i łatwo je spotkać po sześcioliterowym prefiksie w nazwach typu /BaseFont /AAAAAA+ArialMT (§9.6.4). Przewodnik po obsłudze fontów PDF schodzi głęboko w fonty CJK i zepsutą ekstrakcję
Aktualizacje przyrostowe i zakres bajtów podpisu
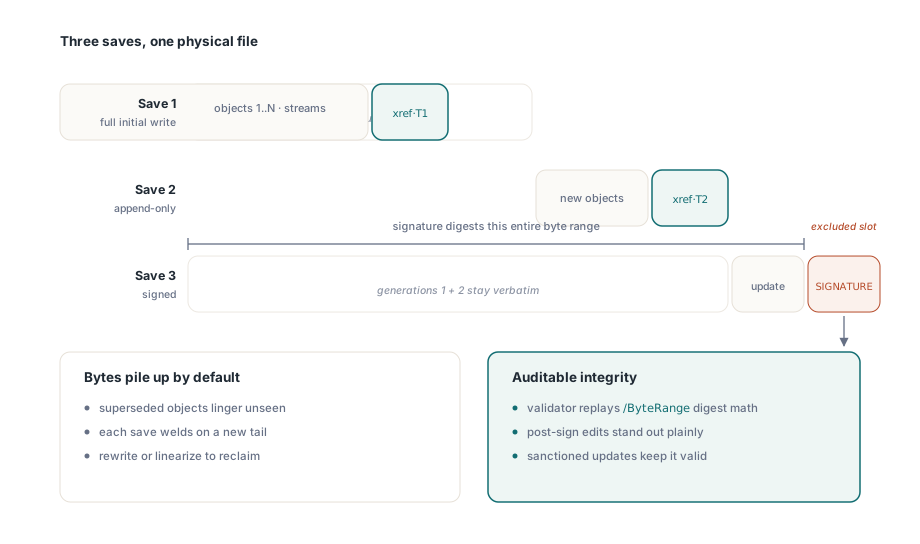
Podpisy polegają na sposobie edycji PDF-ów tylko-dopisuj: aktualizacja przyrostowa (§7.5.6) dodaje obiekty i nową sekcję odsyłaczy po ostatnim %%EOF, a przegląd struktury omawia łańcuch /Prev i czemu usunięta zawartość przetrwa we wcześniejszych rewizjach. /ByteRange słownika podpisu, zapisywane jako [0 a b c], haszuje wszystko poza szesnastkowym stringiem /Contents, w którym siedzi podpis CMS, więc podpisana rewizja kończy się przy bajcie b + c, a walidator odbudowuje ją ucinając plik w tym miejscu. Późniejsze rewizje lądują za tym punktem, podczas gdy pełne przepisanie, linearizator albo krok optymalizacji rusza bajty zhaszowane przez podpisującego i unieważnia wszystkie istniejące podpisy naraz
Kiedy aplikacja Delphi albo Lazarus potrzebuje całego tego potoku, od parsowania danych odsyłaczy i przechodzenia drzewa stron po renderowanie i ekstrakcję tekstu, PDFium Component dla Delphi i Lazarus opakowuje go w komponent dokumentu TPdf używany w listingach wyżej i kontrolkę przeglądarki TPdfView do wyświetlania na ekranie